




今天这部分还是延续上次的内容,包含的内容是File Header,Page Header,File Trailer部分,以及结合上篇的学习和本篇的学习对数据页做一个归纳。
File Header记录了页的一些通用消息,各种类型的页都会有该部分,共38个字节,如下:
fil_page_space_or_checksum:4字节,页的检验和,即checksum值,通过某种算法计算一个较短的值来代替一个很长的字符串,在进行两个长字符串对比时,先对比检验和,如果校验和不一样,则说明两个长字符串不一致,如果进行后续对比,提高性能。
fil_page_offset:4字节,页号,通过页号可以定义到一个唯一的页。
fil_page_prev:4字节,上一个页的页号。
fil_page_next:4字节,下一个页的页号。
fil_page_lsn:8字节,页面最后修改时对应的日志序列位置,lsn全称为log sequence number。
file_page_type:2字节,页的类型,innodb中根据功能可以将类分为很多页,数据页,系统页,undo日志页。段信息节点页。
fil_page_file_flush_lsn:8字节,只在系统表空间的一个页中定义,表示文件至少被刷新到来对应的lsn值。
fil_page_arch_log_no_or_space_id:4节字,页所属的表空间。在独立表空间中,不同的表会被分配不同的表空间,访问某一张表时,可通过该字段定位到对应的表记录所在的数据页。

Page Header的作用是记录数据页中存储的记录的状态信息,是专门针对数据页的,其他类型页没有,共56个字节,如下:
page_n_dir_slots:2字节,记录页目录中的槽(slot)数量
page_heap_top:2字节,指向本页中未使用的空间,即free space的最小地址。
page_n_heap:2字节,本页中的记录的数量,包含最小记录和最大记录以及标记为删除的记录。
page_free:2字节,数据页中,各个删除的记录通过next_record组成一个单链表,这里指向单链表的表头,即第一个已经被标记为删除的记录地址。
page_garbage:2字节,本页中已经删除的记录占用的字节数。
page_last_insert:指向最后插入的记录的位置。
page_direction:记录新插入的记录相对上一条插入记录的位置,如果主键值大于上一条记录,则插入方向为右,反之为左。
page_n_direction:2字节,记录一个方向连续插入的记录数量,如果后续记录的插入方向改变,该值会被置零重新统计。
page_n_recs:2字节,本页中的记录的数量,不包含最小记录和最大记录以及标记为删除的记录。
page_max_trx_id:8字节,修改当前页的最大事务id,只在二级索引中定义。
page_level:8字节,当前页在B+数中所处的层级。
page_index_id:8字节,表示当前页属于哪个索引。
page_btr_seg_leaf:10字节,B+树叶子段的头部信息,记录着叶子节点段对应的inode entry结构的地址对应的表空间的对应页面的偏移量。只在B+树的root页中定义。
page_btr_seg_top:10字节,B+树非叶子段的头部信息,叶子节点段对应的inode entry结构的地址对应的表空间的对应页面的偏移量。只在B+树的root页定义。
有了前面部分的学习,这些字段大部分是不难理解的,对于page_btr_seg_leaf,page_btr_seg_top这两个字段感觉后面还需要探究一下,毕竟学习不是一次就能成功的。


通过上篇和这篇的学习,对数据页的整体形态应该都有了一个明确的认知。来梳理下通过数据页的这些设计都实现了啥。
自己梳理了下,可能不全面,后期再不断完善吧,如下:
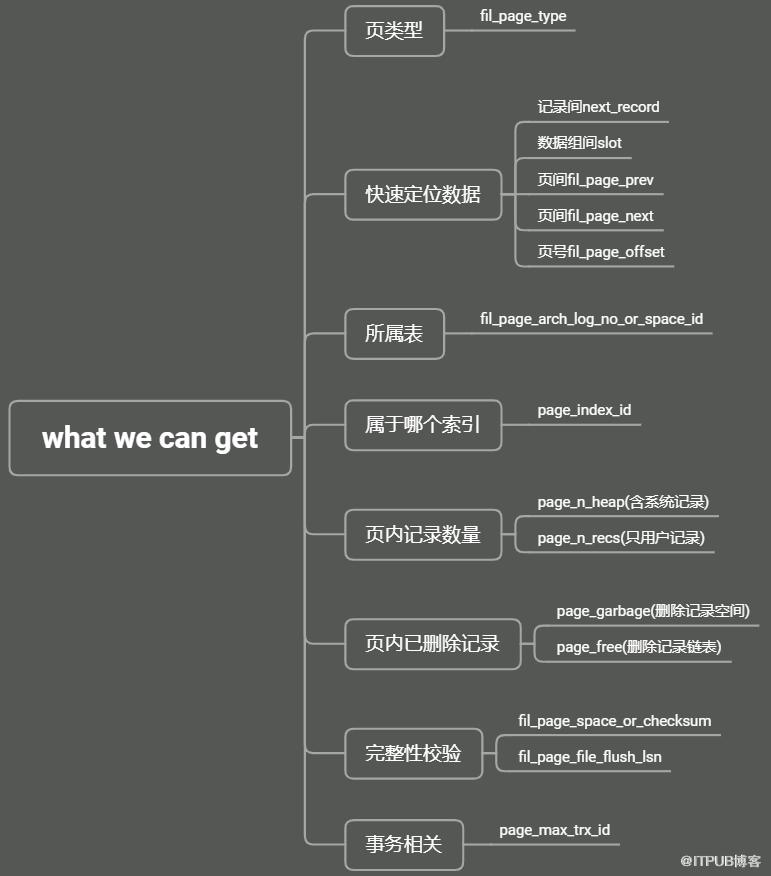
对上面快速查询补充一下,在数据页之间,每个数据页的File Header部分的file_page_prev字段使得不同数据页之间可以形成双向链表。在数据页中,又可分为槽级别和组级别,可以通过二分法确定记录所在的槽,确定槽后可定位到组内记录,记录之间通过next_record属性形成单链表,每个组内最多只有八条记录,即使遍历也是很快的。
在linux下,mysql默认是区分大小写的,如果业务场景中需要设置不区分大小写,在配置文件的[mysqld]中添加lower_case_table_names参数,设置该值为0时表示区分大小写,设置为1时表示不区分大小写,然后重启数据库服务。
最近遇到一个场景,记录一下以便后面温故,默认情况下mysql对于查询结果是不区分大小写的。可以通过两种方式进行修改:
第一种,修改sql:
select * from xxx where binary name ='zhangshan';
第二种,修改表结构:
alter table xxx modify name char(20) character set utf8 collate utf8_bin default null;
设置为utf8_bin级别会根据二进制进行对比,当然也可以从服务器或者库级别修改,但是如果字段级别的未修改,仍然会被覆盖。
不同数据页之间虽然可以通过双向链表实现快速访问,但是如果数据页很多的话,而又不能快速定位记录的话,遍历双向链表会很浪费时间,因此可通过多层节点实现快速查找,就类似于slot槽位和组内记录一样,对应的就是B+树,最后一层是叶子节点,存储数据,其他是非叶子节点,存储目录项。这一块对应的就是索引相关的知识点。

这两篇对数据页的相关信息做了一些总结记录,了解数据页存储了哪些信息,做了哪些设计。当然,除了数据页,还有很多的数据库知识等着我们去探索,数据页的篇章暂告一段落,下一篇将会开启新的模块的学习。

END


原文作者:DBA修行之路;如有侵权,请联系管理员删除。

