CAP过时论
Martin Kleppmann在2015年撰文对CAP进行了较为深入、细致的分析,对一些概念作了比较,甚至对Eric Brewer和Seth Gilbert、Nancy Lynch论述的内容的差异进行了比较,指出现有的分布式系统的研究基本上是集中在20世纪90年代,过时已久[1];并建议CAP归入历史不再被用于指导分布式系统的设计。而分布式系统的设计和时延/延迟有关,可以证明的是:在不使操作延迟(operation latency)与网络延迟(network delay)成比例的情况下,某些级别的一致性是不可能实现的。
Martin Kleppmann认为对于分布式系统研究未来可开展的工作,研究的热点是:
对不同的并发控制和复制算法的延迟的概率分布(the probability distribution of latencies)建模。
-
对更明确的分布式算法的网络通信拓扑(the network communication topology of distributed algorithms)建模。
最后,作者期望更严格地讨论不同的一致性层次对性能和容错性的影响;期望通过采用简单、正确和直观的术语,可以帮助指导应用程序开发人员使用最适合其场景的(存储)技术[2]。
具体内容不再陈述,请参考原文。
PACELC理论和CAP新进展
在广域网(WAN)网络环境中,网络的不可靠性大,同时满足CA是低概率事件。在现代的可靠的局域网网络环境中,分区事件是较少发生的,因此分布式系统满足CA是一个高概率事件。在这种条件下,更多值得讨论的不再是分区事件发生,而是分区事件没有发生的情况下,操作从开始到得到结果,中间过程花费的时延的问题,即延迟(Latency)。而假定某一定量的时延是不允许的情况下,分区事件即可被时延问题替代。
Daniel J. Abadi针对分布式数据库提出“PACELC”替代CAP,其含义是:
如果发生分区事件(P),如何在可用性(A)和一致性(C)间选择?
-
否则(Else)即不发生分区事件,如何延迟(L)和一致性(C)间选择?
PACELC理论实质是讨论了两种情况,上述第一种情况讨论了CAP理论,第二种情况讨论了无分区发生时因延迟带来的新的挑战。但如果延迟的时间较长,延迟的现象类似于分区发生,处理延迟所面临的问题,可能同样困难。
Daniel J. Abadi尽管提出了PACELC理论,但没有给出适宜的解决办法[3],也没有明确给出一致性的定义、没有分析一致性、可用性之间的关系。其理论的价值在于“全面”地提出了分布式数据库所面临的问题,这些问题需要更深入地细化和讨论。
2017年Eric Brewer发表文献《Spanner, TrueTime and the CAP Theorem》,结合被认为同时实现了一致性和可用性的Spanner系统再一次讨论了CAP,指出:CAP 定理关注的是100%可用性,而该文献是关于现实的高可用性涉及的权衡(高可用但不是100%可用,分区依旧可能发生)。Spanner尽管有着很高的可用性(大于5个9的可用性,Spanner运行中断时间每年少于5.9秒),但是一旦分区事件发生,Spanner依旧遵循CAP选择了C放弃了A。
所以,从工程实践的角度看,实现尽可能高的可用性是分布式系统的目标,但对于不同的应用系统,在一致性和可用性选取上因系统而异。分布式数据库系统,通常选择C一致性而放弃100%的可用性,但分布式数据库系统的研发者则需要100%的处理分区事件以提高系统的健壮性。
所以,目前的研究结果表明:CAP/PACELC理论依旧适用于分布式数据库系统。
这是一个非常重要的结论,需要特别注意。可是,聪明的你,“可否读懂得了其价值与含义?可否会把他们应用到实践中?”
看不懂的CAP
很多人在说CAP,但非常不幸,把CAP理解掌握直至能应用的却极其稀少。少到了一种令人“发指”的地步。
举一个例子,尽管该例子可笑到令人“发指”继而“目瞪口呆不能再言”的地步。但是,该示例暴露了对CAP等技术的理解程度、把控能力(这种现象“似乎”在业界很常见)。如下蓝色字体是作者所加。
某互联网新贵ZJ,意欲发力数据库,因此招了一大批数据库研发人员,窃HW之果实现了类Aurora的共享存储式MySQL。一日,该司讨论分布式数据库的发展方向,某Leader(简称为ZL)提出:我们要做廉价的、类Spanner的分布式数据库系统。——分布式数据库架构,首先定位在非特定硬件环境下,符合互联网的需求与环境,赞之。
紧接着ZL再提出:分布式数据库的方向,应该大力发展高可用性,我们需要“极致的高可用”。——非常赞,这是一个对用户非常有价值的技术方向,尤其互联网应用7*24小时不间断,数据库的高可用性是确保业务持续可用的重要特性。作为Leader具有技术方向感知,很赞。可是,“极致高可用”莫非是指类似——OceanBase采用无共享的多副本架构,系统没有单点障碍,保证系统持续可用;且支持两地三中心和三地五中心部署,可保障数据的城市级容灾——这样的高可用?
技术人问之:极致高可用是什么含义?是需要在CAP指导下对原型进行设计不?
ZL回之:不用,采取Oracle的RAC架构,即可实现“极致的高可用”(Leader信心满满言之凿凿);RAC集群提供了故障容错功能,当一个节点发生故障时,其他节点可以接管其工作,保证数据库的持续可用性(持续可用就是极致的高可用?)。——RAC架构之优劣,我们另外再论。但是集中在一个盒子内的分布式系统,其网络状态处于持续可用的状态,几乎不会发生网络分区事件的,因此CAP是发挥不了指导价值的,故所谓的高可用非CAP中的A。而RAC提供了较好的可用性是事实,但该可用性已经是“极致”的可用性,却待商榷;另外,在互联网环境下的数据库架构,或者说Spanner架构,是构建在廉价硬件基础上的,因此硬件出现故障的几率很大,即网络分区事件发生的概率较大,因此CAP才能起到指导作用。可以说,RAC和Spanner是两种环境下的不同架构选择。Leader采取嫁接手法,把两个体系的内容粘贴在一起,无脑关联却不知问题所在,实为悲催。
技术人提醒:数据库高可用,可以分为多个层级体系:一是系统高可用,二是节点高可用,三是事务高可用。极致的高可用需要在三个方面开展。
一 系统高可用,地域级的跨城高可用确保整个数据库系统和数据处于近乎实时的可用状态;
二 节点级的高可用,确保数据库内的某物理节点上的数据库服务处于高可用状态(尽可能短的切换时间,Serveless化);
ZL问:什么是事务级高可用?
技术人回答:第三个,用户感知的事务级高可用,在每个事务执行的层级,确保用户能感受到有高可用机制在,例如一个长的只读事务执行了报表分析,已经执行了三天,只差最后一分钟即可完成计算,此时,一个瞬时闪断发生,导致该事务被回滚,对于用户而言,是非常悲催的事情;用户对于此类应用,希望能够在闪断恢复后,事务继续执行而不至于前功尽弃。而我们的硬件环境是廉价的类PC的设备,以类Spanner方式构建分布式数据库是合适的,此时需要分层级考虑如上三种层次的可用性,再配合一些用户层面的可用性工作,方才能把可用性做到“极致”。——业界的高可用尚不成体系,未有成型的理论化表述,如尽管RAC等也有类似解决瞬时闪断下事务依旧可用的能力,但是其高可用性还不成体系化,未有把他们融合为一体加以考虑,还是各自为战的。而该有层级的高可用性,从宏观到微观,分层讨论高可用性,已经具备了完备的体系,如果能按此思路去建设可用性,亮点必然形成。
悲催的是,一知半解的ZL对此不以为然,ZL大手一摆:你们结合CAP,好好论证一下RAC方案的可行性。事务级高可用,我们就这么几个人,你觉得可做吗!?——CAP与RAC可谓是两个体系下的两种背景,可否被糅合在一起?!——Oracle、Spanner都已经具备了一定程度的事务高可用能力!——实施RAC不觉得的难度大耗费人力,做事务级高可用却认为个人不可做,飞跃天堑的神逻辑。
ZL发出指令,众人对其似懂非懂不谙世事发冲冠指发抖,之后数位技术人去努力论证去了。事后ZL日:你们说得我都知道,能不能有点新意?!
悲乎,CAP;悲乎分布式数据库,悲乎Spanner和RAC。示例是一种局部现状,但这种现状也不在少数,而个别公司确有真领军人坐镇,我们将逐渐可以看到各家的差距凸显(除非换将)。时间滴答滴答,很快就溜走了,让我们拭目以待各家风起云涌。
回到正题,CAP问世已经20余年,已经被大家广为认可,可是,除了NoSQL一波高唱CAP战歌迅猛前进后,事务型数据库是否跟上了其前行步伐?此后二十年,期待当正是CAP真正与事务型数据库全面结合之时,让CAP真正帮助事务型分布式数据库走向第三个时代!
再谈高可用——CAP的精髓
CAP中的核心问题,是在分区事件发生的情况下,只能选择保证一致性或可用性而牺牲对方。
CAP的C一致性是一个非常重要、且非常复杂的问题,例如在《第三代分布式数据库(4)——为什么要100%保证数据的正确性?(上)》中我们提出一致性乱象的“一致性24字问题”(范围不清、定义不明、多意多词、理论有缺、扩展无法、系统难评)。对于C,未来我们放到《第三代分布式数据库》系列中再行讨论。
1 高可用体系
现在先集中讨论A。
前述ZJ数据库首席架构师提出:数据库高可用,可以分为多个层级体系:一是地域级的跨城高可用确保整个数据库系统和数据处于近乎实时的可用状态;二是节点级的高可用,确保数据库内的某物理节点上的数据库服务处于高可用状态(尽可能短的切换时间,Serveless化);三是用户感知的事务级高可用。概括一下,这三种高可用,分别是系统级高可用、节点级高可用、事务级高可用。
系统级高可用、节点级高可用、事务级高可用这三种,不全是与CAP有关联。例如,系统级高可用依赖于Paxos/Raft类的共识协议来确保,节点级高可用依赖于共识协议和Serverless的思路来确保,而事务级高可用,则更多的是依赖CAP。
但是,如上所述,也只是表面现象,为深入理解CAP,让我们来结合Paxos/Raft等共识协议和CAP来一起看看,他们之间,有什么关系不?
共识协议,考虑的是某种角色出现故障时,如何做高效且保障多副本数据的一致性。其中,故障是什么呢?Leader失效重选、follower应答不能感知、更甚者物理节点出现故障等,其实都可以视为是CAP中的P发生,是不?!而共识协议需要处理的故障背后都可映射为网络分区事件,因此CAP提出CA不能共存的原则,共识协议提出具体的解法,二者相辅相成,放在一起才能完美解决问题。因此高可用的本质问题还是CAP问题,因此CAP的前提是P为条件,因此和RAC的昂贵的、可靠网络在环境的假设背景是完全不同的,因此CAP和RAC不能融合。
但可以考虑的是,在廉价硬、不可靠硬件环境下,我们可以借用RAC的数据分布和数据迁移的思想,来构造新一代分布式数据库系统。而在新一代的分布式数据库系统中,数据自动迁移这样的思路,还可以参考论文《Highly available transactions:Virtues and limitations》,其核心思想,是从代价计算的角度如何让尽量让代价大的分布式事务被有效消除(这个问题又涉及了《第三代分布式数据库》系列中提出的“100%确保数据正确性的同时最大化并发性能”的话题,欢迎感兴趣的同学来讨论)。
2 事务级高可用
在共识协议技术日渐成熟的背景下,数据库跨城容灾和节点级容灾,基本上已经不是什么大的不可克服的问题。
因此未来的一个阶段,热点技术之一必然会迁移到事务级高可用上。因为:
这对用户的应用是非常有帮助的。其需求来自用户的实际应用,用户需要从事务的角度来控制可用性,事务是用户可唯一操控的抓手,如果不把这个抓手交给用户,而是剥夺用户享有该主权,则用户的应用会非常难受非常不可控,因此用户必然要对事务的高可用和一致性提出权利主张。
-
从技术的角度看,这是分布式环境下事务型数据库发展的必然。因为事务级的高可用,不仅涉及了数据的系统的容错性,还关系到数据的正确性(事务并发下的无异常的正确性和多副本下的副本强一致性、以及混合了隔离级别的高可用事务的正确性、以及我们在第三代分布式数据库中提及的隔离级别无用的情况下数据的正确性等)。已经存在的分布式数据库,在目前网络较为可靠的背景下,未经历大规模的、具有丰富场景的可用性验证,使得问题未充分暴露,造成一种现有的分布式数据库尚堪堪可用的假象。换句话说,第2代分布式数据库未经过充分的风险验证、未有完备的风险控制、没有完备的风控能力。一旦将来陷于网络环境较大幅度出现分区事件,充分潜在风险的分布式数据库必然会瘫痪下线。比如,战争状态下的军事系统、金融系统如果底层建设在第2代分布式数据库上,则充满风险。在这种状态下,异地容灾等不能完全解决问题,该方式也只是和平时期的脆弱应对之道。构建一个在细胞层级即充满可用能力,又能保证数据一致性的数据库系统以备不时之需,也许是未来可以或应该考虑的。退5000步,即使不考虑极端状态下的数据库系统应该如何构建,而建设一个更加健壮、可用性更好的数据库系统,相比现在在和平年代、集中式思维下的建立起的初代级分布式数据库而言,也是必要的。
这时,需要我们深入思考的是,如何实现事务级高可用?这就需要有一个大的原则来指引我们做好数据库内核引擎的设计工作,这个原则早已出现,其就是CAP。可是CAP还是太抽象了,不能够细微指导工程实现。此时,需要从两个方面来把控该事项:
1. 可控时延下的高可用:读过《第三代分布式数据库》系列的同学可能熟悉这个词,看到这个词,就会想到该词是第三代分布式数据库的核心特征之一(参见《第三代分布式数据库(2)——创新之源》)。可控时延下的高可用其实是对CAP换了一种背景讨论一致性和可用性的关系,因为事务级高可用已经事务异常展开讨论,故必然要涉及一致性相关内容。特大话题,未来另文探讨。
2. 特定一致性的高可用:一致性有很多(包括CAP和ACID两个体系下的各种C,如下图6所示),哪些一致性可以做到高可用?哪些一致性不能做到高可用?这是需要深入到细节中逐一加以探讨的,不然系统的正确性和容错性不能做正确。这是一个艰难的工作,因为一致性的概念人类尚不清晰,要结合各种一致性进行可用性的讨论必然是一件前无古人的事情。所幸的是,虽然没有讨论清楚(干脆是没有讨论)CAP和ACID两个体系下的各种C的关系,但是前人还是做了一些工作,在Peter Bailis等的论文《Highly available transactions: Virtues and limitations》中分别对ACID的C和高可用的关系、以及CAP的C和高可用的关系进行了分类探讨,这给我们提供了一种可以借鉴的路径。
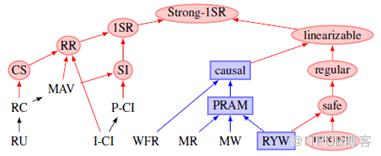
图6 分布式一致性和事务一致性之间的关系图
如上问题,在理论层面尚未探讨清楚,所以在现实的各种分布式数据库中,尚未有相应的实现,也鲜有人提及该类问题。
而该问题又是如此重要(分布式环境下必然要有一致性权衡和故障解决的问题),各家分布式数据库却又不提及该类问题,大家猜一猜,是不知问题存在还是各厂商都已经做好了?猜者言之有理能给出丰富论述的,赠送签名版如下书籍一本哈。
宏观的角度看,在一个分布式系统中,一致性和高可用性,如同一个硬币的正反面,谁也离不开谁。这点是业界严重缺乏认知的。这对事务级高可用提出了挑战。
3 高可用事务
Peter Bailis等在总结了分布式体系下各种一致性(包括分布式一致性和事务一致性、事务的隔离级别)和高可用性(High availability)之间的关系,如图7所示,并分析了单调读、单调写、因果一致性等分布式一致性特性。他们还依据图7进一步画出了图6,并基于transactional availability(事务可用性)和sticky transactional availability(粘性事务可用性)提出Highly Available Transactions(高可用事务,简称HAT)的概念,以刻画网络存在分区和延时情况下,事务与可用性的关系。他们认为强一致性是不可与100%的可用性兼得的。这表明CAP是正确的。
该问提出的事务与可用性相结合的概念如下:
粘性可用性:从用户的角度看整个系统的可用性和事务之间的关系,在用户可容忍的时间内(可以设置超时检测),即使发生了分区或较长时延,用户依旧能够得到一个反馈,这样的可用性,称为“粘性可用性”。
事务可用性:从事务的角度看带有多个副本的事务型数据库系统和可用性的关系,在用户可容忍的时间内(可以设置超时检测),即使发生了分区或较长时延,事务能够被提交或回滚,这样的可用性,称为“事务可用性”。
粘性事务可用性:这个概念合并了从用户角度和事务角度看待可用性的语义。
-
高可用事务:只要系统满足HAT的要求,则就能确保系统一定是高可用的且是事务的。因此HAT是衡量一个分布式系统满足高可用性、分布式一致性和事务特性的一个指标。
该文从ACID的隔离性、原子性、持久性的角度,分为两种情况探讨了与HAT的关系,一是能够保证HAT语义的情况,二是不能保证HAT语义的情况。
对于隔离级别,能够保证HAT语义的,包括读未提交(Read Uncommitted)、读已提交(Read Committed)两种隔离级别,这是因为这两种种隔离级别在分区或较长时延的情况下,多副本的分布式事务能够保证读操作(两种隔离级别的场景都是先写后读的并发)被正确满足。而可重复读(Repeatable Read)、快照隔离(Snapshot Isolation)、单拷贝可串行化(one-copy serializability)隔离级别因在分区或较长时延的情况下,多副本的分布式事务不能够保证写操作,即不能使丢失更新(Lost Update)、写偏序(Write Skew)这样带有先读后写的操作被正确满足(需要满足写过半原则:写操作需要半数以上的副本成功才可以成功,但分区等发生,写过半原则不能一定被保证,需要看分区发生后最大的一个分区的副本数是否过半数,且要看此分区是否满足“粘性可用性”即与客户端是否连通)。特殊的是可重复读(Repeatable Read)隔离级别,其定义是模糊的,细化各种情况后得到的cut isolation(切割隔离)、Item Cut Isolation(项目切割隔离)、Predicate Cut-Isolation(谓词切割隔离)隔离级别是可以满足HAT的。
该文考虑了原子性与HAT的关系:在分布式系统中,原子性影响了写操作结果对其他事务的可见性,这可以视为一种“隔离”,因此“原子性是具有隔离性的”,称之为Monotonic Atomic View Isolation(单调原子视图隔离,简称MAV隔离),用以防止读偏序(Read Skew)异常。在MAV隔离中,事务Ti能影响到的部分数据如果能被事务Tj可见,则Ti能影响到的所有数据都能被事务Tj可见。即事务Tj读取到事务Ti所写的数据(Ti能影响到的数据),则事务Tj再次读取事务Ti所写的数据不会有更新的值(即所读到的就是最新值)。
该文考虑了持久性(Durability)与HAT的关系,为持久性在分布式环境下赋予了新的含义:从用户端看,事务提交前要保证持久性就必须在有F个副本失效时至少还有F+1个副本可用(即半数写原则的要求)。
该文从分布式一致性的角度(包括了会话一致性如因果一致性等),讨论了与HAT的关系,并对于比上述提到的更多的各种隔离级别、分布式一致性,是否满足HAT,进行了总结,如图7所示。然后又把事务和分布式一致性建立关联,得到图6。
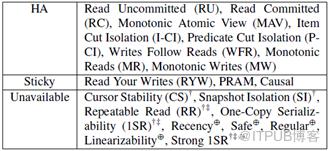
图7 不同隔离级别/一致性与高可用性之间的关系图
再聊-第三代分布式数据库
1 网友讨论
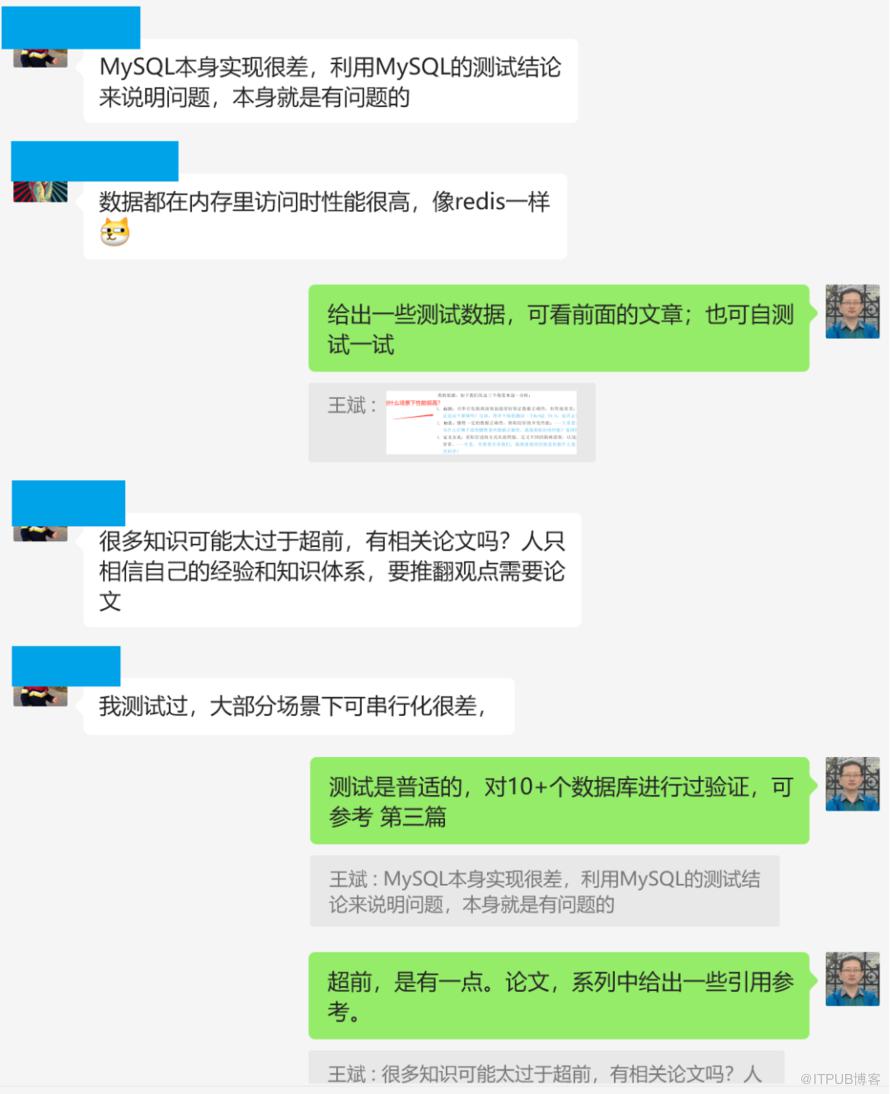
《第三代分布式数据库》系列发文后,触发了一些读者的感想:
有担心文章被人断文取义的,有热情如火的推荐论文的,有耿直提出软件学报份量不够的,有仗义指出发展方向的,各种各样,不一而足。
非常感谢大家的慷慨直言谆谆教导哈,非常感谢。摘取一些,聊表谢意。
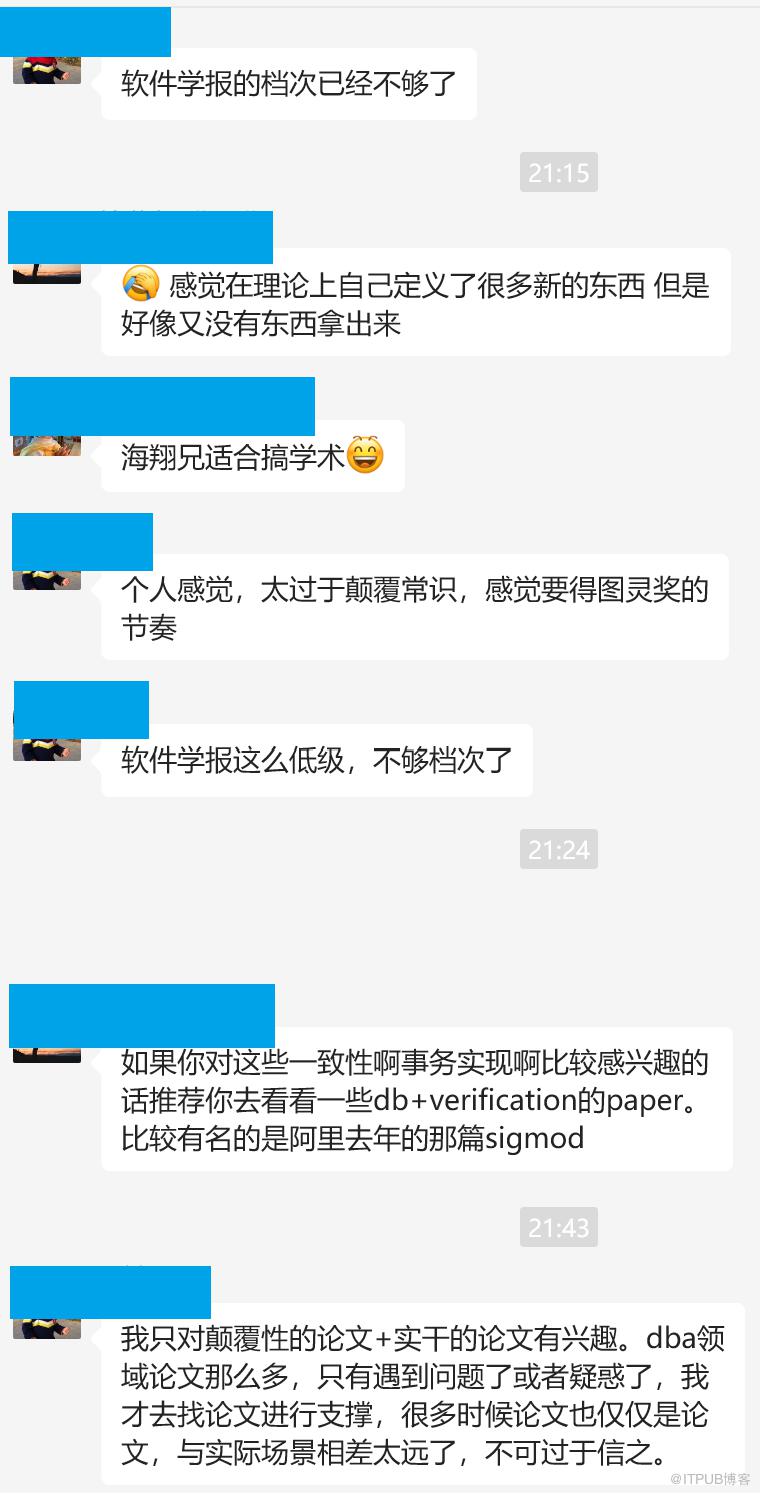
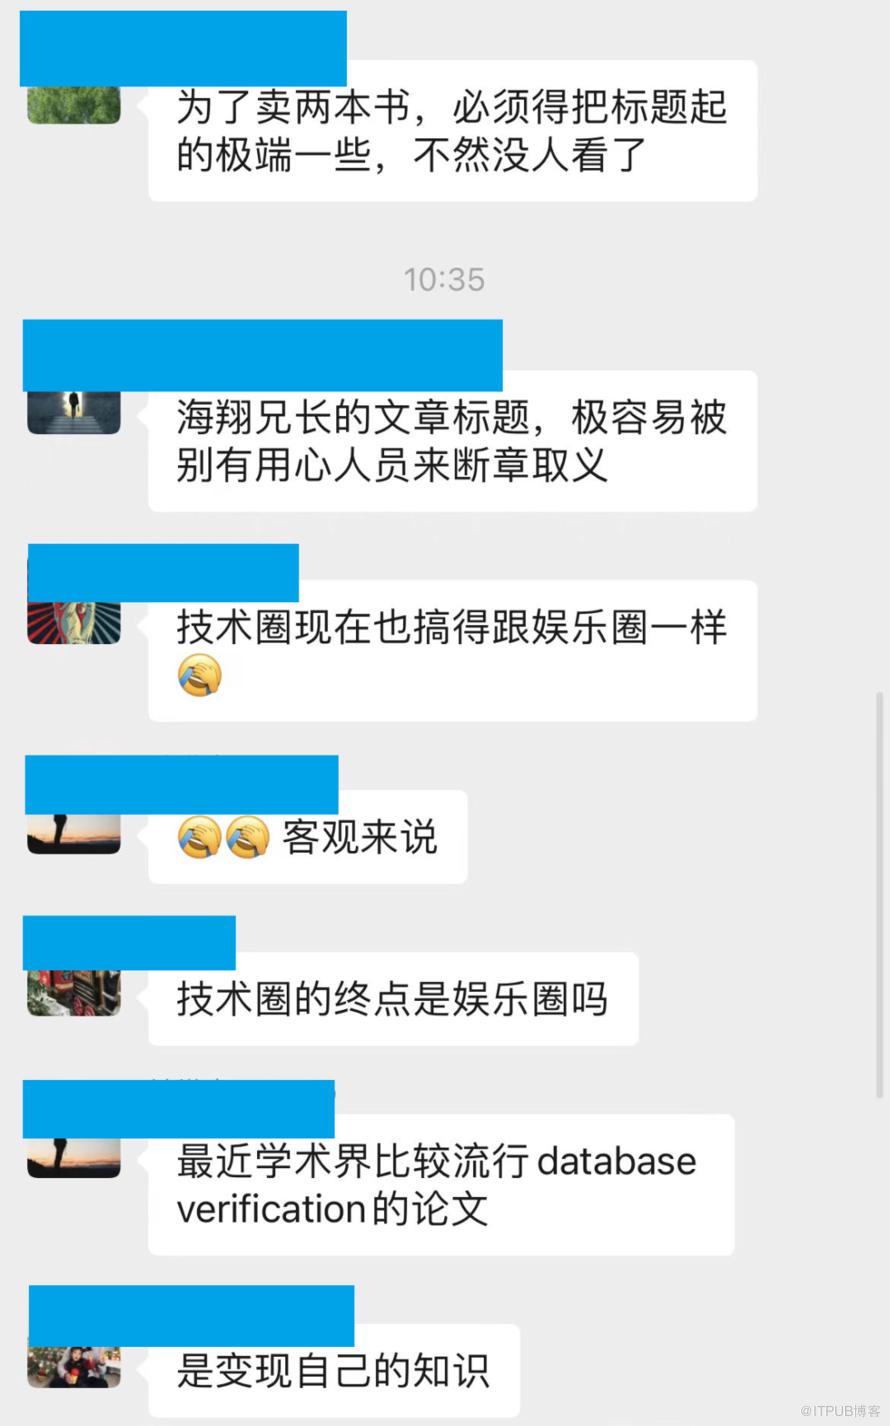
看待问题,要有纵深。这可能是一种基本方式和态度。这是《第三代分布式数据库》系列的出发点,当构筑一个新体系的时候,是只为新世界而欢呼还是言明旧体系的不足?是构造自己的理想世界还是从实用的角度出发解决现实问题?《第三代分布式数据库(1)——踢球时代》,该系列的首篇文章,则把旧体系的问题提了出来,科学研究始于问题。
看待文章,辩文析理。这可能是一种基本方法和手段。基于现实问题,《第三代分布式数据库(2)——创新之源)》提出创新的若干思路,并提出新一代的可选的三个特征,聊供顺理辨析。
后续再下沉到具体的特征点上,如给出了一致性八仙图(《第三代分布式数据库(3)——一致性八仙图》),用以支持三个特征之一的观点。再后续继续析理并有新观点提出,陆续有了《第三代分布式数据库(4)——为什么要100%保证数据的正确性?(上)》、《第三代分布式数据库(4)——为什么要100%保证数据的正确性?(下)》等,还请从行文层次出“辩理”。
这2篇发出后,原本有个小小的期待,期待有同学来质疑说“你这个道理没有讲透彻啊——究竟为啥是“分布式数据库需要100%保证数据的正确性”?”(因为确实是留了一个关子的,不过是不得已为之,技术原因,此时完全展开非常不容易讲明白(恕在下才思不继,不能简单明了表明答案)且会让读者更听不明白,后续会补上(包括本《分布式原理》系列也是在补作业,为后续知识做铺垫,哎,也挺辛苦的哈,时不时要敲数万字出来,手要抽筋了哎),所补的可能又是数万字的冗文,敬请谅解哈)。等待中落了一个寂寞,有点可惜。不过还是等待来了“老师”的惊喜,有道是:
沉舟侧畔千帆过,病树前头万木春。今日听君歌一曲,暂凭杯酒长精神。
有讨论进来了,无酒但也长精神,终于有对这两篇内容的讨论了,如下:

2 小结
非常感谢各位老师的指正!感谢各位网友的鞭策!
用如下作结,辨析的过程中析理认理更重要哈!
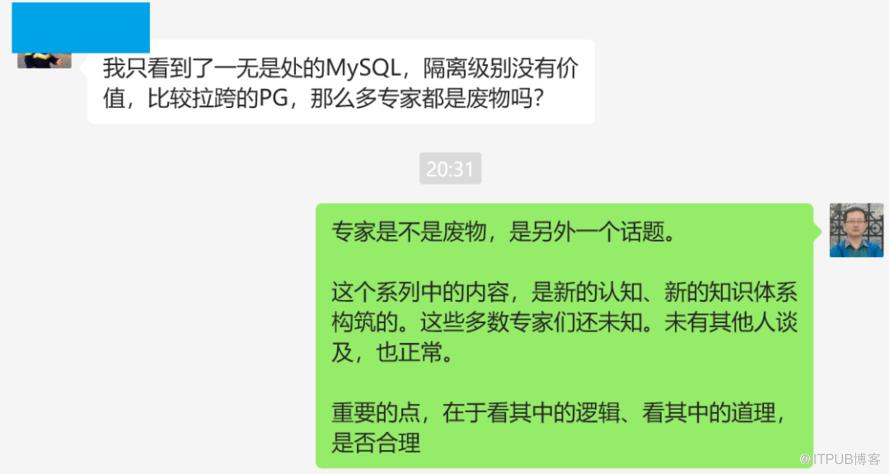
其中有真意,欲辨已忘言...
脚注的参考:
[1] 原文:We have not proved any new results in this paper, but merely drawn on existing distributed systems research dating mostly from the 1990s (and thus predating CAP).
[2] 原文:描述的是the storage technologies,但在分布式系统中,只是单纯地理解为讨论的是数据的存储有些狭隘,理解为“提供存储和计算的分布式系统”更妥。
[3] 原文:The tradeoffs involved in building distributed database systems are complex, and neither CAP nor PACELC can explain them all. Nonetheless, incorporating the consistency/latency tradeoff into modern DDBS design considerations is important enough to warrant bringing the tradeoff closer to the forefront of architectural discussions.

-
如下三篇,最好合在一起读,有对比才有鉴别。
2. 第三代分布式数据库(5)——一无是处的MySQL
4. 第三代分布式数据库(7)——比较拉胯的PostgreSQL

扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

