往期回顾:
左右SQL执行计划妙招 ③ ——执行计划SQL写法差异改变【with子句】
左右SQL执行计划妙招 ④ ——执行计划SQL写法差异改变【insert all】
左右SQL执行计划妙招 ⑤ ——执行计划利用设计特性改变【并行度影响】
左右SQL执行计划妙招 ⑥ ——执行计划SQL写法差异改变【rownum分页】
左右SQL执行计划妙招 ⑦——执行计划SQL写法差异改变【rownum实体】
左右SQL执行计划妙招 ⑧ ——执行计划SQL写法差异改变【rowid 的影响】
左右SQL执行计划妙招 ⑧ ——执行计划SQL写法差异改变【rowid 的影响】
左右SQL执行计划妙招 ⑨ ——执行计划SQL写法差异改变【缓存结果影响】
左右SQL执行计划妙招 ⑩ ——执行计划SQL写法差异改变【分区条件有无】
左右SQL执行计划妙招⑪ ——执行计划利用设计特性改变【分区设计影响】
左右SQL执行计划妙招 ⑫ ——执行计划利用设计特性改变【Cluster类型】
左右SQL执行计划妙招 ⑬ ——执行计划利用设计特性改变【Iot表类型句】
左右SQL执行计划妙招 ⑭ ——执行计划利用设计特性改变【物化视图影响】
左右SQL执行计划妙招 ⑮ ——执行计划利用设计特性改变【列空值影响】
左右SQL执行计划妙招 ⑯ ——执行计划利用设计特性改变【主外键影响】
左右SQL执行计划妙招 ⑰ ——执行计划改变之其他相关手段1_set_table_stats
在生产环境中建立索引是一项重要决策,虚拟索引技术让我们能够在不实际创建索引的情况下预估其对执行计划的影响。本文作为《左右SQL执行计划妙招》系列第十八篇,展示如何利用虚拟索引评估索引建立的必要性和效果。
场景背景:索引建立的决策困境
无索引的执行计划
drop table t purge;
create table t as select * from dba_objects;
set linesize 300
explain plan for select * from t where object_id=1;
select * from table(dbms_xplan.display());
执行计划:
PLAN_TABLE_OUTPUT
--------------------------------------------------------------------------
Plan hash value: 1601196873
--------------------------------------------------------------------------
| Id  | Operation         | Name | Rows  | Bytes | Cost (%CPU)| Time     |
--------------------------------------------------------------------------
|   0 | SELECT STATEMENT  |      |    19 |  3933 |   307   (1)| 00:00:04 |
|*  1 |  TABLE ACCESS FULL| T    |    19 |  3933 |   307   (1)| 00:00:04 |
--------------------------------------------------------------------------
Predicate Information (identified by operation id):
--------------------------------------------------------------------------
   1 - filter("OBJECT_ID"=1)
Note
----
   - dynamic sampling used for this statement
索引建立的顾虑
决策难题:
- Oracle会选择使用新建的索引吗?
- 索引使用后成本会真正降低吗?
- 索引建立耗时耗力,效果不好怎么办?
- 如何在建立前评估索引的价值?
虚拟索引:零成本的效果预估
虚拟索引的创建和测试
drop table t purge;
create table t as select * from dba_objects;
-- 启用虚拟索引功能
alter session set "_use_nosegment_indexes"=true;
-- 创建虚拟索引(关键:使用nosegment关键字)
create index ix_t_id on t(object_id) nosegment;
set linesize 1000
explain plan for select * from t where object_id=1;
select * from table(dbms_xplan.display());
虚拟索引下的执行计划:
PLAN_TABLE_OUTPUT
---------------------------------------------------------------------------------------
Plan hash value: 206018885
---------------------------------------------------------------------------------------
| Id  | Operation                   | Name    | Rows  | Bytes | Cost (%CPU)| Time     |
---------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT            |         |    12 |  2484 |     5   (0)| 00:00:01 |
|   1 |  TABLE ACCESS BY INDEX ROWID| T       |    12 |  2484 |     5   (0)| 00:00:01 |
|*  2 |   INDEX RANGE SCAN          | IX_T_ID |   313 |       |     1   (0)| 00:00:01 |
---------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------------------------------------------
   2 - access("OBJECT_ID"=1)
Note
   - dynamic sampling used for this statement (level=2)
虚拟索引效果评估
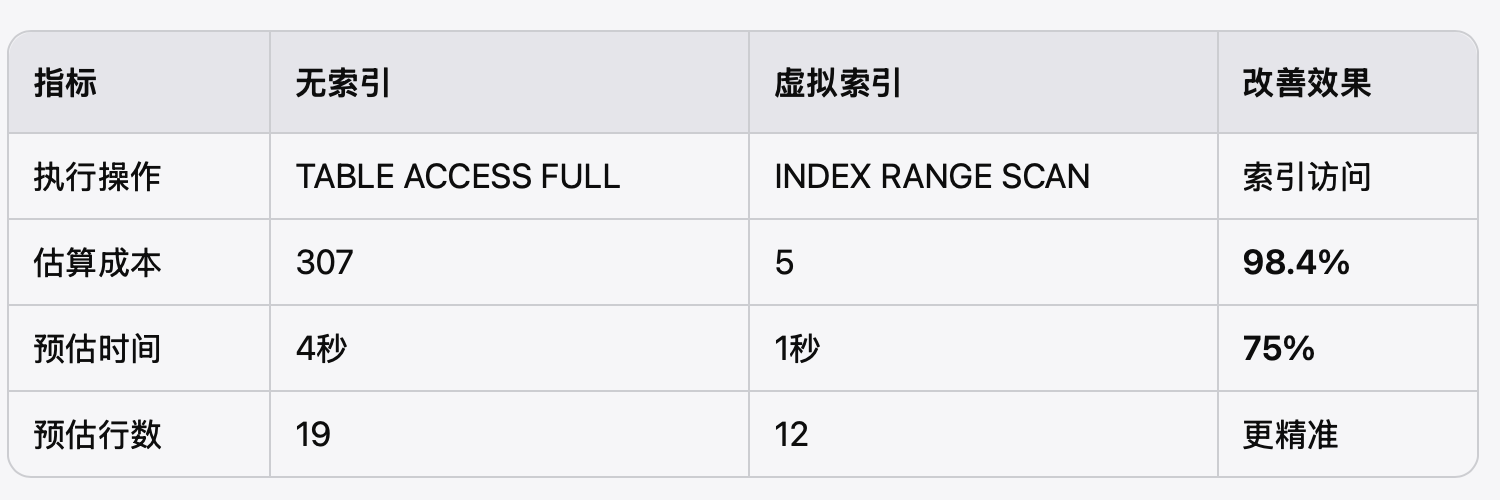
性能改善对比
关键发现
索引选择确认: Oracle优化器确实会选择使用该索引进行查询优化。
成本显著降低: 查询成本从307降至5,降幅达98.4%,效果显著。
访问方式优化: 从全表扫描转为高效的索引范围扫描。
虚拟索引的技术原理
核心机制
虚拟索引特点:
- 仅在数据字典中记录索引定义
- 不创建实际的索引段和数据块
- 优化器能够识别并评估其使用效果
- 零存储空间占用,零维护开销
使用语法
-- 1. 启用虚拟索引参数
ALTER SESSION SET "_use_nosegment_indexes"=true;
-- 2. 创建虚拟索引
CREATE INDEX index_name ON table_name(column_list) NOSEGMENT;
-- 3. 测试执行计划
EXPLAIN PLAN FOR your_query;
SELECT * FROM TABLE(DBMS_XPLAN.DISPLAY());
-- 4. 清理虚拟索引
DROP INDEX index_name;
实际应用场景
索引决策流程
-- 步骤1:创建虚拟索引测试多种组合
CREATE INDEX ix_virtual_1 ON orders(customer_id) NOSEGMENT;
CREATE INDEX ix_virtual_2 ON orders(order_date) NOSEGMENT;
CREATE INDEX ix_virtual_3 ON orders(customer_id, order_date) NOSEGMENT;
-- 步骤2:测试不同查询的执行计划
EXPLAIN PLAN FOR SELECT * FROM orders WHERE customer_id = 100;
-- 评估效果...
EXPLAIN PLAN FOR SELECT * FROM orders WHERE order_date = DATE'2024-01-01';
-- 评估效果...
-- 步骤3:选择最优索引方案创建实际索引
CREATE INDEX ix_orders_optimal ON orders(customer_id, order_date);
复杂索引评估
-- 评估复合索引的必要性
ALTER SESSION SET "_use_nosegment_indexes"=true;
-- 测试单列索引效果
CREATE INDEX ix_test_single ON large_table(frequently_queried_col) NOSEGMENT;
-- 测试复合索引效果
CREATE INDEX ix_test_composite ON large_table(col1, col2, col3) NOSEGMENT;
-- 对比不同索引策略的执行计划差异
使用注意事项
最佳实践
1. 参数设置:确保正确设置_use_nosegment_indexes=true
2. 全面测试:测试主要查询场景的执行计划变化
3. 成本对比:重点关注成本、时间、访问方式的改善
4. 清理及时:测试完成后及时删除虚拟索引
限制条件
- 虚拟索引不能用于实际查询执行
- 某些复杂场景的预估可能不够精确
- 需要结合实际业务负载进行综合评估
决策建议
基于虚拟索引的测试结果,该索引显示出显著的优化效果:
- 成本降低98.4%:从307降至5
- 访问方式优化:全表扫描转为索引扫描
- 执行时间预期:从4秒降至1秒
结论:该索引值得建立!
总结
虚拟索引提供了一种"零成本"的索引效果预估方法,让DBA能够在实际建立索引前评估其价值。本案例展示了虚拟索引如何帮助确认索引的必要性,预估的性能改善达到98.4%,为索引建立决策提供了有力支持。
这种预估技术特别适合大型表的索引规划,避免了盲目建立索引的风险,为生产环境的索引优化提供了科学的决策依据。

未完待续..
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3088060/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
