往期回顾:
左右SQL执行计划妙招 ③ ——执行计划SQL写法差异改变【with子句】
左右SQL执行计划妙招 ④ ——执行计划SQL写法差异改变【insert all】
左右SQL执行计划妙招 ⑤ ——执行计划利用设计特性改变【并行度影响】
左右SQL执行计划妙招 ⑥ ——执行计划SQL写法差异改变【rownum分页】
左右SQL执行计划妙招 ⑦——执行计划SQL写法差异改变【rownum实体化】
左右SQL执行计划妙招 ⑧ ——执行计划SQL写法差异改变【rowid 的影响】
在Oracle数据库中,Result Cache是一项强大的缓存技术,能够将查询结果缓存在内存中,显著提升重复查询的性能。本文将通过实际案例展示Result Cache对执行计划和性能的深刻影响。
环境准备
构建测试环境,创建包含约60万行数据的表:
drop table t purge;
create table t as select * from dba_objects;
insert into t select * from t;
commit;
通过复制dba_objects表并再次插入自身数据,我们得到了一个数据量较大的测试表,为后续的性能对比提供了有效的测试基础。
对比实验:缓存前后的性能差异
语句1:普通查询(首 次执行)
select count(*) from t;
执行计划:
set autotrace  on
set linesize 1000
set pagesize 2000
select  count(*) from t;
-------------------------------------------------------------------
Plan hash value: 2966233522
-------------------------------------------------------------------
| Id  | Operation          | Name | Rows  | Cost (%CPU)| Time     |
-------------------------------------------------------------------
|   0 | SELECT STATEMENT   |      |     1 |   589   (1)| 00:00:08 |
|   1 |  SORT AGGREGATE    |      |     1 |            |          |
|   2 |   TABLE ACCESS FULL| T    |   315K|   589   (1)| 00:00:08 |
-------------------------------------------------------------------
   - dynamic sampling used for this statement (level=2)
统计信息:
     0  recursive calls
      0  db block gets
   2127  consistent gets
      0  physical reads
      0  redo size
    425  bytes sent via SQL*Net to client
    415  bytes received via SQL*Net from client
      2  SQL*Net roundtrips to/from client
      0  sorts (memory)
      0  sorts (disk)
      1  rows processed
语句2(注,这是连续执行第2次的输出结果):
select /*+ result_cache */ count(*) from t;
执行计划
------------------------------------------------------------------------------------------
Plan hash value: 2966233522
------------------------------------------------------------------------------------------
| Id  | Operation           | Name                       | Rows  | Cost (%CPU)| Time     |
------------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT    |                            |     1 |   589   (1)| 00:00:08 |
|   1 |  RESULT CACHE       | 1n8r6qr4v9h12fhyynpun7yn4q |       |            |          |
|   2 |   SORT AGGREGATE    |                            |     1 |            |          |
|   3 |    TABLE ACCESS FULL| T                          |   315K|   589   (1)| 00:00:08 |
------------------------------------------------------------------------------------------
Result Cache Information (identified by operation id):
------------------------------------------------------------------------------------------
   1 - column-count=1; dependencies=(LJB.T); attributes=(single-row); name="select /*+ result_cache */ count(*) from t"
Note
-----
   - dynamic sampling used for this statement (level=2)
统计信息
    0  recursive calls
      0  db block gets
      0  consistent gets
      0  physical reads
      0  redo size
    425  bytes sent via SQL*Net to client
    415  bytes received via SQL*Net from client
      2  SQL*Net roundtrips to/from client
      0  sorts (memory)
      0  sorts (disk)
      1  rows processed
性能分析:缓存带来的显著提升
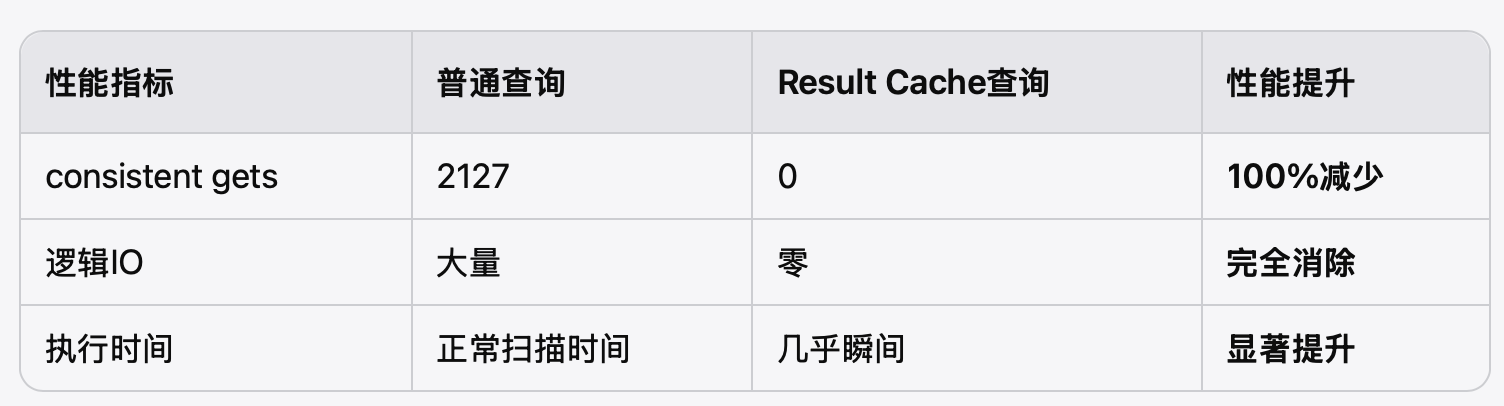
关键性能指标对比
Result Cache的工作机制
1. 首 次执行:正常执行SQL并将结果缓存到SGA中的Result Cache区域
2. 后续执行:直接从内存缓存中返回结果,完全跳过数据访问
3. 依赖跟踪:自动跟踪表的变化,当表数据发生修改时自动失效缓存
执行计划深度解析
RESULT CACHE操作的特点
执行计划中出现的RESULT CACHE操作具有以下特征:
- 唯一标识符:1n8r6qr4v9h12fhyynpun7yn4q是该缓存项的唯一标识
- 依赖关系:dependencies=(LJB.T)表明缓存依赖于表T
- 属性信息:attributes=(single-row)说明这是单行结果
- 完整SQL:缓存中保存了完整的SQL文本
零逻辑读的实现原理
语句2的consistent gets = 0表明:
- 无需访问数据块:结果直接来自内存缓存
- 无需索引查找:跳过所有数据访问路径
- 无需计算聚合:预计算的结果直接返回
Result Cache的适用场景
理想应用场景
- 聚合查询:COUNT、SUM、AVG等计算密集型查询
- 静态数据:变化频率低的维度表查询
- 重复查询:相同SQL被频繁执行的场景
- 复杂计算:涉及大量数据处理的分析查询
使用注意事项
- 数据一致性:缓存可能导致读取到略微过时的数据
- 内存消耗:大量缓存会占用SGA空间
- 失效机制:表数据变更会导致相关缓存失效
- 适度使用:并非所有查询都适合使用Result Cache
最佳实践建议
何时使用Result Cache
-- 适合:聚合查询,数据变化不频繁
SELECT /*+ result_cache */ department, COUNT(*)
FROM employees
GROUP BY department;
-- 适合:复杂的分析查询
SELECT /*+ result_cache */
       region,
       SUM(sales_amount),
       AVG(profit_margin)
FROM sales_summary
WHERE year = 2023
GROUP BY region;
何时避免使用
-- 避免:频繁更新的表
SELECT /*+ result_cache */ * FROM real_time_orders;
-- 避免:返回大量数据的查询
SELECT /*+ result_cache */ * FROM large_transaction_table;
监控和管理
查看Result Cache状态
-- 查看Result Cache使用情况
SELECT * FROM V$RESULT_CACHE_STATISTICS;
-- 查看具体的缓存对象
SELECT * FROM V$RESULT_CACHE_OBJECTS;
手动管理缓存
-- 清除所有Result Cache
EXEC DBMS_RESULT_CACHE.FLUSH;
-- 清除特定对象的缓存
EXEC DBMS_RESULT_CACHE.INVALIDATE('cache_id');
总结
Result Cache是Oracle提供的一项强大的性能优化技术,能够将重复查询的性能提升到极 致水平。通过在执行计划中引入RESULT CACHE操作,Oracle可以完全消除数据访问的开销,实现零逻辑读的查询响应。
然而,正如实验中所强调的,这是特定场合应用的技术,不可滥用。合理使用Result Cache需要综合考虑数据特征、查询模式、系统资源等多个因素。只有在适当的场景下应用,才能真正发挥其性能优势,同时避免潜在的问题。
掌握Result Cache的使用技巧,是Oracle性能优化进阶过程中的重要一环,为解决复杂的性能瓶颈提供了有力的工具支持。
未完待续..
左右SQL执行计划妙招 ⑩ ——执行计划SQL写法差异改变【分区条件有无】
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3086446/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
