摘要
笔者将教会大家如何真正读懂执行计划,这个其实并不容易。在优化的大方向基本上都清晰后,剩下的就是具体的优化实施:
-
修改数据库及主机相关性能参数;
-
根据业务规则修改SQL代码;
-
重新收集统计信息获取更准确的执行计划等。
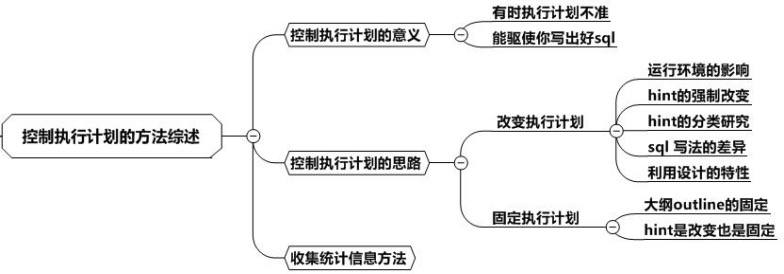
OK,让我们开始吧,先看看总体学习思路,如下图所示:

关键词
执行计划 HINT 子查询 SQL
1 控制执行计划的方法综述
1.1 控制执行计划的意义
前面已经讲过了,这里简单总结为两点:
-
可以临时在高峰期解决问题,避免因收集统计信息带来的开销;
-
有BUG导致执行计划一直不对,只好用人工控制来处理。
1.2 控制执行计划的思路
一般来说,环境的影响会改变SQL的执行计划,除此之外就是Hint 会强制让Oracle根据你的要求走对应的执行计划。
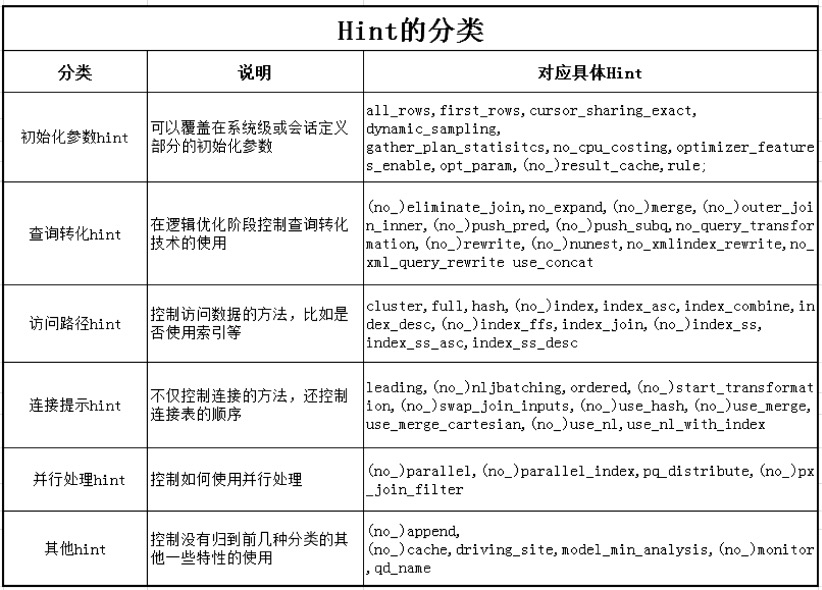
Hint的种类有多种,如下表所示:
此外写法差异也会带来执行计划的改变,比如with子句改造、分析函数改造、rownum的位置,等等。
还有一些设计的特性带来的执行计划的改变,比如普通表成为分区表就意味着执行计划从全表扫描要转换为分区扫描了。
这些写法改变和设计改造改变执行计划的例子很多,在本章的案例部分将会详细解说。
2.1 HINT的思路(子查询应用范围)
简单的SQL语句只有一个单独的查询块。当使用视图或类似子查询、内联视图、集合操作符等结构时,就会出现多个查询块(比如这个例子的查询就有两个查询块,第一个是引用了dept表的主查询,第二个是引用了emp表的子查询)。
之前我们总结了hint的分类,除了第一类初始化参数hint外,所有其他的hint都是仅针对单个查询块起作用。下面来看如何让各个模块的HINT生效的各种方法。
环境准备:
drop table emp purge;
create table emp as select * from scott.emp;
create index idx_emp_deptno on emp(deptno);
create index idx_emp_empno on emp(empno);
drop table dept purge;
create table dept as select * from scott.dept;
create index idx_dept_deptno on dept(deptno);
请看如下语句的执行计划:
set linesize 1000
set pagesize 2000
set autotrace traceonly
with emps as (select deptno,count(*) as cnt  from emp
               where empno in (7369,7782,7499)group by deptno)
select dept.dname,emps.cnt
 from dept,emps
 where dept.deptno=emps.deptno;
执行计划
--------------------------------------------------------------------------------------------
Plan hash value: 174555140
--------------------------------------------------------------------------------------------
| Id|Operation                        |Name           |Rows  |Bytes |Cost (%CPU)| Time     |
--------------------------------------------------------------------------------------------
|  0|SELECT STATEMENT                 |               |    3 |  144 |    4  (25)| 00:00:01 |
|  1| NESTED LOOPS                    |               |      |      |              |              |
|  2|  NESTED LOOPS                   |               |    3 |  144 |    4  (25)| 00:00:01 |
|  3|   VIEW                          |               |    3 |   78 |    3  (34)| 00:00:01 |
|  4|    HASH GROUP BY                |               |    3 |   78 |    3  (34)| 00:00:01 |
|  5|     INLIST ITERATOR             |               |      |      |           |          |
|  6|      TABLE ACCESS BY INDEX ROWID|EMP            |    3 |   78 |    2   (0)| 00:00:01 |
|* 7|       INDEX RANGE SCAN          |IDX_EMP_EMPNO  |    1 |      |    1   (0)| 00:00:01 |
|* 8|   INDEX RANGE SCAN              |IDX_DEPT_DEPTNO|    1 |      |    0   (0)| 00:00:01 |
|  9|  TABLE ACCESS BY INDEX ROWID    |DEPT           |    1 |   22 |    1   (0)| 00:00:01 |
--------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
   7 - access("EMPNO"=7369 OR "EMPNO"=7499 OR "EMPNO"=7782)
   8 - access("DEPT"."DEPTNO"="EMPS"."DEPTNO")
(1)控制在所在的查询块内
两个hint的有效区域都被严格控制在它们所在的查询块内,脚本“hint控制查询块如下:
with emps as (select /*+full(emp)*/ deptno,count(*) as cnt
               from emp where empno in (7369,7782,7499)
              group by deptno)
select /*+full(dept)*/ dept.dname,emps.cnt
 from dept,emps
 where dept.deptno=emps.deptno;

执行计划
----------------------------------------------------------------------------
Plan hash value: 2415981340
-----------------------------------------------------------------------------
| Id  | Operation            | Name | Rows  | Bytes | Cost (%CPU)| Time     |
-----------------------------------------------------------------------------
|   0 | SELECT STATEMENT     |      |     3 |   144 |     8  (25)| 00:00:01 |
|*  1 |  HASH JOIN           |      |     3 |   144 |     8  (25)| 00:00:01 |
|   2 |   VIEW               |      |     3 |    78 |     4  (25)| 00:00:01 |
|   3 |    HASH GROUP BY     |      |     3 |    78 |     4  (25)| 00:00:01 |
|*  4 |     TABLE ACCESS FULL| EMP  |     3 |    78 |     3   (0)| 00:00:01 |
|   5 |   TABLE ACCESS FULL  | DEPT |     4 |    88 |     3   (0)| 00:00:01 |
-----------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
   1 - access("DEPT"."DEPTNO"="EMPS"."DEPTNO")
   4 - filter("EMPNO"=7369 OR "EMPNO"=7499 OR "EMPNO"=7782)
(2)全局的hint的别名引用
with emps as (select  deptno,count(*) as cnt
               from emp
               where empno in (7369,7782,7499)
              group by deptno)
select /*+full(dept) full(emps.emp)*/ dept.dname,emps.cnt
 from dept,emps
 where dept.deptno=emps.deptno;

 -----------------------------------------------------------------------------
| Id  | Operation            | Name | Rows  | Bytes | Cost (%CPU)| Time     |
-----------------------------------------------------------------------------
|   0 | SELECT STATEMENT     |      |     3 |   144 |     8  (25)| 00:00:01 |
|*  1 |  HASH JOIN           |      |     3 |   144 |     8  (25)| 00:00:01 |
|   2 |   VIEW               |      |     3 |    78 |     4  (25)| 00:00:01 |
|   3 |    HASH GROUP BY     |      |     3 |    78 |     4  (25)| 00:00:01 |
|*  4 |     TABLE ACCESS FULL| EMP  |     3 |    78 |     3   (0)| 00:00:01 |
|   5 |   TABLE ACCESS FULL  | DEPT |     4 |    88 |     3   (0)| 00:00:01 |
-----------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
   1 - access("DEPT"."DEPTNO"="EMPS"."DEPTNO")
   4 - filter("EMPNO"=7369 OR "EMPNO"=7499 OR "EMPNO"=7782)
(3)用qb_name定义方式
有的时候SQL不写子查询的别名,比如WHERE条件中的子查询显然用不到别名,这时可以用qb_name定义方式,其中,qb_name(main)是固定必须写的,比如如下的full(@main dept)就是来引用主表的。
脚本“全局的hint的别名引用”代码和运行结果,如下:
with emps as (select  /*+qb_name(sq)*/ deptno,count(*) as cnt
               from emp
               where empno in (7369,7782,7499)
              group by deptno)
select /*+qb_name(main) full(@main dept) full(@sq emp)*/ dept.dname,emps.cnt
 from dept,emps
 where dept.deptno=emps.deptno;

 执行计划
----------------------------------------------------------
Plan hash value: 2415981340
-----------------------------------------------------------------------------
| Id  | Operation            | Name | Rows  | Bytes | Cost (%CPU)| Time     |
-----------------------------------------------------------------------------
|   0 | SELECT STATEMENT     |      |     3 |   144 |     8  (25)| 00:00:01 |
|*  1 |  HASH JOIN           |      |     3 |   144 |     8  (25)| 00:00:01 |
|   2 |   VIEW               |      |     3 |    78 |     4  (25)| 00:00:01 |
|   3 |    HASH GROUP BY     |      |     3 |    78 |     4  (25)| 00:00:01 |
|*  4 |     TABLE ACCESS FULL| EMP  |     3 |    78 |     3   (0)| 00:00:01 |
|   5 |   TABLE ACCESS FULL  | DEPT |     4 |    88 |     3   (0)| 00:00:01 |
-----------------------------------------------------------------------------
Predicate Information (identified by operation id):
---------------------------------------------------
   1 - access("DEPT"."DEPTNO"="EMPS"."DEPTNO")
   4 - filter("EMPNO"=7369 OR "EMPNO"=7499 OR "EMPNO"=7782)
结论与最佳实践
通过以上案例,我们可以看到在复杂SQL语句中控制执行计划的三种主要方法:
-
在各个查询块内单独添加HINT
-
使用别名在主查询中引用子查询表
-
使用qb_name显式定义查询块
每种方法各有适用场景:
-
简单独立的优化可使用第一种方法
-
需要统一控制多个查询块时,第二种方法更为简洁
-
面对没有别名的子查询时,第三种方法是唯一选择
在实际应用中,应根据SQL结构特点和优化需求,灵活选择合适的HINT应用方法。

未完待续...
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3086395/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
