0. 前言
在这个算力过剩的年代,我们往往容易养成一种简单的线性思维:遇到瓶颈,第一反应就是堆资源。
系统慢了?加 CPU,扩内存;身体差了?吃补剂,疯狂练;活干不完?拼时长,熬通宵。
但现实往往充满黑色的幽默:你熬红了双眼优化出来的系统,性能不如隔壁老王调整了一行代码的执行顺序;你饿得扶墙走的减肥成果,不如同事换个吃饭次序来得稳健。
这其中的差距,不在于你投入了多少资源,而在于你是否读懂了事物背后那套通用的执行计划。在阅尽了无数系统的生老病死后,我常常会有一种顿悟时刻:简单的背后往往藏着不简单的底层逻辑。
原来,人体的代谢系统和海量数据的迁移,家里的地板清洁和复杂的系统架构,它们表面上风马牛不相及,底层却都遵循着同一套物理定律。
顺序错了,代价是指数级的;顺序对了,就是四两拨千斤。
1. 进食的算法:人体就是一套需要流控的高并发系统
搞技术的人,体检报告上的指标往往比服务器的负载报警还要红。为了对抗三高,很多兄弟对自己那是真狠,说不吃晚饭就不吃,说只吃草就只吃草。这种由于焦虑引发的暴力运维,通常只能维持三天,然后就是报复性反弹,系统崩溃。
为什么?因为你没看懂身体的代码逻辑。其实,人体就是一套极其精密的高并发在线交易系统。你每一顿饭,就是一次高并发的数据写入。
回想一下我们传统的写入顺序:端起碗,先扒拉两口白米饭,配一块红烧肉,最后腻了再吃两口青菜。
在系统架构师眼里,这简直就是一场针对身体的 DDoS 攻击。
白米饭是精制碳水,极易降解。当你空腹摄入碳水时,葡萄糖分子就像决堤的洪水,瞬间打满你的血液。你的胰腺,也就是身体的自动伸缩组,监测到血糖报警,只能疯狂扩容,分泌胰岛素。而胰岛素处理不完的流量,就会被持久化存储,转化成脂肪。
这就是为什么你明明没吃多少,肚子却越来越大的原因:你的写入策略触发了系统的防御机制。
在畅销书《控糖革命》里,生物学家提出了一个堪称系统重构级的优化方案。它并没有让你减少数据量,而是让你调整执行计划:
这背后的逻辑,竟然和计算机网络的流量控制如出一辙。
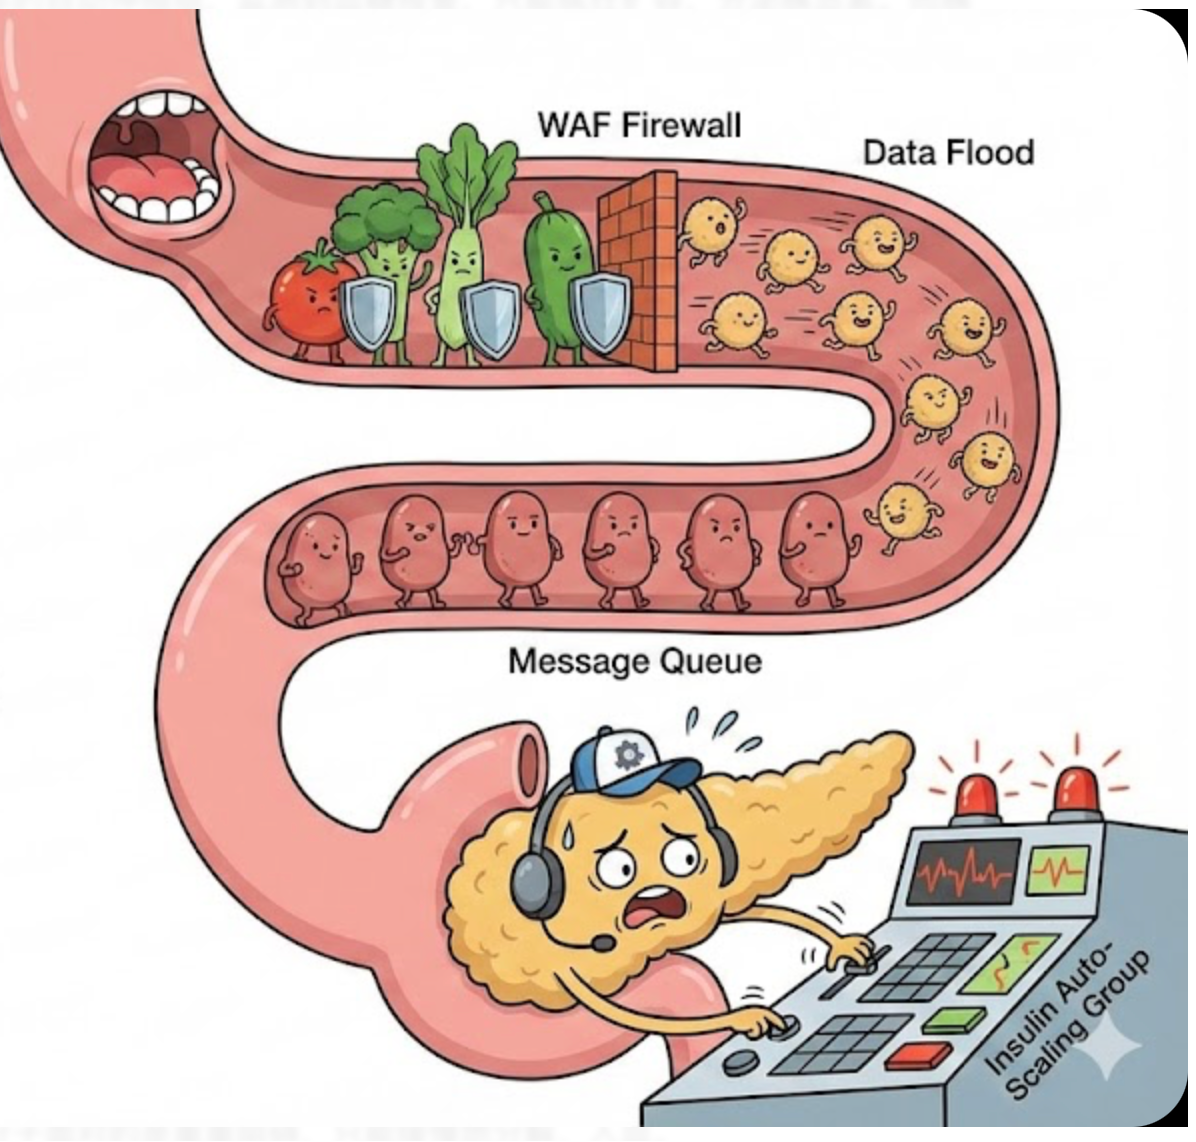
蔬菜是防火墙。蔬菜中的膳食纤维,人体无法消化。先吃下去,它们会在小肠壁上铺设一层物理网格,像网关一样限制了后续流量的并发数。
蛋白质是消息队列。肉类消化慢,进一步起到削峰填谷的作用,将突发的流量转化为平滑的流式数据。
当你最后才吃米饭时,淀粉分子面对的是重重阻碍,只能缓慢地分解、入血。
同样的饭菜,仅仅是顺序变了,你的血糖曲线从尖峰刺穿变成了平滑波动。不动代码,只改配置,健康随之而来。这就是生物学里的基于成本的优化。
2. 家务的拓扑学:物理定律之下,所有的逆行都是无用功
如果说生物学还需要点专业知识,那物理世界的逻辑则更加直观,和我们的系统运维逻辑更是惊人的一致。
很多技术大牛在公司里指点江山,回到家干家务却总被嫌弃。最典型的场景就是大扫除。看着地板脏了,强迫症发作,先把地拖得锃亮。一抬头,看见桌子脏了,又去擦桌子。
结果显而易见,桌上的灰尘、面包屑,在万有引力的作用下,噼里啪啦掉在刚拖好的地板上。
这时候你面临两个选择:要么假装看不见,这叫数据脏读;要么再拖一遍地,这叫事务回滚。无论选哪个,都是失败。
这背后其实是一个严肃的拓扑排序问题。
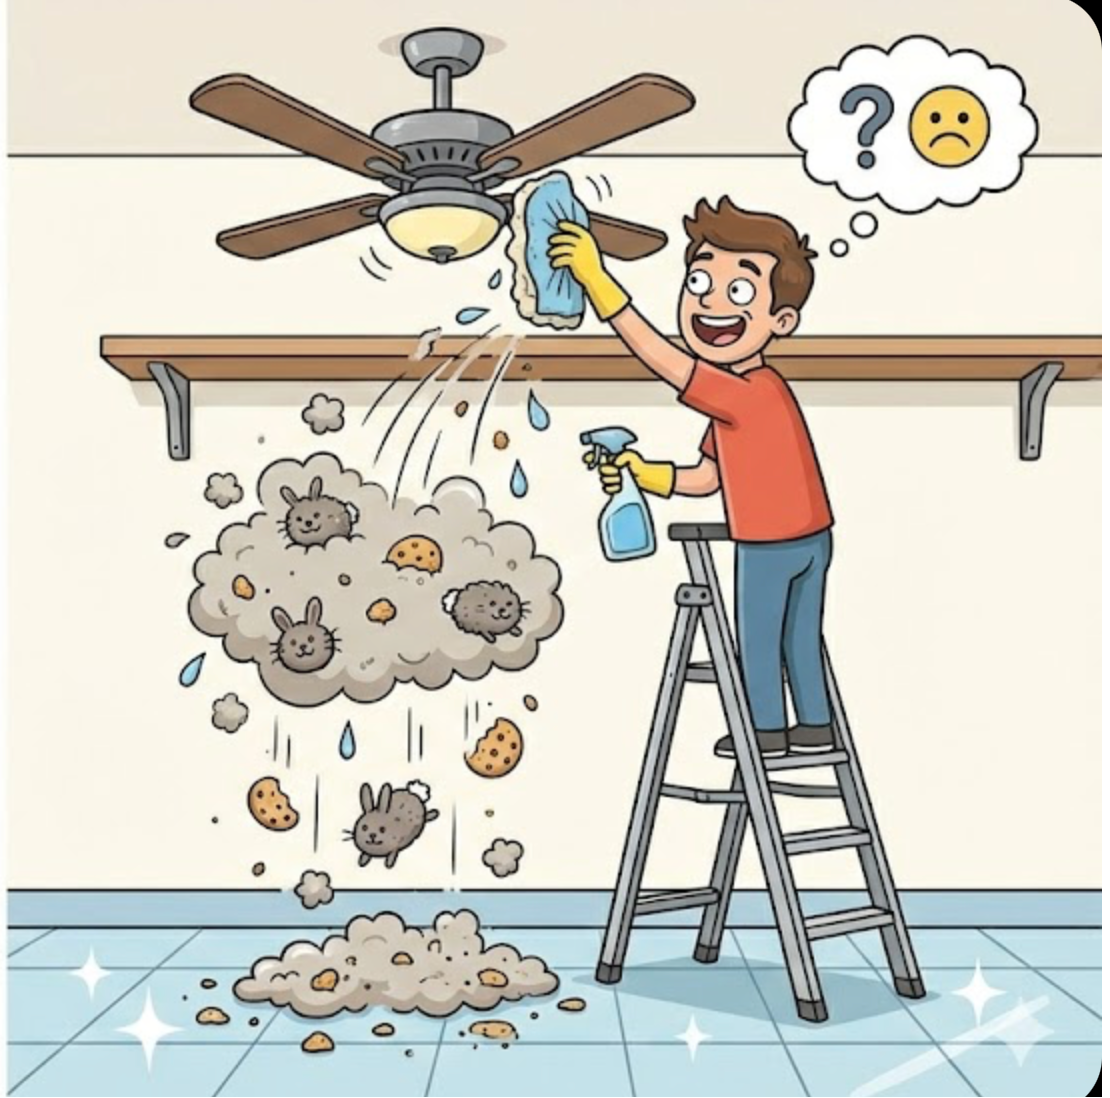
家务清洁是有严格依赖关系的。重力决定了灰尘永远是从上往下落的,这就是物理世界不可违背的约束条件。所以,做事的顺序必须是:自上而下,由内而外。
先搞定天花板、吊灯,再擦柜子、桌面,最后才是扫地、拖地。
这套顺序一走下来,所有的灰尘就像我们设计良好的数据流,层层沉淀,最终汇聚在最 底层的地板上。此时,你只需要一次全表扫描,就能把所有脏数据一次性清理掉。
生活中很多所谓的忙乱,其实都是因为我们试图违背物理定律,在做无谓的逆行。懂得了顺序,也就懂得了如何用最小的功,做最大的事。
当我们将这种对顺序的敬畏带回到我们最熟悉的数据库领域,你就会明白,为什么有些人的系统在海量数据面前会崩塌,而有的人却能举重若轻。
设想一个场景:你需要将一张 10 亿行的大表迁移到新库,时间窗口只有一晚。
初级选手的直觉通常是:先把表建好,为了查询快,把主键、唯一索引、复合索引都建得整整齐齐,像装修新房一样,然后再往里导数据。
结果就是,进度条像蜗牛一样爬,硬盘狂闪,IO 等待飙升。原本一晚上能干完的活,跑了三天三夜还在转圈。
为什么?因为你犯了 B-Tree 的大忌:先建索引,后插数据。
关系型数据库的索引,是一种高度有序的结构,就像图书馆里严格排列的卡片柜。当你先把索引建好,再往里灌数据时,每一条数据的插入,数据库都要拿着新数据去树上找位置。
如果数据是乱序的,磁头就得在磁盘上疯狂跳动,这叫随机写,是性能杀手。更可怕的是,书架满了还要硬塞,就会触发节点分裂。CPU 在燃烧,内存缓冲池在抖动,整个数据库为了维持秩序而疲于奔命。
真正的高手,处理这 10 亿数据时,心法只有八个字:先堆数据,后理秩序。
先建一张不带任何索引的裸表,全量插入数据。这时候数据库采用的是堆表插入,就像往麻袋里装土豆,只管扔,这是纯粹的顺序写,速度能达到磁盘吞吐的物理极限。
这时候,数据库会启动外部排序,把所有数据在内存里排好队,然后直接从底向上构建 B-Tree。就像盖房子,直接用预制板拼装,根本不会发生节点分裂。
仅仅是把建索引这个动作,从第一步挪到了最后一步,耗时往往能缩短数倍甚至更多。
这就是顺序的魔力。它告诉我们一个深刻的道理:不要在战火纷飞的时候去绣花。在混乱中快速积累总量,在总量完成后一次性建立秩序,这才是处理复杂系统的大智慧。
从一碗米饭的入嘴时机,到家务清洁的先后次序,再到十亿数据的迁移策略,看似风马牛不相及,实则殊途同归。
我们终其一生,其实都在做一件事:寻找最优的执行计划。
很多人之所以觉得人生艰难,往往是因为他们的依赖链搞反了。
年轻时,是全量插入数据的阶段,应该像裸表一样,疯狂吸收知识,积累阅历,不要过早地去建立复杂的人脉索引,不要被各种条条框框束缚。只有数据量够大,未来的索引才有价值。
中年时,是构建索引的阶段,要整理体系,建立连接,让价值被快速检索。
希望读完这篇文章的你,能换个视角看世界。不管是吃饭、干活,还是写代码、过日子,在动手之前,先停下来想一想…
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3109606/
,如需转载,请注明出处,否则将追究法律责任。


