往期回顾:
左右SQL执行计划妙招 ③ ——执行计划SQL写法差异改变【with子句】
左右SQL执行计划妙招 ④ ——执行计划SQL写法差异改变【insert all】
左右SQL执行计划妙招 ⑤ ——执行计划利用设计特性改变【并行度影响】
左右SQL执行计划妙招 ⑥ ——执行计划SQL写法差异改变【rownum分页】
左右SQL执行计划妙招 ⑦——执行计划SQL写法差异改变【rownum实体】
左右SQL执行计划妙招 ⑧ ——执行计划SQL写法差异改变【rowid 的影响】
左右SQL执行计划妙招 ⑧ ——执行计划SQL写法差异改变【rowid 的影响】
左右SQL执行计划妙招 ⑨ ——执行计划SQL写法差异改变【缓存结果影响】
左右SQL执行计划妙招 ⑩ ——执行计划SQL写法差异改变【分区条件有无】
左右SQL执行计划妙招⑪ ——执行计划利用设计特性改变【分区设计影响】
左右SQL执行计划妙招 ⑫ ——执行计划利用设计特性改变【Cluster类型】
左右SQL执行计划妙招 ⑬ ——执行计划利用设计特性改变【Iot表类型句】
左右SQL执行计划妙招 ⑭ ——执行计划利用设计特性改变【物化视图影响】
左右SQL执行计划妙招 ⑮ ——执行计划利用设计特性改变【列空值影响】
左右SQL执行计划妙招 ⑯ ——执行计划利用设计特性改变【主外键影响】
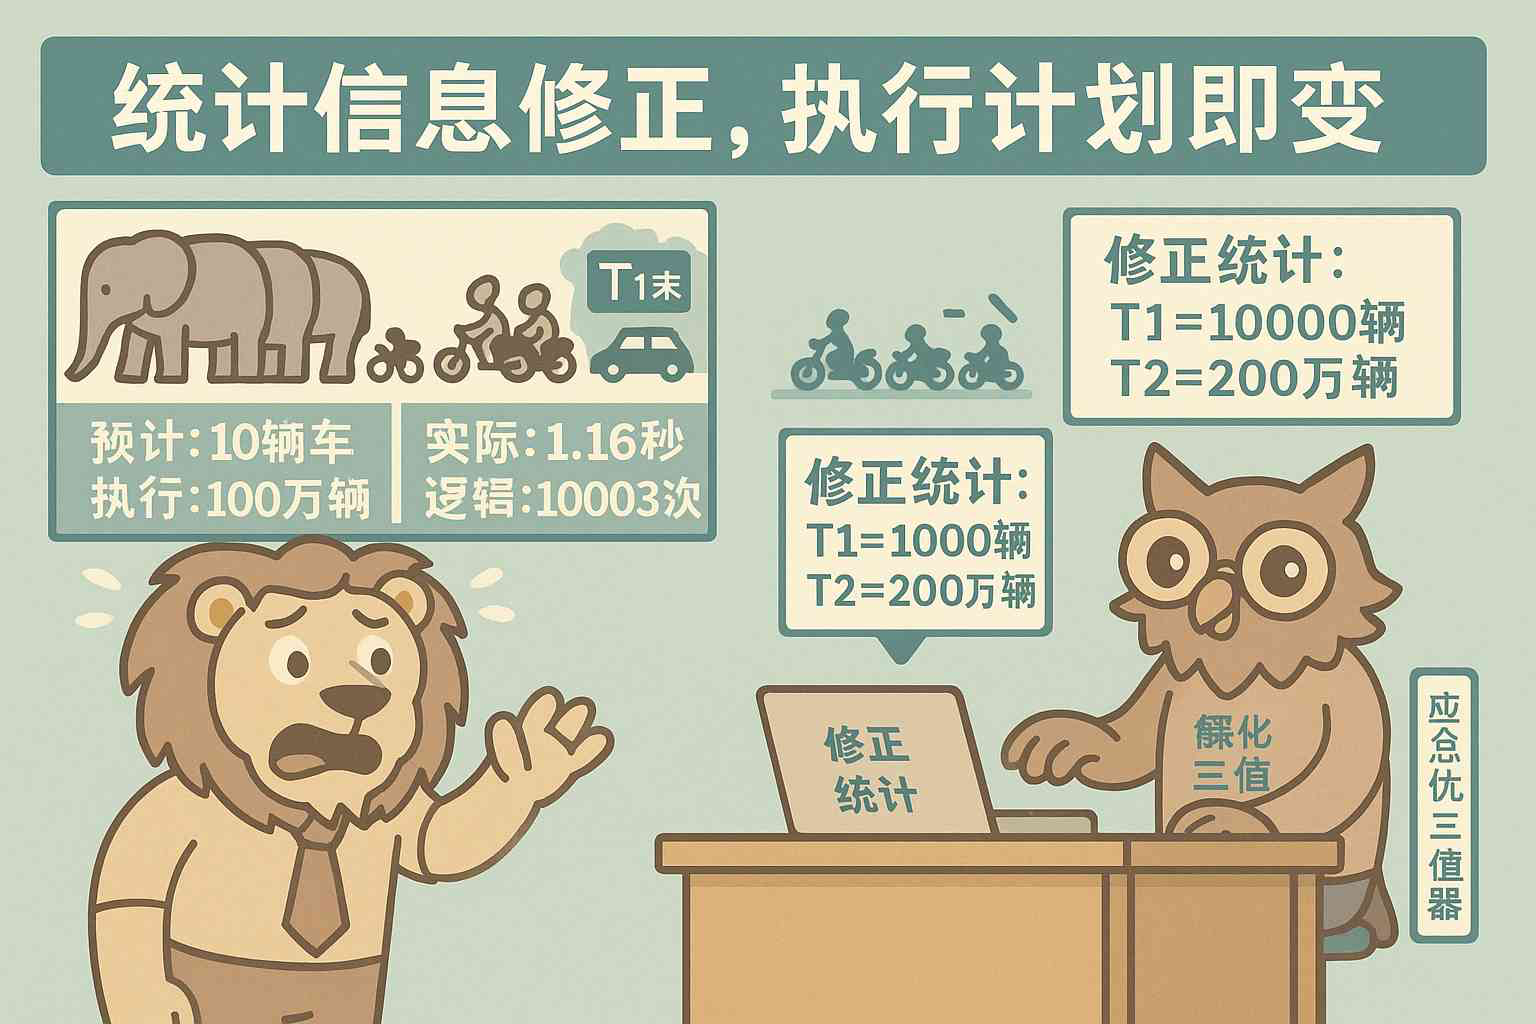
当生产环境中遇到统计信息不准确导致的执行计划问题时,SET_TABLE_STATS提供了一种轻量级的应急优化手段。本文作为《左右SQL执行计划妙招》系列第十七篇,展示如何在不重新收集统计信息的情况下快速改善查询性能。
问题场景:统计信息偏差导致的性能问题
初始查询及其执行计划
SELECT *
FROM t1, t2
WHERE t1.id = t2.t1_id
and t1.n<=20;
select * from table(dbms_xplan.display_cursor(null,null,'allstats last'));
执行计划:
PLAN_TABLE_OUTPUT
--------------------------------------------------------------------------------------
| Id  | Operation          | Name | Starts | E-Rows | A-Rows |   A-Time   | Buffers |
-------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |      |      1 |        |     20 |00:00:01.16 |   10003 |
|*  1 |  HASH JOIN         |      |      1 |     20 |     20 |00:00:01.16 |   10003 |
|   2 |   TABLE ACCESS FULL| T2   |      1 |     10 |   1000K|00:00:00.21 |    9985 |
|*  3 |   TABLE ACCESS FULL| T1   |      1 |     20 |     20 |00:00:00.01 |      18 |
-------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
-------------------------------------------------------------------------------------
   1 - access("T1"."ID"="T2"."T1_ID")
   3 - filter("T1"."N"<=20)
Note
----
   - cardinality feedback used for this statement
问题分析
关键问题: T2表被选为驱动表,但实际记录数为1000K,远大于预估的10条,导致执行效率低下。
驱动顺序错误: 小表T1应该作为驱动表,但优化器基于错误的统计信息选择了大表T2作为驱动表。
传统解决方案的局限性
重新收集统计信息的挑战
-- 传统方案:重新收集统计信息
exec dbms_stats.gather_table_stats(
    ownname => user,
    tabname => 'T1',
    estimate_percent => 10,
    method_opt=> 'for all indexed columns',
    cascade=>TRUE
);
exec dbms_stats.gather_table_stats(
    ownname => user,
    tabname => 'T2',
    estimate_percent => 10,
    method_opt=> 'for all indexed columns',
    cascade=>TRUE
);
局限性:
- 在业务高峰期影响生产系统性能
- 需要等待业务低峰期执行
- 使用HINT需要修改应用代码
SET_TABLE_STATS应急优化方案
快速修正统计信息
-- 设置准确的表统计信息
EXEC  dbms_stats.SET_table_stats(user, 'T1', numrows => 1000  ,numblks => 10);
EXEC  dbms_stats.SET_table_stats(user, 'T2', numrows => 2000000  ,numblks => 100000);
set linesize 1000
set pagesize 2000
alter session set statistics_level=all ;
-- 在某些版本中可能需要刷新共享池
-- alter system flush shared_pool;
SELECT *
FROM t1, t2
WHERE t1.id = t2.t1_id
and t1.n<=20;
select * from table(dbms_xplan.display_cursor(null,null,'allstats last'));
优化后的执行计划
PLAN_TABLE_OUTPUT
-------------------------------------------------------------------------------------
| Id  | Operation          | Name | Starts | E-Rows | A-Rows |   A-Time   | Buffers |
-------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |      |      1 |        |     20 |00:00:00.53 |    9879 |
|*  1 |  HASH JOIN         |      |      1 |    100K|     20 |00:00:00.53 |    9879 |
|*  2 |   TABLE ACCESS FULL| T1   |      1 |     50 |     20 |00:00:00.01 |      16 |
|   3 |   TABLE ACCESS FULL| T2   |      1 |   2000K|   1000K|00:00:00.18 |    9863 |
-------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
-------------------------------------------------------------------------------------
   1 - access("T1"."ID"="T2"."T1_ID")
   2 - filter("T1"."N"<=20)
优化效果分析
性能改善对比
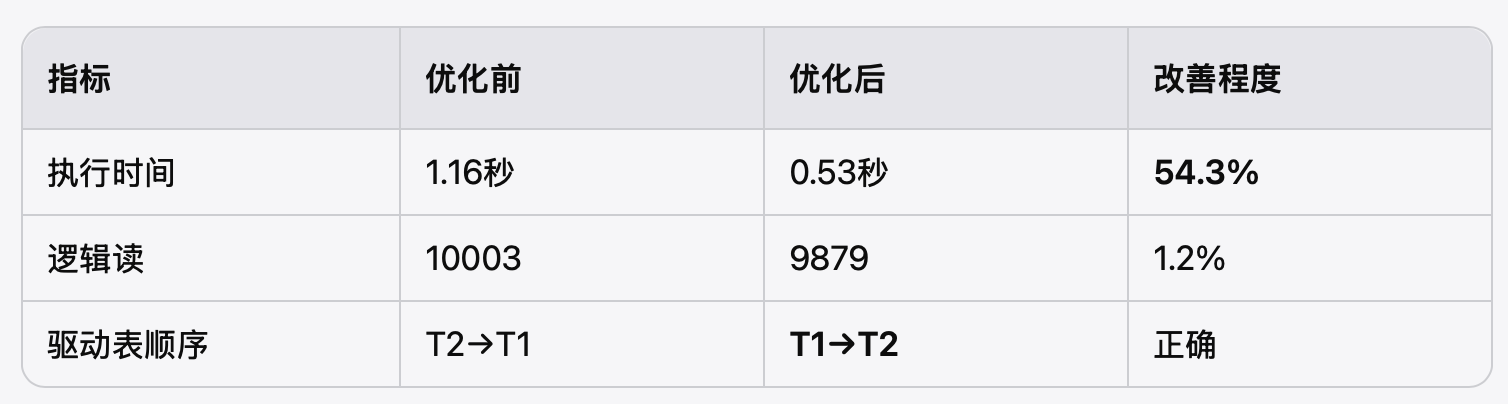
关键改变
驱动表优化: T1表变为驱动表(Operation 2),符合小表驱动大表的优化原则。
预估准确性: T2表的行数预估从10条修正为2000K条,与实际的1000K条更加接近。
SET_TABLE_STATS的优势
应急优化特点
- 即时生效:无需等待业务低峰期
- 轻量操作:不涉及实际数据扫描
- 无代码修改:不需要改动应用程序
- 可控范围:仅影响特定表的统计信息
适用场景
- 生产环境紧急性能问题
- 统计信息严重偏差的临时修复
- 新数据导入后的快速调整
- 测试环境的执行计划验证
使用注意事项
最佳实践
-- 1. 记录原始统计信息
SELECT table_name, num_rows, blocks
FROM user_tables
WHERE table_name IN ('T1', 'T2');
-- 2. 设置合理的统计值
EXEC dbms_stats.SET_table_stats(user, 'T1',
    numrows => 实际估计值,
    numblks => 合理块数);
-- 3. 验证执行计划变化
-- 4. 计划在低峰期重新收集准确统计信息
风险控制
- 设置的统计值应接近实际情况
- 作为临时方案,最终仍需收集准确统计信息
- 在测试环境验证效果后再应用于生产
总结
SET_TABLE_STATS提供了一种"轻量级"的执行计划优化手段,在几乎不付出代价的情况下就改变了Oracle的执行计划。本案例将查询执行时间从1.16秒优化到0.53秒,性能提升超过50%。
这种方法特别适合生产环境的应急优化,为DBA在业务高峰期解决性能问题提供了一个有效工具。当然,这只是临时解决方案,根本性的解决还是需要在合适的时机重新收集准确的统计信息。
未完待续..
左右SQL执行计划妙招 ⑱ ——执行计划改变之其他相关手段2_预估索引效果
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3088044/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
