本文介绍发表于期刊Computers in Industry的论文《 Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines 》。针对燃气轮机状态监控等多维时序数据在异常检测中面临的样本严重不平衡以及正常与早期异常状态之间的类别混叠现象,该研究提出了一种结合聚类欠采样与自注意力编码器-解码器的混合重采样方法,重点通过可学习的注意力插值模块替代传统随机插值,以降低边界噪声样本的生成风险。
一、问题背景与重采样切入点
在航空燃气轮机等关键装备的连续监控场景中,设备在绝大部分生命周期内均处于正常运行状态,故障与异常样本的获取量极度匮乏,形成了显著的类别不平衡。此外,部件早期退化诱发的轻微异常往往与邻近的正常工况在时序表现上高度接近,导致原始特征空间中存在较严重的类别混叠区域。
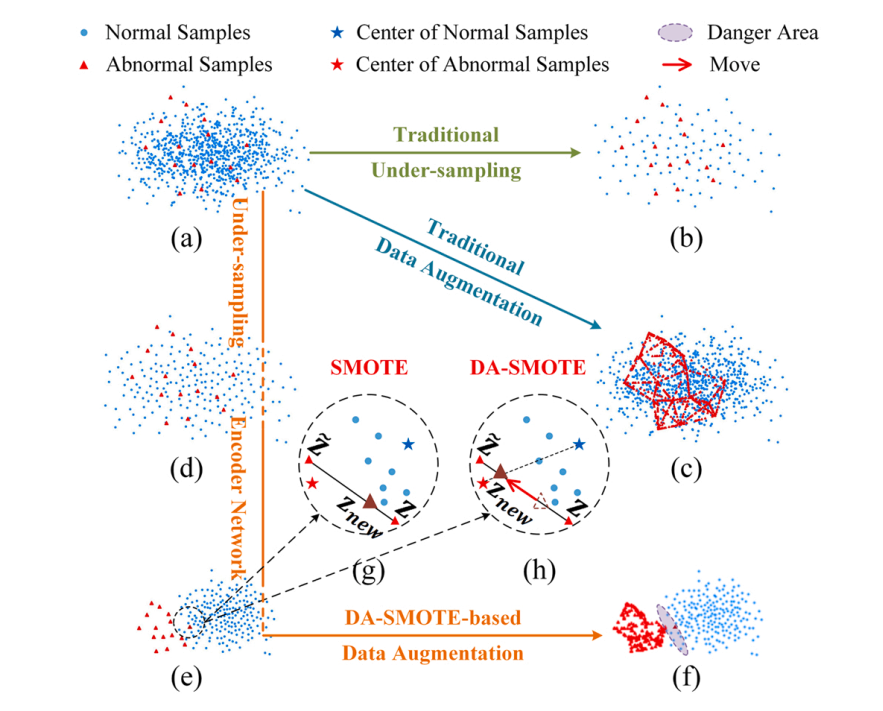
图1:原始样本分布、传统重采样方式及特征空间生成机制示意
直接应用传统欠采样会导致大量具有代表性的正常运行工况信息丢失;而直接基于原始数据进行过采样(如传统合成少数类过采样技术),由于插值过程通常在少数类样本与其近邻之间通过随机均匀分布生成线性插值因子,极易将合成样本推入多数类样本密集的交界危险区域,从而在训练集中引入标签混淆的伪噪声。
针对这一问题,该研究采用“先聚类欠采样、再映射至特征空间进行可控过采样”的混合策略,兼顾正常时序模态的保留与合成样本空间位置的合理性。
二、整体异常检测框架
该框架主要由时序预处理、基于聚类的多数类欠采样、基于编码器-解码器的注意力特征生成,以及自注意力时序分类器四个部分构成。
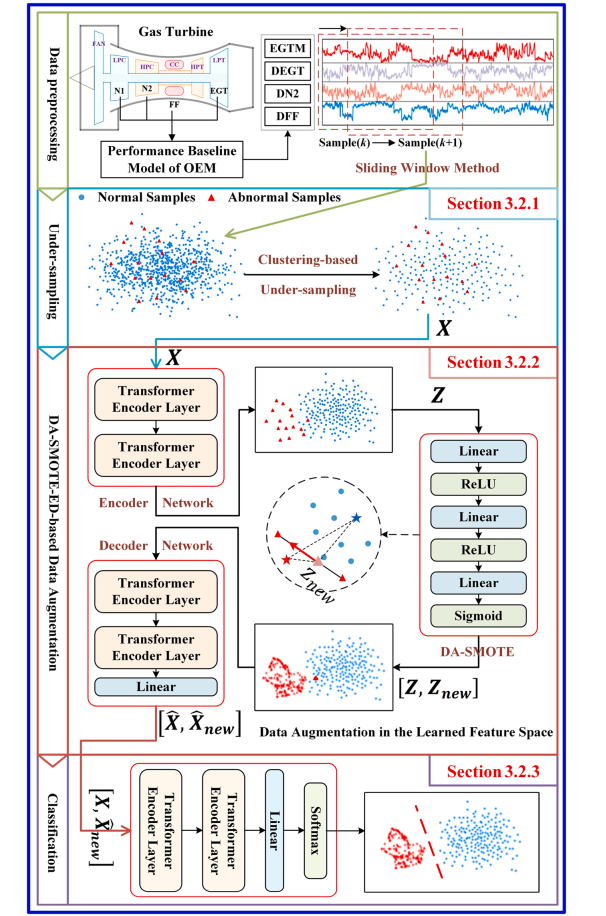
图2:多维时序异常检测与混合重采样整体架构
-
时序切片预处理:针对燃气轮机气路性能监测参数(如排气温度裕度、转子转速偏差等),采用滑动时间窗口进行切片,构建多维时序矩阵样本。
-
聚类欠采样:对规模庞大的多数类(正常)样本执行聚类划分,保留各聚类的中心向量作为压缩后的多数类代表,并与全部少数类(异常)样本合并。此步骤在大幅缩减正常类样本数量的同时,尽可能保留了正常工况分布的全局几何结构。
-
特征空间生成增强:将初步压缩的数据输入自注意力编码器映射至低维潜在特征空间,在该空间内利用注意力机制生成异常特征,再通过解码器重构回原始物理空间。
-
序列分类诊断:将重构后的平衡数据集送入自注意力分类网络完成模型训练,直接对测试序列进行健康状态判别。
三、DA-SMOTE-ED的结构与生成机理
特征空间生成模块(DA-SMOTE-ED)由三部分构成:用于压缩与解耦的时序编码器、用于自适应权值生成的注意力模块,以及用于逆映射的时序解码器。
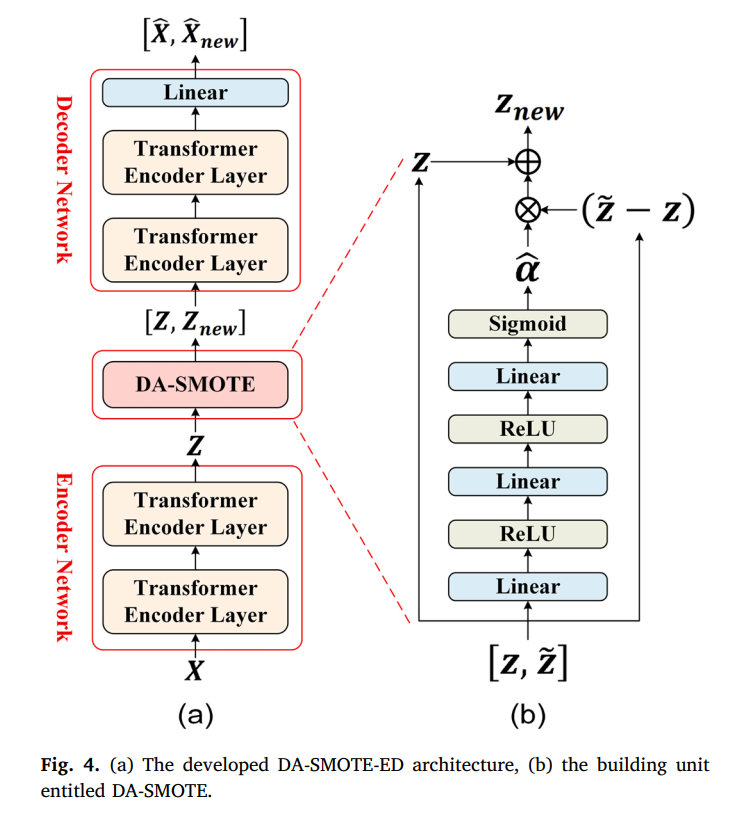
图3:DA-SMOTE-ED网络拓扑及注意力插值计算单元
1. 基于多头自注意力的编码与解码网络
由于工业传感数据存在多通道间耦合与多时间步依赖,常规卷积或循环神经网络容易出现信息衰减。编码器利用多层自注意力机制,通过不同的投影子空间分配时序权重,将原始多维时序投影至类间可分性更强的潜在特征空间。该特征空间的建立有助于拉开两类样本的距离,压缩潜在的交界重叠区域。解码器则保持对称结构,在特征增强完毕后将合成特征线性映射回原始传感器通道维度。
2. 自适应注意力插值模块(DA-SMOTE)
传统过采样方法在选定少数类样本对后采用固定的随机权重,忽视了局部数据分布的几何特征。该模块对选取的少数类基准样本与其近邻样本进行向量拼接,送入包含降维线性层、非线性激活层、升维线性层及归一化激活层的注意力单元中。
该结构根据样本对自身的特征差异,自适应输出介于零到一之间的插值因子。该因子不再依赖静态的随机抽取,而是随着网络参数共同优化,动态调整新样本在样本对连线上的相对位置,引导合成样本避开多数类分布密集区域。
四、优化目标与潜在空间分布调控
为了使潜在特征空间同时兼顾原始时序的信息保真度与几何可分性,网络的联合训练目标由重构约束与三元中心约束两部分组成:
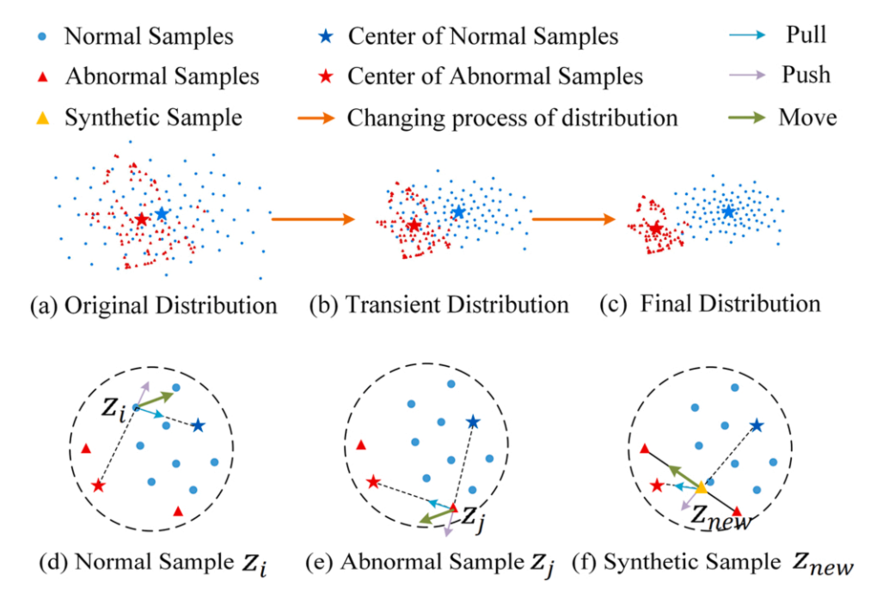
图4:训练过程中潜在特征空间样本与合成样本的分布演化机制
-
类别平衡重构准则:在计算输入与解码输出之间的重构差异时,根据正常样本与异常样本在欠采样后的有效样本数量比例引入加权系数,防止重构过程被样本量偏多的聚类中心主导,确保少数类时序形态的高保真复原。
-
三元中心几何约束:在潜在特征空间中设定正常类与异常类的特征中心。通过距离惩罚机制,一方面拉近同类样本与对应类中心的距离,推远异类样本与异类中心的距离;另一方面,将注意力模块生成的合成样本同样纳入约束,使其持续向异常类中心靠拢并远离正常类中心。
该机制在迭代训练中使得潜在特征空间形成类内紧凑、类间分散的分布形态,促使生成点沿着远离正常类区域的梯度方向移动,从数学约束层面降低了合成边界噪声的几率。
五、方法扩展与总结
上述方法主要针对工业设备监控中的二分类异常识别场景,其特征重构与中心距离的约束机制同样具备向多类故障诊断场景迁移的逻辑结构。在多类场景下,仅需将类中心推拉机制调整为计算样本与其实际标签中心、以及与其余所有异类中心中最小距离的差值,并匹配对应类别的平衡重构权重即可。
整体而言,Deep Attention SMOTE框架通过结合时序自注意力建模、聚类压缩与自适应插值,把对合成样本质量的控制从原始数据空间的后处理过滤,前移至可解耦特征空间的生成过程本身,为高度不平衡且伴有工况混叠的多维工业时序数据处理提供了一套规范的重采样实现路径。
参考文献
Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines[J]. Computers in Industry, 2023, 151: 103972.
https://www.sciencedirect.com/science/article/abs/pii/S0166361523001227
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051446/viewspace-3185187/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 持续对比强化学习:高不平衡与数据动态增长场景下的航空发动机故障诊断
- Feature-level SMOTE:面向燃气轮机不平衡故障诊断的特征空间数据增强方法
- 迈向“控制-诊断协同”:重新定义复杂动力系统智能故障诊断的技术路线
- 既看“身体反应”,也听“大脑指令”:控制-诊断协同视角下的故障诊断新范式
- 时序算法的即插即用外挂:基于“自适应分解+模态重构”的数据增强新解法
- 经验模态重构:一种保持本征特性的时序信号数据增强方法
- 拆解一篇可解释故障诊断论文:机理建模、参数精简、模型分类到双尺度归因
- 基于自注意力深度迁移学习的锂离子电池跨工况SOH在线估计论文解读
- BMSFormer:面向锂电池健康状态估计的高相关单健康因子提取与局部-全局特征融合建模
- 热力学仿真辅助随机森林:面向动力装备的可解释故障诊断方法
