



Kafka中的消费者,即consumer。是读取Kafka集群中某些tipic消息的应用程序,学习counsumer,可以从构建consumer,订阅topic,消息轮询,位移管理,重平衡,解序列化,多线程,解序列化,独立consumer,新旧版本对比这些方面逐个进行。
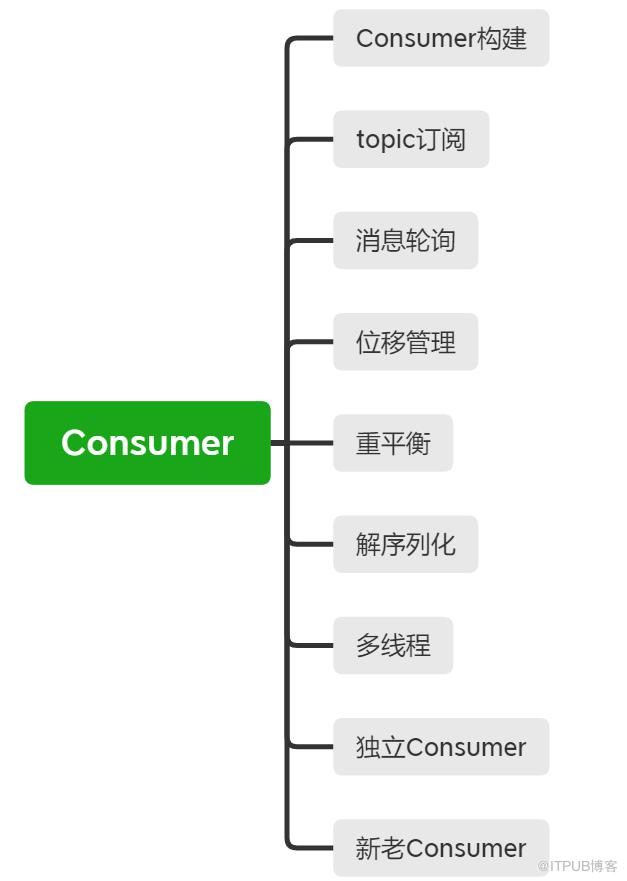


构造Consumer总体上分为以下几步:
1).构造一个java.util.Properties对象,需要指定bootstrap.servers,key,deserializer,value.deserializer和group.id的值。
建议在配置bootstrap.servers时使用主机名而不是IP地址,因为Kafka内部使用全称域名(FQDN,Fully Qualified Domain Name)。在配置group.id时设置一个有业务意义的名字即可。指定key.deserializer和value.deserializer时候需要指定类的全限定名,单独指定类名是不可行的。
2).使用Properties实例构造KafkaConsumer对象。可以在创建KafkaConsumer的同时指定key和value的deserializer。
3).调用KafkaConsumer.subscribe方法订阅consumer group感兴趣的topic列表。subscribe方法支持单个topic订阅,多个topic订阅,还支持正则表达式,但是subscribe方法是覆盖式的,即后面的设置会覆盖前面的设置。
4).循环调用kafkaConsumer.poll方法获取封装在ConsumerRecord的topic消息。poll方法可以根据需要设置超时时间timeout。
5).处理获取到的ConsumerRecord对象。对获取到的消息进行有意义的业务级处理。
6).关闭KafkaConsumer。释放KafkaConsumer运行过程的资源,内存,Socket连接等,关闭方法close分为不带参数的和带参数的,不带参数的最多等待30秒,带timeout参数的等待最多30秒。


Consumer订阅消息可分为以下几类:
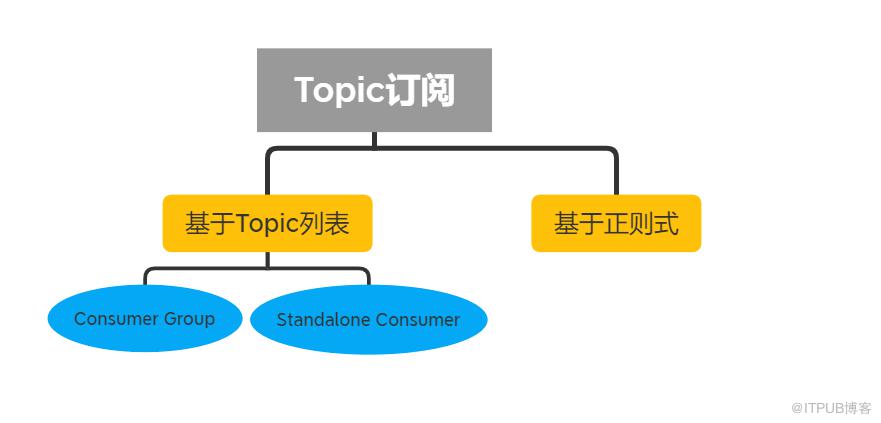
对于consumer group订阅,使用如下语句:
consumer.subscribe(Arrary.asList("topic1","topic2","topic3"));
对于独立consumer,使用如下语句手动订阅:
TopicPartition tp1 = new TopicPartition("topic-name",0);
TopicPartition tp2 = new TopicPartition("topic-name",1);
consumer.assign(Arrays.asList(tp1,tp2));
基于正则表达式订阅,使用如下语句:
consumer.subscribe(Pattern.compile("kafka-.*"),new ConsumerRebalanceListener()...)
如果用户使用自动提交,使用如下语句:
consumer.subscribe(Pattern.compile("kafka-.*"),new NoOpConsumerRebalanceListener());
以上所有订阅都是延迟生效的,即订阅信息只有在下次poll调用的时候才会正式生效。


Consumer订阅topic后,所有的消费逻辑包括coordinator的协调,消费者组的rebalance及数据的获取都会在主逻辑poll方法的调用中执行。当poll首次调用时,新的消费者组会被创建并根据对应的位移重设策略设定消费者组的位移。当consumer开始提交位移后,每个后续的rebalance完成后都会将位置设置为上次已提交的位移。poll方法会根据当前consumer的消费位移返回消息集合,但有时由于broker端无法满足consumer一次需要获取的数据量,可能会导致consumer一直处于阻塞状态。可通过超时时间可控制consumer等待消息的最大阻塞时间。
因此,以下两种情况下poll方法都可返回:
1).获取到了足够多的可用数据。
2).等待时间超过了指定的超时设置。
另外,如果consumer程序只是用来进行消费消息。可以设置等待时间为Long.MAX_VALUE。可以让consumer程序在未获取到足够数据时候可以无限等待,然后通过捕获WakupException异常来判断consumer是否结束。
总体来说,poll的使用方法如下:
当consumer需要定期执行其他子任务时,设置较小超时时间,同时运行标识布尔变量。
当consumer不需要定期执行子任务时,设置超时时间为MAX_VALUE,同时并捕获WakupException。
在Kafka中,Consumer端需要每个读取的分区保存消费进度,该位置称之为位移。位移值为下一条待消费的消息的位置。位移值从0开始。
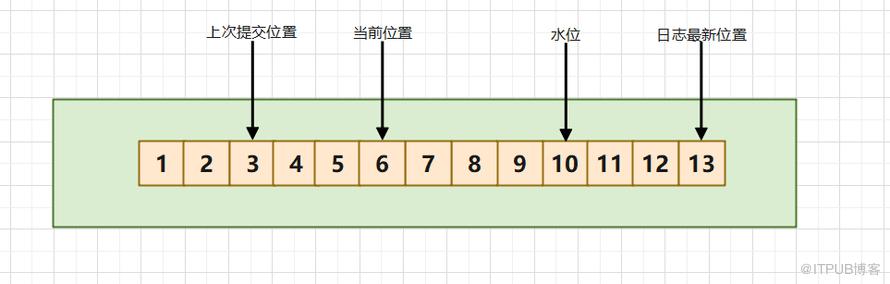
上图中,各个位置的含义如下:
上次提交位移(last committed offset):consumer最近一次提交的offset值。
当前位置(current position):consumer已读取但是还未提交时的位置。
水位(watermark):也称之为高水位(high watermark),处于水位以下的所有消息,consumer可以读取,处于水位以上的所有消息,consumer无法读取。只有分区所有副本都保存了某条消息,该分区的leader副本才会向上移动水位值。
日志最新位移(Log End Offset LEO):也称作日志终端位移,表示某个分区副本当前保存消息对应的最大的位移值,一般LEO不小于水位值。
新旧版本consumer位移管理方式不同,在新版本中,consumer会在集群的所有broker中选择一个broker作为consumer group的coordinator,用于实现组成员管理,消费分配方案制定以及提交位移等。即内部topic,该topic配置有多个分区,每个分区有多个副本,用来保存consumer提交的位移。consumer通过向所属的coordinator发送位移提交请求来实现位移提交,每个位移提交请求会往_consumer_offsets对应分区上追加写入一条消息,如果consumer为同一个group的同一个topic分区提交了多次位移,则只有最新提交的位移值是有效的。而旧版本中consumer的位移默认保存在Zookeeper节点中。
位移提交可以分为自动提交和手动提交两种。默认下consumer位移提交方式是自动提交,可以通过设置auto.commit.interval.ms参数控制自动提交的时间间隔。自动提交与手动提交的方式,优缺点,及使用场景如下:
自动提交:默认或设置enable.auto.commit=true,简单易用,开发简单,但是无法实现精确控制,位移提交失败后难处理,可能造成消息丢失,适合能够容忍一定的消息丢失的场景使用。
手动提交:设置enable.auto.commit=false,手动调用commitSync或者commitAsync提交位移,可实现精确控制位移提交行为,可以实现精确一次性处理语义,但是需要额外的开发成本,而且需要手动处理位移提交,适合于消息处理逻辑重,不允许消息丢失的场景。
关于consumer group的定义,官方的定义是:
Consumers label themselves with a consumer group name,and each record published to a topic is delivered to one consumer instance within each subscribing consumer group.
中文意思即:消费者使用一个消费者组名来标记自己,topic的每条消息都只会被发送到每个订阅它的消费者组的一个消费者实例上。
详细来说即,一个consumer group可以有一到多个consumer实例,同一个topic消息可以被发送到多个不同的group中,但是对于同一个group,同一个topic的每一条消息只能被发送到group下的一个 consumer实例上。
session.timeout.ms:该参数是consumer group用来检测组内成员发送奔溃的时间。在旧版本中,还用来代表consumer消息处理逻辑的最大时间,如果consumer两次poll之间的时间间隔超过了该参数设置的阈值,则coordinator认为该consumer无法跟上组内其他成员的消费进度,将会将该实例踢出组。该参数设置不当可能会导致不必要的rebalance甚至无法消费。在kafka0.10.1.0及以后版本中,该参数只用作coordinator检测失败的原因,默认为10s。
max.poll.interval.ms:在kafka0.10.1.0及以后版本中,kafka用该参数来表示consumer处理逻辑最大时间,可以更具实际业务处理场景设置该值。
auto.offset.reset:指定无位移信息或位移越界时kafka的对应策略。有三个取值:
earliest:指定从最早的位移开始消费,最早的位移不一定为0。
lastest:指定从最新处位移开始消费。
none:指定如果未发现位移信息或位移越界,则抛出异常。实际生产中使用较少。
enable.auto.commit:指定consumer是否自动提交位移。
fetch.max.bytes:指定consumer端单次获取数据的最大字节数,如果实际业务消息较大,则需要设置该参数为较大的值。
max.poll.records:控制单次poll调用返回的最大消息数。默认为500,可根据业务适当调整该值。
heartbeat.interval.ms:当coordinator开启新一轮rebalance时,会将该决定以rebalance_in_progress异常的形式加入到consumer心跳请求的response中,当其他成员接收到response后便可知道需要重新加入group中,该参数的值必须小于session.timeout.ms。
connections.max.idle.ms:该参数是关闭空闲socket连接的时间,默认为9分钟,如果资源充足且对处理时间很敏感,可以设置该参数值为-1,即不关闭空闲连接。
最多一次处理语义(at most once):消息可能丢失,但是不会被重复处理。
最少一次处理语义(at least once):消息不会丢失,但是可能会被处理多次。
精确一次处理语义(exactly once):消息一定会被处理且只会被处理一次。
kafka最开始便支持at least once语义,从0.11.0.0版本开始正式支持事务以及exactly once语义。

这几天由于一些工作上的变动,另外,还是想自己放松一下做个状态调整,暂时放松了学习。明天又要开始新的工作了,继续学习搞起。在该篇中,总结了consumer的构造,消息的订阅,轮询及位移管理这几个方面,剩下的会在接下来的时间继续学习,一起努力吧。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

