



上篇中,学习了consumer端的consumer构建,topic订阅,消息轮询,位移管理等知识点,今天继续剩下部分的学习吧。先进行重平衡部分的学习。
重平衡,也称rebalance,本质上是一组规定了一个consumer group分配订阅topic的所有分区的协议。举个例子,例如某个组下面有10个consumer实例,该组订阅了一个含有90个分区的topic,则kafka会为每个consumer平均分配9个分区,当有一个consumer离开组后,便会触发rebalance,kafka会重新进行分配分区,每个consumer由原来的平均分配9个分区变为分配10个分区。
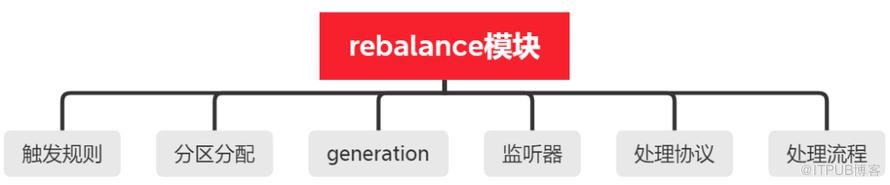
整体上,rebalance的学习可以分为以下六个部分。因内容较多,单独拎出来进行学习。


rebalance触发条件有三个:
1):组成员发生变更,例如consumer退出或加入组。
2):组订阅的topic发生变更,例如当使用基于正则表达式的订阅时有新的匹配的topic被创建时。
3):组订阅的topic的分区数发生变更。
rebalance的操作开销很大,频繁的rebalance会对consumer的吞吐量造成很大影响,因此需要合理设置request.timeout.ms,max.poll.records和max.poll.interval.ms参数,避免不必要的rebalance。


针对rebalance,kafka中consumer默认提供以下三种分配策略,用户可以根据partition.assignment.strategy参数进行配置,另外,还支持自定义分配策略,创建自己的分配器(assignment):
1).ranger策略:range策略基于范围进行分区,在分配时,会将单个topic的所有分区按序号排列,将消费者按照字母顺序排列,然后将分区按范围依次分配给每个consumer,分配时用分区的个数除以消费者线程的总数,如果除不尽,前面的消费者将会多消费一个分区,是默认的分配策略。
当只有一个topic时候,假设a=分区数/消费者数量,b=分区数%消费者数量,则前面b个消费者分配a+1个分区进行消费,后面的消费者分配a个分区进行消费。
当含有多个topic时候,假设topic数为x,y=分区数/消费者数量,z=分区数%消费者数量,则针对每个topic,前面z个消费者分配y+1个分区进行消费,后面的消费者分配y个分区进行消费。极端情况下可能造成消费分区数差别很大。
2).round-robin策略:round-robin策略会将所有topic的所有分区按序排列,然后轮询式样分配给各个consumer。
假设有a个topic,每个topic的分区数为b,假设y=a*b/消费者数量,z=a*b%消费者数量,该策略要求同一个消费者组里所有消费者的消费者线程数一致且每个消费者订阅的主题必须相同。否则可能会导致消费分区数差别很大。
3).不管是range策略还是round-robin策略:在下次rebalance时都会无视历史分配方案,这会造成资源的浪费。因此从0.11.0.0开始引入了sticky策略。sticky策略实现目标为分区的分配尽可能的均匀,分配给消费者的分区数最多相差一个,另外,在此基础上,尽可能保持分区的分配与上次分配的保持相同。例如三个消费者c1,c2,c3订阅了2个主题t0,t1,每个主题有三个分区,则分配结果为:
c1:t0p0,t1p0
c2:t0p1,t1p1
c3:t0p2.t1p2
当某一时刻,c2脱离了消费组,则分配结果变为如下,原来的分配结果得以保留。
c1:t0p0,t1p0,t0p1
c3:t0p2.t1p2,t1p1


Kafka中针对rebalance相关事宜提供了五个协议。然后consumer group与coordinator共同使用这些协议完成rebalance。
1).JoinGroup:consumer请求加入组。
2).SyncGroup:group leader将分配方案同步更新到组内所有成员中。
3).Heartbeat:consumer定期向coordinator汇报心跳表明自己依然存活。
4).LeaveGroup:consumer主动通知coordinator该consumer即将离组。
5).DescribeGroup:查看组的所有信息,包含成员信息,协议信息,分配方案等信息,主要供管理员使用。
rebalance的流程如下:

确定coordinator由算法实现,具体先无须了解。建立连接后,便可进行rebalance了,主要为加入组和同步更新分配方案这两步,先了解加入组和更新分配方案的细节。
加入组:在这个过程中,族中所有的consumer向coordinator发送JoinGroup请求,当所有JoinGroup请求收集完成后,coordinator会选择一个consumer作为该group的leader,并将所有成员信息及订阅信息发送给leader。
同步更新分配方案:根据分配策略完成分配后,leader会将分配方案封装进SyncGroup请求并发送给coordinator,在此过程中,每个组内成员都会发送SyncGroup请求,但是只有leader发送的SyncGroup请求中包含分配方案,coordinator接收到分配方案后会将每个consumer的方案单独筛选出来作为SyncGroup请求的response发送给相应的consumer。
rebalance监听器可以应用于用户需要提交位移到外部存储的场景,但是此时要求用户必须使用的是consumer group。如果用户使用独立consumer或者直接手动分配分区,则rebalance监听器是无效的。
rebalance监听器的主要接口回调类为COnsumerRebalanceListener,含有onPartitionsRevoked和onPartitionsAssigned两个方法,当开启新一轮rebalance前会调用onPartitionsRevoked方法,当rebalance完成后会调用onPartitionsAssigned方法。
一般rebalance需要在很短的时间内完成,因此不建议用户在rebalance监听器的方法中添加执行时间很长的逻辑,例如poll或take方法。
类似于JVM中的generation,consumer设计了rebalance generation用于标识某次rebalance以更好地隔离每次rebalance上的数据。
generation数值从0开始,每次rebalance后generation号会加1,可以用来保护consumer group,防止无效offset提交。例如,当上一届的consumer由于某种原因offset提交延时了,当rebalance后该consumer group生成了新一届的consumer group组成员,由于延迟的offset携带的是旧的generation信息,因此在提交时会被拒绝。此时日志会报ILLEGAL_GENERATION异常。
在上一次rebalance成功之后,consumer group组内的所有consumer都需要定期向coordinator发送心跳(Heartbeat)请求,每个consumer根据Heartbeat请求的响应中是否包含REBALANCE_IN_PROGRESS来判断下一轮rebalance是否已经开启。
将分配方案放在consumer端可以有更好的灵活性。一方面,可以实现类似于Hadoop的机架感知分配方案,当同一个机架上的分区数据被分配给相同机架上的consumer时,可以减少网络传输的开销。另一方面,如果分区策略发生变更,无须重启kafka服务器,只需要重启对应的consumer应用即可,可有效避免对其他应用造成影响。

上一篇中,总结了consumer的构造,消息的订阅,轮询及位移管理这几个方面,本篇学习总结了consumer的重平衡部分的一些知识点,该部分的涉及点较多,因此单独作为一篇进行记录。

END


原文作者:DBA修行之路;如有侵权,请联系管理员删除。

