


先说下自己对redis的感受吧,之前工作中也和redis打过交道,了解一些redis的知识,比如基本数据类型,单线程,持久化,单点模式,哨兵机制,集群模式,缓存雪崩,穿透啥的,认为自己也算是redis入门了,但是事实上并没有,最近在学习蒋德钧老师的redis课程,借此机会对自己之前学过的东西做一个总结,既是对已学知识点的温故,也是希望能够进一步深入redis。学习亦如参禅,恰如宋代禅宗大师青原行思提出参禅的三重境界:参禅之初,看山是山,看水是水;禅有悟时,看山不是山,看水不是水;禅中彻悟,看山仍然山,看水仍然是水。


思考之前学习redis过程中存在的问题,可以分为几个点:
1).只是浮于知识点表面,比如说只是知道redis很快,redis有五种数据类型,但是并不了解redis为什么很快,五种数据类型底层是如何实现的。
2).学习知识点散,乱,通常是遇到一个了解一个,没有系统的架构和认知。
在目前学习的课程中,对redis做了系统的总结,从应用和系统两大维度,高性能,高可靠,高可扩展性三大主线,处理层,内存层,存储层,网络层四大层次的角度对redis的知识系统做了一个完整的规整。如下:

另外,结合知识点和实际问题对redis做了问题画像,使得我们对redis能够有更全面的认知。
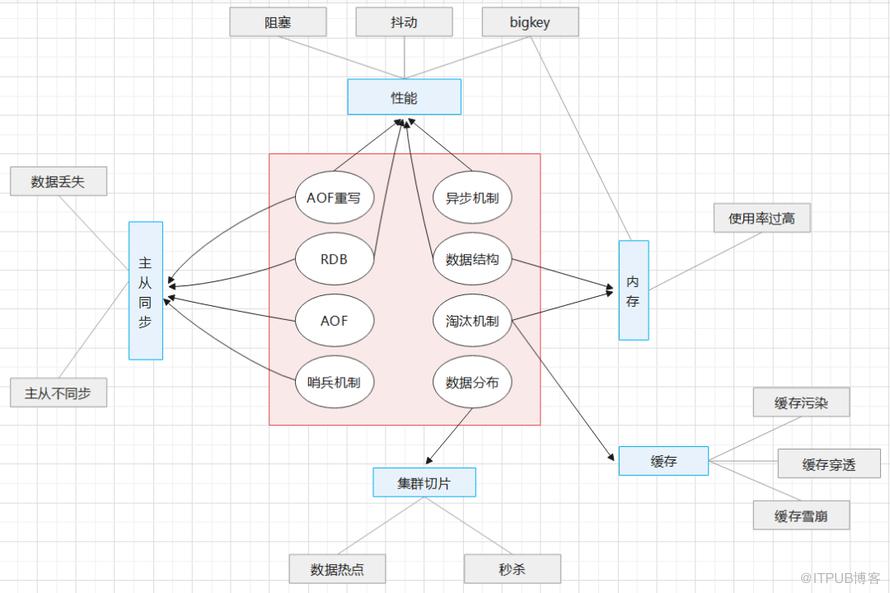
在接下来的学习中,将会针对学习的内容结合之前的知识点进行总结。


redis系统整体可分为以下五个部分:
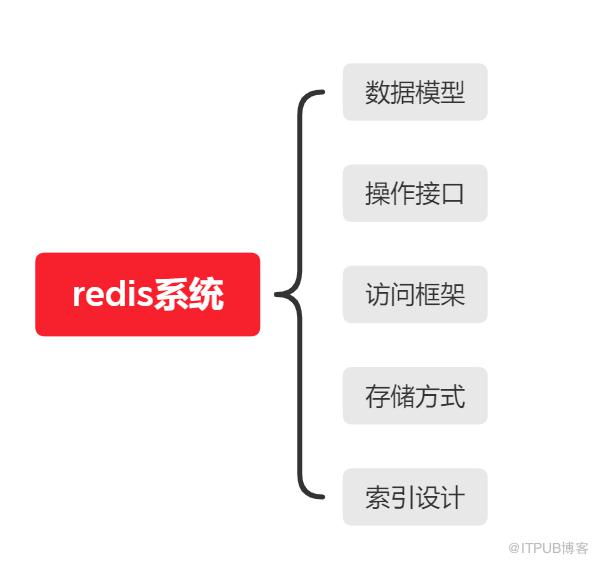
访问框架:数据库最终是需要和客户端进行交互的,客户端访问键值数据库的方式通常有两种:一种是通过函数库调用的方式供外部应用使用,例如RocksDB以动态链接库的形式链接到程序中,提供键值对操作能力。另一种是通过网络框架以Socket通信的形式对外提供键值对操作能力。Memcached和redis便是采用这种方式。不同的方式有不同的应用场景,不同的数据处理方式,也会带来不同的性能体验。
数据类型:数据库归根到底是用来存储数据的,不同的键值数据库能够支持的value类型差别较大,因此在进行数据库选择时需要考虑数据类型因素,例如Memcached只支持String类型,而redis支持String,hash,set,list,sorted set等五种基本类型。不同类型的数据结构在业务,性能,空间方面存在着一定的差异。
操作接口:数据存储到数据库中,需要有对应的操作接口才能对数据进行操作,例如,redis支持String,hash,list等五种数据类型,支持set,get,put,del等操作,则就需要设计这些对应操作的接口,当用户提交相应请求时,才能通过对应接口对数据进行操作。
索引设计:在进行数据操作时,如何快速查找要操作的键值对,这就涉及到索引,索引有多种类型,hash表,B+树,字段数等,不同的索引结构在性能,空间,并发方面表现不同,例如,关系型数据库mysql中innodb引擎索引使用的是B+树,而redis采用哈希表作为索引。
存储方式:redis主要以内存存储为主,而内存存储中一个关键的因素就是内存分配器,常用的内存分配器是glibc的malloc和free,在实际应用中,机制数据库的键值对往往大小不一,可能会造成内存碎片问题,redis的内存分配器提供了多种不同的机制供不同场景使用。而内存中数据在出现宕机或掉电时会丢失,因此需要定期进行持久化到硬盘。redis支持AOF和RDB两种持久化方式,各有不同的优缺点。


redis有五种数据类型,String,List,Hash,Sorted Set,Set等。对应的底层的数据结构有动态字符串,双向链表,压缩列表,hash表,跳表和整数数组等6种数据结构,对应关系为:

String类型使用的底层数据结构即是动态字符串。
List类型使用的底层数据结构有压缩列表和双向链表两种,当列表中单个元素小于64字节并且列表中元素总个数少于512的时候,使用压缩列表,否则使用双向链表。
Set类型使用的底层数据结构有hash表和有序整数数组,当集合中元素都是整数类型并且集合中元素总个数不超过512的时候,使用有序整数数组,否则使用hash表。
Sorted Set类型使用的底层数据结构是压缩列表和跳表,当有序集合中元素都小于64字节并且集合中元素总个数小于128个的时候,就使用压缩列表,否则使用跳表。
Hash类型使用的底层数据结构是hash表和压缩列表,当hash的key/value小于64字节并且hash中元素总个数小于512的时候,使用压缩列表,否则使用hash表。
I/O模型是一个比较抽象的概念,unix下一般有五种I/O模型,阻塞式I/O,非阻塞式I/O,I/O复用,信号驱动I/O,异步I/O。在键值数据库网络框架接收到网络包并按照相应的协议进行解析之后,如果想进行键值对的读写操作,是用一个线程还是多个线程,还是多个进程交互处理,根据业务场景和性能要求进行合理的设计或取舍。不同的I/O模型对数据库的性能和可扩展性有不同的影响。
索引类型有多种,而一般内存键值数据库,例如redis,采用哈希表作为索引,因为键值数据基本上是保存在内存中,而内存的高性能随机访问特性与hash表的时间复杂度很相配。
redis之所以这么快,一方面是因为其是内存数据库,所有操作在内存中完成,内存的访问速度本身就占很大的优势。另一方面,redis的数据结构设计非常合理。

最近的工作对redis的认知有一定的要求,因此最近决定花费一些时间系统的学习一下redis,本篇是结合学习课程的讲解,从redis的整体结构和问题画像,数据类型以及数据类型与数据结构对应关系进行总结。

END


原文作者:DBA修行之路;如有侵权,请联系管理员删除。

