



之前的学习中,可以知道redis的五种数据类型底层对应的数据结构有六种,哈希表,简单动态字符串,双向链表,压缩列表,整数数组,跳表,那么,这些数据结构各自是如何实现的呢,又有何特点呢,让我们一起来学习一下吧。


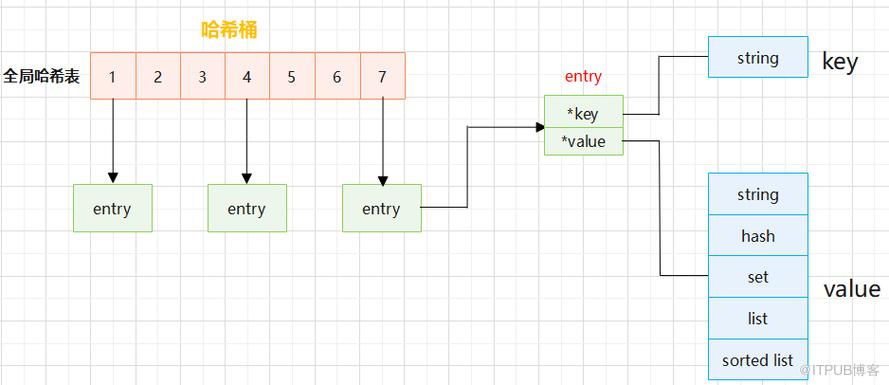
全局哈希表保存了redis中的所有键值对,本质上是一个数组,数组中的单个元素称之为哈希桶,哈希桶本身不保存redis中的值本身,而是保存指向具体值的指针。哈希表只需要根据键的哈希值就可以找到对应的哈希桶位置,继而访问对应元素,时间复杂度为O(1),但是存在哈希冲突问题和rehash操作堵塞问题。
哈希表是长这样子的滴,如下:
redis中解决hash冲突的方式是链式哈希,即同一个哈希桶中的多个元素使用一个链表来保存,链表之间的元素使用指针来连接,就是这样:
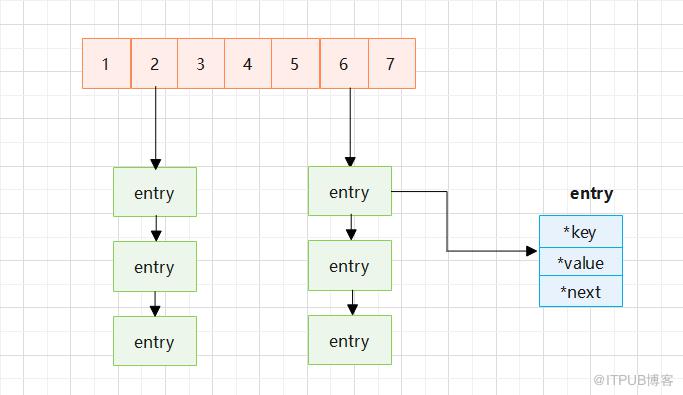
但是哈希链上的元素只能通过指针逐一查找再操作,随着数据增多,可能导致哈希冲突链过长,进而导致链表上的元素查找时间长。针对哈希冲突链过长问题,redis设计了哈希表的rehash操作,通过rehash增加现有的哈希桶数量,将entry元素分散到更多的桶中保存,减少冲突。rehash的过程如下:
redis默认使用两个全局哈希表来实现交替切换,记作哈希表a和哈希表b,最初默认使用哈希表a,哈希表b为空,哈希表b的空间大于哈希表a的空间,当进行rehash时,将哈希表a中的数据重映射并拷贝到哈希表b中,然后释放哈希表b的空间,实现哈希表a到哈希表b的切换,然后下一次进行rehash时,则使用哈希表a进行扩容。为了防止线程阻塞,redis使用渐进式rehash,即不是一次完成数据重映射,而是从第一个索引位置开始,每处理一次请求完成一个索引位置上的entries的重映射和数据拷贝。


跳表是在有序链表的基础上进行改造的,通过增加多级索引实现数据的快速定位。具体实现如下:
通过设置多级索引,快速实现目标键值对的定位。感觉这里与二分法的思想很类似。查找的复杂度为O(logN)。


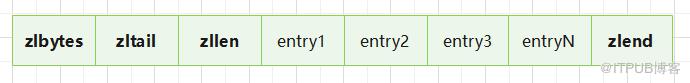
压缩列表类似于一个数组,数组中每个元素对应一个数据,但是在表头多了三个字段,zlbytes(列表长度),zltail(列表尾部偏移量),zlen(列表中entry数量),及表尾的zlend字段,表示列表结束。压缩列表中,可以直接通过表头三个字段长度查找第一及最后一个元素,但是对于其他元素,只能逐个查找。
压缩列表如下图:

除了上面说的几种数据类型,整数数组和双向链表通过数组下标或者链表的指针逐个元素进行访问,时间复杂度为O(N),效率较低。但是存在即合理,每种数据结构有不同的应用场景。
先总体展示下各个数据结构的时间复杂度。
| 数据结构 | 时间复杂度 |
| 哈希表 | O(1) |
| 跳表 | O(logN) |
| 压缩列表 | O(N) |
| 双向链表 | O(N) |
| 整数数组 | O(N) |
总体来说,哈希表的效率较高,应避免使用范围操作,即遍历操作,可以用SCAN代替。有统计操作需求时可以考虑压缩列表,双向列表,整数数组等数据结构,当需要进行首尾操作时,可以考虑压缩列表和双向链表。整数数组和压缩列表虽然时间复杂度方面不占优势,但是属于非常紧凑的数据结构,占用内存少,可以提高内存利用率。归根到底,就是要做到扬长避短。
首先说一下数组和链表在内存中的存储方式,数组在内存中使用的连续的内存空间,而链表在内存中不是连续存储的,再说一下cpu读取内存的方式,cpu读取内存时,不是只读取单个的数据,而是会将一片连续的内存块读取出来,然后放到缓存中,因为数组是连续的内存地址,因此数组全部或部分元素被连续存放在cpu缓存中,cpu只需要较少的时间即可读取缓存里的每个元素。而链表是分散在内存(堆)中的,cpu需要去内存中读取数据,时间较长。
redis中单线程指的是redis的网络IO和键值对读写是由一个线程来完成的,而redis的其他功能,如持久化,异步删除,集群数据同步是由其他的线程完成的。redis6.0开始引入了多线程。
在一定范围内,使用多线程的系统可以通过增加系统中处理请求操作的资源实体来提升系统的吞吐率。但是,多线程访问共享资源时为了保证共享资源的正确性需要进行额外的安全保护机制,这会带来额外的开销,随着线程越多,开销也越大,这会降低系统的吞吐率。另外,并发访问控制实现复杂,维护性差,因此,redis舍弃了多线程。

因为各自各样的原因,最近工作之外的学习时间较少,好在烦心事终于过去。也有时间继续之前的学习了。上篇学习了redis的整体架构,基本数据类型,这篇在课程的基础上总结一下基本数据类型对应的数据结构的相关知识。下篇将会学习redis的单线程及持久化知识点。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

