



大部分情景下,redis以高性能著称,但是某些情况下,redis也会遇到性能问题,从高铁秒变拖拉机,导致性能问题的原因有很多,总体来说,可以归纳为以下五个方面。
1).redis的阻塞操作,如bigkey删除,全量查询等,这个之前已经学习总结过。
2).cpu的numa架构,cpu的不同架构会对redis的性能造成不同的影响。
3).redis的一些系统配置也会影响redis的性能,例如swap,内存大页等。
4).redis的内存碎片,内存碎片可能占用大量内存。
5).redis的缓冲区设置,缓冲区设置不合理,可能导致数据丢失甚至实例崩溃。


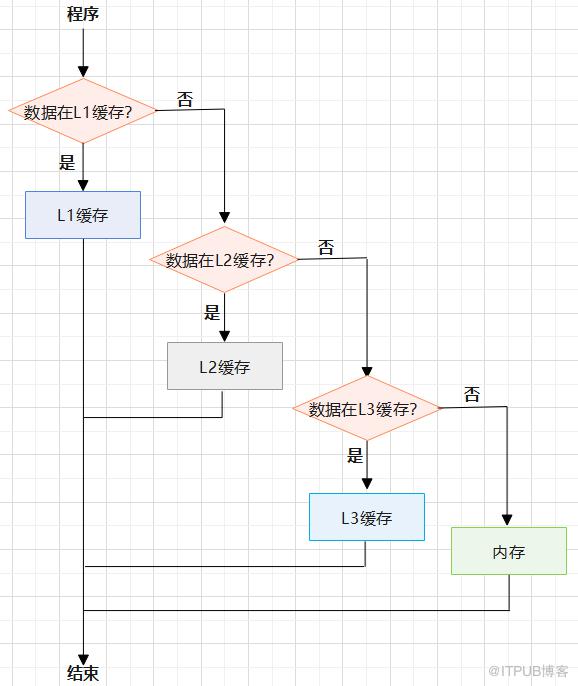
一般一个CPU处理器中有多个运行核心,一个运行核心被称为一个物理核,每个物理核都可以运行应用程序,每个物理核都拥有私有的一级缓存,包括一级指令缓存和一级数据缓存,以及私有的二级缓存。当数据或指令保存在L1,L2缓存中,物理核访问的延迟不超过10纳秒,速度非常快,如果redis将要运行的指令或存取的数据保存在L1和L2缓存的话,能够告诉访问这些指令和数据,但是L1和L2一般大小很小,一般只有KB级,如果L1,L2中没有所需的数据,应用程序则需要访问内存来获取数据,应用程序的访存延迟在百纳秒级别,是L1,L2缓存的延迟的近百倍。另外,不同的物理核之间还会共享一个共同的三级缓存L3,L3一般能达到几MB到几十MB,当L1,L2缓存中没有数据缓存时,先访问L3,以避免访问内存。
现在主流的CPU处理器一般每个物理核会运行两个超线程,即逻辑核,同一个物理核的逻辑核共享使用L1,L2缓存,而一个CPU处理器会有多个物理核,同一个CPU处理的多个物理核共享使用L3缓存,同时,为了提升服务器的处理能力,服务器上通常会有多个CPU处理器,不同处理器之间通过总线连接。
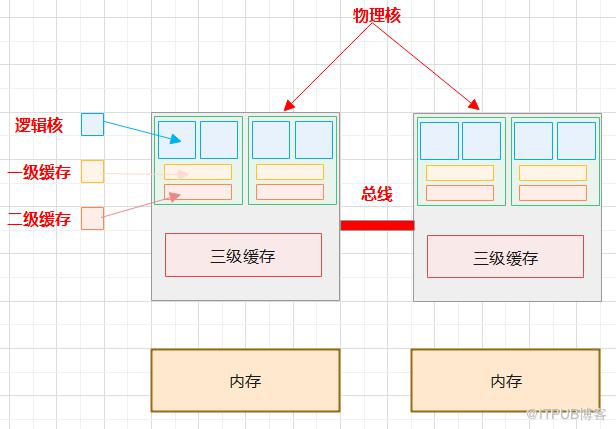
在多CPU架构上,应用程序可以在不同的处理器上运行,但是如果应用程序先在Socket A上运行,然后将数据保存到了内存,然后调度到Socket B上运行,此时应用程序再进行内存访问时需要访问Socket A上连接的内存,即远端内存访问,远端内存访问会增加应用程序的延迟。这就涉及到非统一内存访问架构(Non-Uniform Memory Access,NUMA架构),即在多CPU架构下,一个应用程序访问所在Socket的本地内存和访问远端内存的延迟不一致。
在一个CPU核上运行时,如果应用程序需要在不同的CPU核上运行,需要重新加载运行时信息,数据和指令到不同的CPU核上,可能会导致程序的运行时间增加,运行时信息指的是应用程序在CPU核上运行时应用程序需要记录自身使用的软硬件资源信息,例如CPU核的寄存器值,栈指针等。可以通过taskset命令将一个程序绑定在一个核上运行,例如将redis实例绑定到0号核上,命令如下:
taskset -c 0 ./redis-server
注:-c选项用于设置要绑定的核编号。
在NUMA架构下,一般为了提升redis的网络性能会将操作系统的网络中断处理程序和CPU核绑定,这种可以避免网络中断处理程序在不同核上来回调度执行以提升redis的网络处理性能。但是如果网络中断处理程序和redis实例绑定的CPU核不在同一个CPU Socket上,会降低redis访问网络数据的效率。
凡事有利有弊,当将redis实例绑到一个CPU逻辑核上,会导致资源竞争,导致主线程被阻塞,从而请求延迟增加,因此可以通过以下方法进行解决:
1.一个redis实例绑定一个物理核。
2.优化redis源码,将子进程和后台线程绑定到不同的CPU核上。


redis的系统配置对redis的性能也会造成一定的影响。
redis的系统配置主要可以分为两类,redis自身的配置和操作系统的配置。
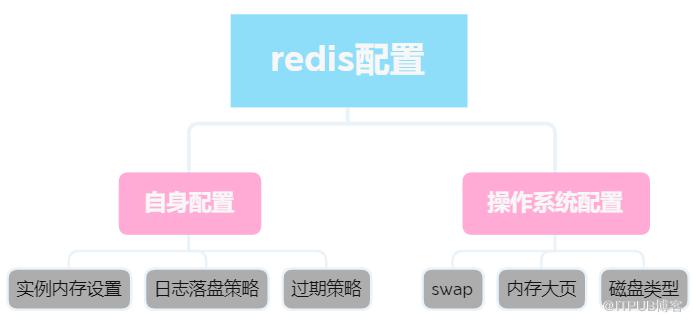
1.如果redis是主从版本的话,建议将单个实例的数据量大小控制在2~4GB,以免进行主从同步时从库因加载过大的RDB文件而导致阻塞。
2.根据实际的需求,在数据安全和性能方面进行权衡,合理设置appendfsync配置项及no-appendfsync-on-rewrite参数。
3.对于过期key,可以通过对过期时间添加随机数避免同时删除,redis的过期key清理采用抽样算法,每100毫秒会采样ACTIVE_EXPIRE_LOOKUPS_PER_LOOP 个数的key,将过期的key全部删除掉,另外如果超过25%的key过期了,则会重复删除直到过期key比例降至25%以下,ACTIVE_EXPIRE_LOOKUPS_PER_LOOP参数默认为20,可根据实际进行调整,在4.0版本之前删除操作是阻塞的,4.0后可以通过异步线程操作减少阻塞对redis的影响。
4.相对访问内存,访问swap需要更长的时间,自然也就会导致性能问题,如果发生了swap,建议增加机器内存。
5.在redis实例运行的服务器上,建议关闭内存大页机制,虽然在分配相同的内存时内存大页能减少分配次数,但是如果当客户端修改请求较多或新写入数据较多时,redis在进行写时复制时将会进行大量拷贝,会影响redis正常的访存操作,导致性能问题。
6.在redis中,会进行AOF重写和fsync落盘操作,这会产生磁盘IO资源竞争,可以使用固态硬盘代替传统的机械硬盘,高速固态硬盘的带宽和并发度至少是传统的机械硬盘的10倍以上。


redis实例在运行过程中,可能会产生内存空间碎片,随着内存空间碎片的增加,使得redis实际的内存使用率低,增加了机器运行成本。那么redis内存空间碎片是如何产生的呢,如何判断,又该如何解决呢?
redis的内存空间碎片的产生可以从两方面来分析,一方面是由于内存分配器的分配规则,redis可以使用libc,jemalloc,tcmalloc等多种内存分配器来分配内存,但是默认分配器为jemalloc分配器,jemalloc分配器一般按照固定的大小来划分内存空间,例如8,16,32字节等固定大小,当程序申请内存时,jemalloc分配器会分配给其相近大小的固定值的空间,以减少分配次数,这可能会导致内存空间碎片的产生。另一方面,当键值对被修改或者删除了,就需要占用额外的空间或者释放额外的空间。但是redis释放的内存空间不会立即返还给操作系统,而是由内存分配器管理,释放的内存空间可能不连续从而无法再次利用而处于一种闲置状态。
可以通过执行INFO memory命令查看redis的内存使用详细信息, mem_fragmentation_ratio这个指标表示的就是redis当前的内存碎片率,mem_fragmentation_ratio=used_memory_rss/used_memory,其中,used_memory_rss表示的是操作系统实际分配给redis的物理内存空间,used_memory表示的是redis为了保存数据实际申请使用的空间。当mem_fragmentation_ratio大于1小于1.5时,属于合理区间,当mem_fragmentation_ratio大于1.5后,则有必要清理内存碎片以降低内存碎片率。
一般可以通过重启redis实例清理内存碎片,但是重启影响较大,一方面如果redis未做持久化,重启会导致数据丢失,另一方面,即使进行了数据持久化,重启后也需要一定的恢复时间。在redis-RC3版本后,redis提供了一种自动清理内存碎片的方法,即如果有数据将一块连续的内存空间分割成几块不连续的空间时,操作系统会通过数据拷贝将数据迁移以使得原本不连续的空间变成连续空间。长时碎片清理可能会导致阻塞,降低redis性能。可通过以下参数合理设置。
activedefrag:当设置为yes时表示启用自动内存碎片清理。
active-defrag-ignore-bytes 参数:示例,如果参数设置为mb,表示当内存碎片达到100mb时候,开始清理内存碎片。与active-defrag-threshold-lower 同时满足时才进行清理。
active-defrag-threshold-lower 参数:示例,如果设置为10,表示当内存碎片达到操作系统分配给redis的总空间的10%时,开始清理。与active-defrag-ignore-bytes同时满足时才进行清理。
active-defrag-cycle-min 参数:示例,设置为25时,表示自动清理过程所用cpu时间的比例不低于25,以保证清理工作正常进行。
active-defrag-cycle-max 参数:示例,设置为75时,表示自动清理过程所用cpu时间的比例不高于75%,以防止清理工作造成redis阻塞。

redis属于c/s架构,操作命令是通过客户端发送给服务端的,考虑到某些情况下服务端的处理速度慢于发送速度从而导致性能和数据丢失问题,redis引入了缓冲区,可以从以下几个方面来学习缓冲区:
1.缓冲区的分类?
根据缓冲区的作用不同,redis中缓冲区可以分为三类,客户端缓冲区,主从同步全量复制缓冲区,主从同步增量同步复制积压缓冲区,其中,客户端可细分为和redis服务器端进行读写命令交互的普通客户端和订阅了redis频道的订阅客户端。
2.缓冲区的作用?
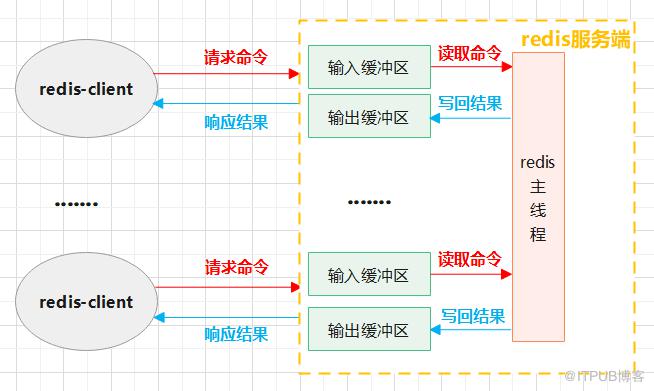
对于普通客户端,为了避免客户端和服务器端的请求发送和处理速度不匹配,服务器端给每个连接的客户端都设置了一个输入和输出缓冲区,输入缓冲区会先将客户端发送过来的命令暂存起来,然后redis主线程从输入缓冲区读取命令进行处理,当redis主线程处理完数据后,会将结果写入到输出缓冲区,然后通过输出缓冲区返回给客户端。
对于订阅客户端,当订阅的redis频道有消息后,服务器端会通过输出缓冲区把消息发送给客户端。
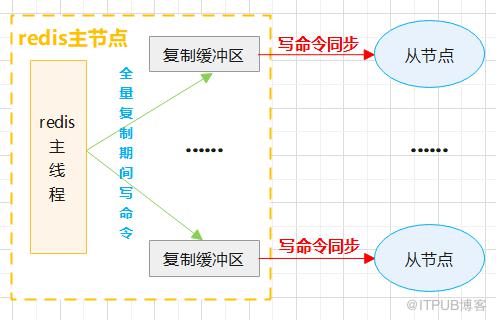
对于主从同步全量复制,在全量复制过程中,主节点会为每个从节点分配一个复制缓冲区,主节点在向从节点传输RDB文件的同时,还会继续接收客户端发送的写命令请求,这些写命令请求会先保存在复制缓冲区中,等待RDB文件传输完成后,再发送给从节点执行。
对于主从同步增量复制,在主节点同步写命令给从节点的时候,会同时将这些写命令写入环形复制积压缓冲区中,当从节点发生网络闪断再次和主节点恢复连接后,从节点可以从复制积压缓冲区中读取中断期间主节点接收到的写命令,进行增量复制同步。

3.什么是缓冲区溢出,为什么会发生缓冲区溢出?
缓冲区溢出指的是由于某种原因导致存储在缓冲区中的数据占用的内存超出了设定的阀值,从而导致数据丢失。
对于普通客户端缓冲区,溢出分为输入缓冲区溢出和输出缓冲区溢出,输入缓冲区可能导致溢出的原因有bigkey操作,服务器端发生阻塞,无法及时处理正常请求从而导致客户端请求积压。输出缓冲区可能导致溢出的原因有服务器端返回bigkey的大量结果,缓冲区设置不合理,执行了monitor监控命令。
对于订阅客户端输出缓冲区,如果频道消息较多的话,可能会占用较多的输出缓冲区空间,从而导致缓冲区溢出。
对于主从同步全量复制缓冲区,本质上是一个用于和从节点连接的客户端,如果从节点接收和加载RDB比较慢,同时主节点接收到了大量的写命令,写命令在复制缓冲区积累过多就会导致溢出。
对于主从同步复制积压缓冲区,复制积压缓冲区是一个环形缓冲区,当复制积压缓冲区被写满后,会覆盖缓冲区中的旧命令数据,如果从节点没有同步这些旧命令数据,会导致主从节点增量复制失败,需要重新进行全量复制。
4.如何避免缓冲区溢出?
对于普通客户端输入缓冲区溢出,无法调整输入缓冲区的大小,redis在代码中写死了缓冲区大小的上线阀值,为1GB,只能避免bigkey操作及其他可能导致redis主线程阻塞的操作。对于输出缓冲区溢出,一方面可以通过减少bigkey操作避免,另一方面避免在生产上执行monitor操作,还有就是设置合理的缓冲区大小。可以通过client-output-buffer-limit参数来设置缓冲区的大小。对于普通客户端输出缓冲区,可如下设置,client-output-buffer-limit normal 0 0 0,normal表示设置的是普通客户端,第一个0表示缓冲区大小限制,第2和第3个0表示缓冲区持续写入量及持续写入时间限制。
对于订阅客户端输出缓冲区,设置合理的缓冲区大小。可以通过client-output-buffer-limit参数来设置缓冲区的大小。对于订阅客户端输出缓冲区,可如下设置,client-output-buffer-limit pubsub 16mb 4mb 60,pubsub表示设置的是订阅客户端,16mb表示输出缓冲区的大小上限为16mb,当实际占用的缓冲区大小超过该值后,服务器会直接关闭客户端的连接,4mb和60表示如果连续60s内输出缓冲区的写入量超过4mb,则服务器端也会关闭客户端连接。
对于主从同步全量复制缓冲区,一方面可以合理设置主机点的示例规格,另一方面合理设置client-output-buffer-limit配置项,可如下设置,client-output-buffer-limit slave 512mb 128mb 60,slave表示设置的是复制缓冲区,512mb表示缓冲区大小的阀值为512mb,128mb和60表示如果连续60秒内的写入量超过128mb,会触发缓冲区溢出。实际业务中需要根据业务量进行合理设置,另外,主节点的复制缓冲区的内存开销是所有从节点客户端输出缓冲区占用内存的综合,因此需要合理控制从节点个数。
对于主从同步增量复制缓冲区,可以通过设置repl_backlog_size参数来调整复制积压缓冲区的大小,从而避免复制积压缓冲区溢出。
之前学习中讲述了使用复杂度高的命令或key *等全量查询命令,bigkey操作等会导致redis变慢,这里汇总下:
1.执行复杂或全量查询命令。
2.bigkey操作。
3.单个示例数据量较大。
4.aof写回落盘策略设置。
5.内存达到阀值或服务器发生swap或开启了内存大页。
6.网络问题。
7.磁盘读写慢。
8.cpu绑定不合理。
9.客户端使用短连接。
10.key过期时间设置不合理。
可以通过慢日志和latency monitor排查执行慢的操作。
对于慢日志,通过slow-log-slower-than设置慢执行的执行时间,大于该值则记录到慢日志中,通过slowlog-max-len设置慢日志记录的命令数量,慢查询日志使用的底层结构为队列,遵循先进先出原则,默认值为128。可以通过slowlog get 20 命令查看前20条慢日志。
对于latency monitor监控工具,redis从2.8.13版本开始支持,可以用来监控redis运行过程中的峰值延迟情况。使用latency monitor需要先设置执行时长的阀值,即设置latency-monitor-threshold参数,例如设置为1000微秒,然后使用latency latest命令进行查看延迟情况。
对于bigkey排除,可通过在执行redis-cli命令时加上-bigkeys选项实现。但是该工具会扫描所有数据,会影响redis示例性能,因此对于生产环境建议可以低峰期执行或扫描从库。
当mem_fragmentation_ratio小于1时,表示操作系统分配给redis的内存空间小于redis所申请的空间大小,此时运行redis实例的服务器可能内存不足发生swap了,因此redis性能会受到影响。

最近学习的内容是redis的性能问题及如何避免,从redis自身操作,cpu,操作系统设置,以及空间碎片,缓冲区多角度对redis的性能问题有了一个全局的认知,虽然学习的过程挺痛苦,收获还是不小的。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

