



redis以其高性能的数据存取功能而被广泛应用于缓存场景。一般为了防止数据库层压力过大,同时为了提升业务的响应速度,一般会在数据库层之上设置redis缓存层。那么,redis层是如何和数据库层协作的呢,他们又会碰撞出怎样的火花呢?系统深入地了解二者的爱恨情仇,可以从以下五个方面进行学习。 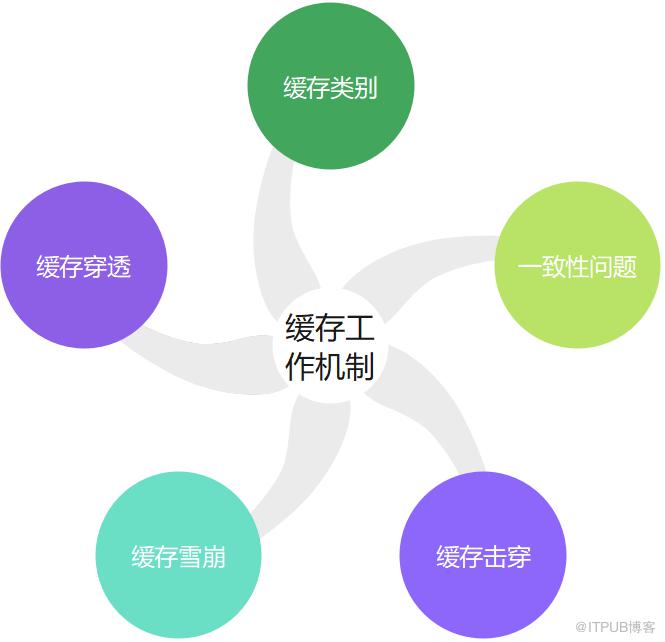


了解redis缓存的具体工作机制,需要了解缓存的特征,缓存的操作,缓存的类型,缓存的使用方法以及使用场景。以下从这五个方面对redis作为缓存进行总结:
1.缓存的特征:
缓存的特征可以用四个字来概括,短小精悍,这该如何理解呢,可以从两方面来理解,一方面,指的是缓存的容量小,缓存系统的容量一般是远小于后端系统的容量,一般用来存放访问频率较高的数据。另一方面指的是缓存的访问性能好。缓存的存取数据速度是比后端系统要快得多的,能够保证快速的业务访问。
2.缓存的操作:
将redis作为缓存时,当业务访问数据时,会先查询redis是否含有请求的数据,如果有,则直接返回,如果没有,则需要从后端数据库中读取数据,同时,为了后续请求能从缓存中读取到数据,需要将缺少的数据写入redis。这涉及到三个名词,缓存命中,缓存缺失,缓存更新。缓存命中指的是缓存中有请求的数据,可以直接读取,这种性能非常好。缓存缺失指的是缓存中没有请求的数据,需要从后端数据库中读取数据,性能较差。缓存更新指的是为了让后续数据能从缓存中读取到数据,需要将缺失的数据写入缓存。
具体涉及到代码中的操作是:
a.应用程序先连接redis,在代码中显式调用redis的get操作接口,进行查询。
b.如果数据存在,直接返回,如果缓存缺失,应用程序和数据库进行连接,从数据库中读取数据。
c.如果缓存中的数据需要更新,则需要在应用程序中显式调用set操作接口,把更新的数据写入缓存。
代码示例:
String key = "key123"
String cacheValue = redisCache.get(key);
//缓存命中
if(cacheValue != NULL)
return cacheValue;
//缓存缺失
else
cacheValue = getValueFromDB();
//缓存更新
redisCache.put(cacheValue);
3.缓存的类型:
redis作为缓存根据是否接受写请求可以分为只读缓存和读写缓存,其中,顾名思义,只读缓存只接受读请求,读写缓存既可以接受读请求,又可以接受写请求。
4.缓存的使用方法:
redis作为不同类别的缓存,使用方法也不同。
对于只读缓存,所有的数据写请求直接发往后端的数据库,但是读取数据的时候,会先调用redis的get接口,如果数据存在,直接返回,如果没有,需要从数据库中读取并写入redis。如果数据库中的数据被修改,需要将redis中的对应数据删除。
对于读写缓存,除了读请求会发送到redis进行处理,所有写请求也会直接发送到缓存,在缓存中对数据进行操作,然后同步数据到后端数据库,根据写回的时机不同,可分为同步直写和异步写回。同步直写指的是在写请求发送给缓存的同时,也发送给后端数据库进行处理,缓存和后端数据库都完成数据处理才返回给客户端。保障了数据安全,但会增加响应时间。异步写回指的是所有写请求直接在缓存中处理完即返回给客户端,当数据要被从缓存淘汰时才写回到后端数据库。响应时间快,但存在数据丢失风险。
5.缓存的使用场景:
一般对于数据写请求较少或者只需要提升读请求响应速度的场景,使用只读缓存,对于需要进行写请求加速的场景,使用读写缓存,同时,根据数据可靠性和缓存性能的要求不同,可以选择不同的写回策略,如果对数据可靠性要求更高,选择同步直写,如果对缓存性能要求更高,选择异步写回。


redis作为缓存,有效解决了应用的响应问题,但是同时也引入了一些新的问题,其中最关键的要数数据一致性问题了。对于数据一致性问题,可以从以下几个方面进行学习:
1.数据一致性的定义。
2.数据一致性的原因。
3.缓存一致性的解决方法。
1.数据一致性的定义。
数据一致性可以从两种情况来分析,第一种情况,缓存中没有数据,则此时数据库中的值必须为最新值,应用从数据库中读取值并更新到缓存中。第二种情况,缓存中有数据,则缓存中的数据值必须和数据库中的值一致。
2.数据一致性的原因。
对于读写缓存来说,如果要保证数据一致,则需要使用同步直写策略。当使用同步直写策略时,需要在业务中使用事务机制来保证缓存和数据库的更新,使得两者要么都执行成功,要么同时失败,如果其中一个失败,另一个也需要回滚,以此实现数据一致。
对于只读缓存,对于数据新增操作,数据会直接写入数据库,无须对缓存操作,此时缓存和数据库中的数据是一致,对于数据删改操作,应用需要在更新数据库的时候更新数据,则两个操作需要实现原子性,否则可能会出现数据不一致性问题。可以从两种情况分析,第一种情况,假设先删除缓存值,后更新数据库值。此时如果删除缓存值后数据库更新失败,再进行请求时候发现缓存缺失时会从数据库中读取值,此时会读取到旧值。第二种情况,先更新数据库值,后删除缓存值。此时如果删除缓存失败,再进行访问缓存时缓存命中的仍然是旧值。
3.缓存一致性的解决方法。
解决缓存一致性的最基本的方法就是重试机制,大致实现方式为:将要删除或更新的数据值暂存到kafka或者其他的消息队列中,当应用删除缓存值或者更新数据库值失败后,可以从消息队列中重新读取对应的值,然后进行删除或更新操作重试。如果重试成功后,将值从消息队列中去除,为了避免无限重试陷入死循环,可以设置最大重试次数值,达到一定次数还是失败的话,则向业务层发送报错信息。
虽然重试机制大部分时候能够最终保持一致性,但是如果此时请求并发量很大,业务仍然可能会读到不一致的问题,按照先删除缓存后更新数据库和先更新数据库后删除缓存两种情况来看:
a.先删除缓存,后更新数据
假设以下场景,线程a删除数据x的缓存值,但是由于某种原因,还没来得及更新数据库,线程b就读取数据了,线程b发现缓存缺失,从数据库中读取数据x,并将数据更新到缓存中。到此时线程a才更新数据库中的数据x。这会导致线程b读取到旧值,如果此时有其他线程,也会导致其他线程读取到旧值,另外,数据库中值为新值,缓存中值为旧值,这也会导致数据不一致问题,
这种场景解决方法是在线程a更新完数据库库值后让其先sleep一小段时间后再进行一次缓存删除操作,其中,sleep的时间需要大于线程b读取数据再写入缓存的时间,这个需要根据业务运行时读数据和写缓存的操作时间来进行设置。这种解决方法叫做延迟双删。大致代码如下:
redis.delKey(x)
db.update(x)
thread.sleep(n)
redis.delkey(x)
b.先更新数据库值后删除缓存值
假设以下场景,如果线程a删除了数据库中的数据值x,然后由于某种原因还没来得及删除缓存值,线程b查询缓存时发现缓存命中,则直接从缓存中读取旧值,此时虽然会读到旧值,但是一般删除缓存值较快,当其他线程再次读取时,发现缓存缺失就会从数据库中读取到最新值。因此对业务影响较小。


缓存雪崩是指大量的应用请求无法在redis缓存中进行处理,然后大量请求发送到数据库层,导致数据库层的压力激增。如果请求量很大,可能会导致数据库宕机或者故障,从而引发生产事故。缓存雪崩可以从原因和解决方案两方面进行学习。
缓存雪崩一般有两个原因,第一个原因,缓存中有大量的数据同时过期,导致大量请求无法得到处理,此时,应用访问数据发生缓存缺失,然后应用会把请求发送给数据库,从数据库中读取数据。如果此时并发请求量大,数据库压力会很大,影响正常应用,严重时可能导致数据库宕机。第二个原因,redis缓存实例发生故障宕机了,无法处理请求,从而导致短期内大量请求挤压到数据库层,一般来说单个redis实例的请求处理能力与单个数据库的请求处理能力相差近十倍甚至更多。从而导致数据库压力过大,严重时崩溃。
对于大量的数据同时过期导致缓存雪崩问题,有两种解决方案,第一种方案,给数据的过期时间增加一个较小的随机数,可以通过expire命令设置。第二种方案,服务降级,如果业务访问的是非核心数据,暂时停止从缓存中查询数据,直接返回预定义的信息,空值或者错误信息,如果业务访问的是核心数据,如果缓存缺失,继续从数据库中读取。
对于redis宕机导致缓存雪崩问题,最好的方法是从设计架构时考虑高可用问题,通过redis主从版或集群实现高可用,即使主节点异常了,从节点也能切换为主节点。继续提供缓存服务。如果实际情况无法实现高可用,可以退而求其次,可以在业务系统中实现服务熔断或者请求限流机制。服务熔断指的是在缓存发生雪崩时暂停应用对缓存系统的接口访问,从而降低对数据库的访问压力,从而防止造成更大的损害。但是暂停缓存系统的访问对业务应用影响较大,可能带给用户不好的体验。对于非核心业务可以采用这种方式,对于核心业务,建议采取限流而不是熔断。即在业务侧控制每秒进入系统的请求数,避免过多请求被发送到数据库造成数据库压力过大。

缓存击穿指的是某些访问频繁的热点数据无法在缓存中进行处理从而导致访问这些数据的大量请求被发送到后端数据库,从而造成数据库压力骤然增加,影响数据库正常运行。通常解决方法是对于访问频繁的热点数据不设置过期时间,使得对于热点数据的访问请求都能在缓存中正常处理,请求不会到达数据库层,从而避免对数据库造成影响。
缓存穿透指的是业务侧访问的数据既不在缓存中,也不再数据库中,当请求访问缓存时,发现缓存缺失,从而再去访问数据库,同样发现数据库中也没有要访问的数据。可以从缓存穿透发生的原因和解决方法两方面学习缓存穿透。
1.缓存穿透的原因:
缓存穿透发生一般有两种原因,第一,业务层误操作,将缓存中和数据库中的数据都误删除了。第二,恶意攻击,大量请求故意访问数据库中没有的数据,从而造成系统奔溃。
2.缓存穿透的解决方案:
针对缓存穿透,有三种解决方案,前两种通用,第三种主要针对恶意攻击。第一种,设置缓存空值或者缺失值。当发生缓存穿透时,为了防止大量请求发送给数据库层,可以针对查询的数据在缓存中设置一个空值或者设置一个缺省值,这样当后续请求再次进行查询时,就可以从缓存中读取空值或缺省值,返回给业务层。第二种,使用布隆过滤器。在数据写入数据库时,使用布隆过滤器作标记,当缓存缺失后,不是直接去数据库中查询数据,而是通过查询布隆过滤器快速判断数据是否存在,如果不存在,便无需去数据库中查询,这样,即使发生缓存穿透,大量请求也不会积压到数据库层,不会影响数据库的正常运行。第三种方案,在前端进行请求检测,对业务系统接收到的请求进行合法性检测,过滤恶意的请求。
redis的只读缓存和使用直写策略的读写缓存,都需要将数据同步写到后端数据库中。在只读缓存中,业务会直接修改数据库并将缓存中的数据标记为无效。他的优势是数据更新时效率较快,但是在数据再次被读取时会有一次缓存缺失,影响性能。在读写缓存中,业务应用需要同时修改缓存和数据库。这种在数据更新时由于需要保证数据一致性,需要有额外的开销,对性能有一定影响,但是当数据再次被读取时,可以直接命中,性能较好。
在只读缓存中对数据进行删改,需要在缓存中删除相应的缓存值,如果将删除缓存值更新为缓存值,不会导致缓存缺失,当下次数据再次被访问时,应用可以直接从缓存中读取数据,但是,需要保证缓存和数据库中数据一致,可以通过重试或者延时双删方法。因此需要在业务代码中增加额外的逻辑,这会增加一定的开销。
如何理解缓存雪崩,缓存击穿,缓存穿透呢。缓存雪崩指的是由于大量数据同时失效或者缓存服务器异常问题导致请求异常的现象。缓存击穿指的是由于热点数据失效导致请求异常的现象。缓存穿透指的是由于数据既不在缓存中也不在数据库中从而导致请求异常的现象,这种较缓存雪崩和缓存击穿更危险。

最近学习的内容是redis作为缓存使用时的类型,只读缓存还是读写缓存。以及由此衍生而出的数据一致性问题,缓存雪崩,缓存击穿,缓存穿透问题。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

