hadoop的项目结构
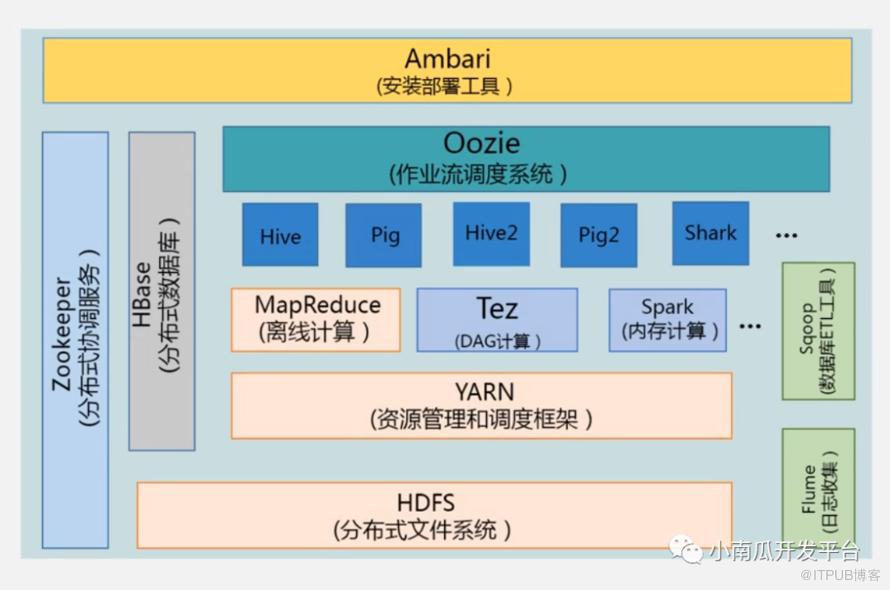
Hadoop的项目结构的主要部分,这些组件共同协作,为用户提供了大规模数据处理和存储的能力。
HDFS:这是Hadoop实现的一个分布式文件系统(Hadoop Distributed File System),它具有高容错性,被设计用来部署在低廉的硬件上。HDFS提供了高吞吐量来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。
MapReduce:这是Hadoop的框架最核心的设计之一,为海量的数据提供了计算。用户可以在不了解分布式底层细节的情况下,开发分布式程序,充分利用集群的威力进行高速运算和存储。
HBase:这是一个在Hadoop分布式文件系统之上构建的NoSQL数据库,提供高可靠性、高性能的随机读/写访问能力,并支持大规模的数据存储。
Hive:这是一个基于Hadoop的数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供简单的类SQL查询功能。
-
ZooKeeper:这是一个分布式应用程序协调服务,Hadoop使用它来维护集群的状态和协调工作。
YARN框架
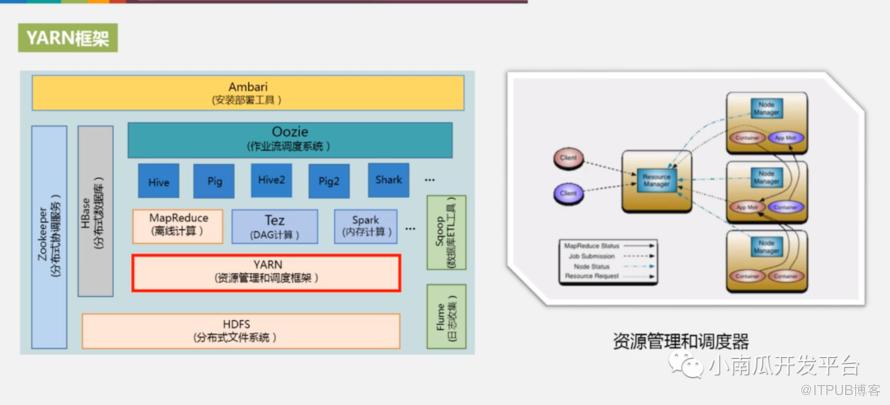
YARN可以为上层应用提供统一的资源管理和调度,并为集群在利用率、资源统一管理和数据共享等方面带来巨大好处。
YARN(Yet Another Resource Negotiator,另一种资源协调者)是Hadoop框架用于作业调度和集群资源管理的框架,它为运行于Hadoop上的程序提供服务器运算资源。YARN框架的出现弥补了Hadoop 1.x版本中MapReduce框架的不足,解决了Hadoop 1.x中JobTracker单点故障的问题,同时能够支持多种分布式运算框架,如Storm、Spark等可以在YARN上运行。
YARN的基本思想是将JobTracker(作业跟踪器)的两个主要功能(资源管理和作业调度/监控)分离。主要方法是创建一个全局的ResourceManager(RM)和若干个针对应用程序的ApplicationMaster(AM)。ResourceManager控制整个集群并管理应用程序向基础计算资源的分配。
Tez
Tez是Apache开源的支持DAG作业的计算框架,是支持HADOOP2.x的重要引擎。它源于MapReduce框架,核心思想是将Map和Reduce两个操作进一步拆分,分解后的元操作可以任意灵活组合,产生新的操作,这些操作经过一些控制程序组装后,可形成一个大的DAG作业。
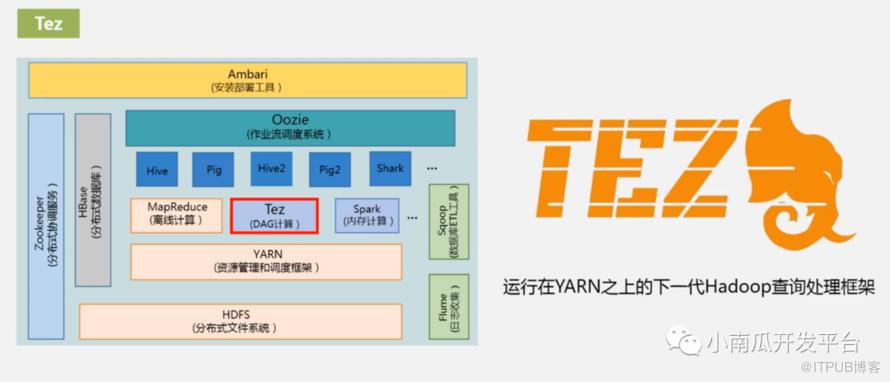
Tez可以将多个有依赖的作业转换为一个作业,从而大大提升DAG作业的性能。Tez已被Hortonworks用于Hive引擎的优化,经测试,性能提升约100倍。
MapReduce
MapReduce是一种编程模型,用于大规模数据集的并行运算。它具有以下特点:
易于编程:MapReduce通过简单的实现一些接口,可以完成一个分布式程序,这个程序可以分布到大量廉价的机器上运行。这个特点使得MapReduce编程变得非常流行。
良好的扩展性:当计算资源不足时,可以通过简单的增加机器来扩展MapReduce的计算能力。
高容错性:MapReduce设计的初衷是使程序能够部署在廉价的机器上,这就要求它具有很高的容错性。比如其中一台机器挂了,它可以把上面的计算任务转移到另外一个节点上运行,不至于这个任务运行失败,而且这个过程不需要人工参与,而是完全由Hadoop内部完成的。
-
适合PB级以上海量数据的离线处理:可以实现上千台服务器集群并发工作,提供数据处理能力。

总体来说,MapReduce具有简单易编程、良好的扩展性、高容错性、适合处理大规模数据集的特点。
hive
Hive是一个构建在Hadoop上的数据仓库,它提供了一个用于处理结构化数据的机制,具有以下特点:
类SQL的查询语言HiveQL:HiveQL和SQL非常类似,使得熟悉SQL的用户可以非常容易地使用Hive进行复杂的查询,无需学习新的语言。
可扩展性:Hive不仅自身提供了丰富的功能,还支持用户自定义其使用的数据类型、mapper和reducer脚本,以及自定义函数(普通函数、聚集函数等),这极大地扩展了Hive的功能。
高容错性:如果节点出现问题,Hive仍然可以保证SQL的执行。
-
支持PB级数据处理:Hive可以高效地对TB甚至PB级别的数据进行处理。
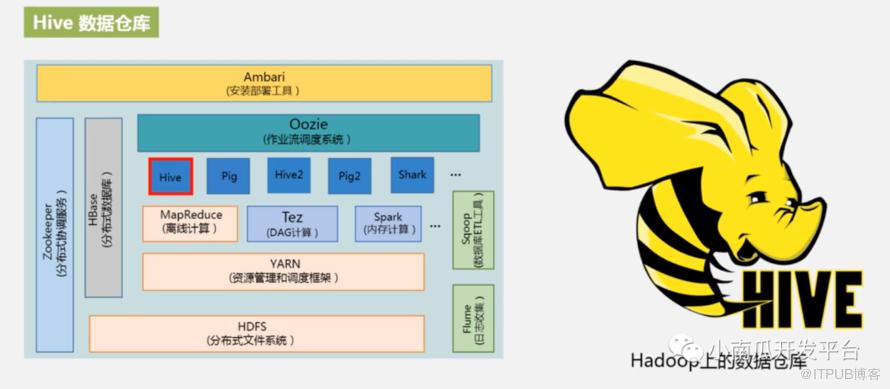
请注意,虽然Hive提供了类似SQL的查询语言,但它并不具备实时查询的能力,延迟较高,更适合于批量、海量数据的处理。同时,与传统的关系型数据库相比,Hive的查询速度可能较慢。
pig
Pig是一种用于大规模数据处理的编程语言,其特点如下:
专注于大量数据集分析:Pig可以用于处理大规模数据集,特别适合进行定制化的分析和查询。
运行在集群的计算架构上:Pig可以在Hadoop集群上运行,提供了一层抽象,简化了并行计算,使得普通用户也能进行复杂的查询和分析。
提供类似SQL的操作语法:Pig提供了一种类似SQL的操作语法,使得用户可以更加方便地表达数据处理逻辑。
-
开放源代码:Pig是开源的,社区支持较多,方便用户进行定制化的开发。
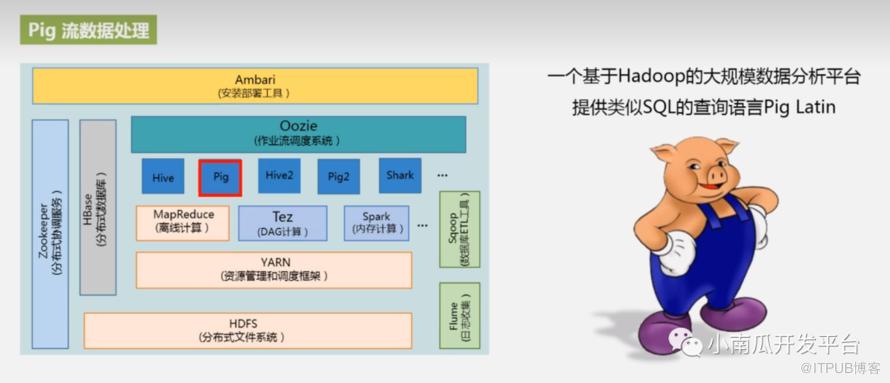
需要注意的是,尽管Pig提供了简化数据处理的功能,但仍然需要一定的编程知识和技能来使用。同时,针对不同的数据处理需求,不同的工具有各自的优势和适用场景,需要结合实际情况选择合适的工具。
Oozie作业流调度系统
Oozie是一个用于管理和调度Hadoop生态圈作业的工作流调度系统。它允许用户按照DAG(有向无环图)调度一系列的Map/Reduce、Hive等任务,通过时间(频率)和有效数据来触发当前的Oozie工作流。Oozie可以支持多种Hadoop作业(包括HDFS、MapReduce、Hive、StreamingMR、Loader、Spark、Distcp)以及系统类作业(例如Java与Shell)。
Oozie工作流(Workflow)是放置在控制依赖DAG(有向无环图)中的一组动作(Action)集合,控制依赖可确保后续操作在前面的操作已成功完成后才会启动。Oozie的协调作业(Coordinator)是通过时间(频率)和有效数据来触发当前的Oozie工作流。

Oozie是一个Java web应用程序,运行于Java servlet容器上,由Cloudera公司贡献给Apache。对于各种类型的Hadoop作业进行编排与调度,Oozie是一个重要的工具。
zookeeper
ZooKeeper是一个开放源码的分布式应用程序协调服务,是Hadoop和Hbase的重要组件,被广泛地应用于诸如Hadoop、HBase、Kafka和Dubbo等大型分布式系统中。它主要提供了诸如命名服务、配置服务、集群管理、分布式锁等分布式基础服务。
具体来说,ZooKeeper的作用包括:
配置维护:ZooKeeper可以集中管理配置,它使用Zab这种一致性协议来提供一致性。在分布式应用中,如果有很多服务器需要配置,那么使用ZooKeeper就很有用,可以实现在集中的地方修改配置,所有对这个配置感兴趣的都可以获得变更。
域名服务:在分布式环境中,为了通过域名访问系统,需要使用ZooKeeper。计算机不能直接使用域名,需要在每台机器里备有一份域名到IP地址的映射。这个映射可以在ZooKeeper上进行保存,使得我们可以直接通过域名来进行访问。
-
分布式同步:ZooKeeper作为一个分布式协调服务,可以协调多个分布式进程之间的活动。比如在一个分布式环境中,为了提高可靠性,集群的每台服务器上都部署着同样的服务。
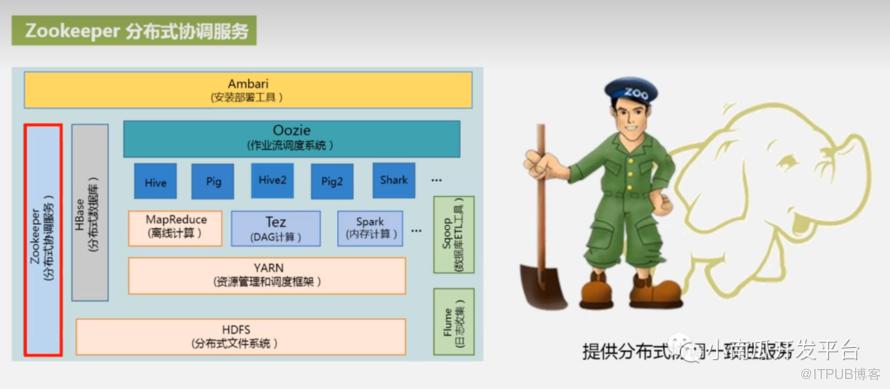
总的来说,ZooKeeper为分布式应用提供高效、高可用的分布式协调服务,是保证分布式系统正常运行的重要组件。
sqoop
Sqoop项目始于2009年,最早是作为Hadoop的一个第三方模块存在,后来为了让使用者能够快速部署,也为了让开发人员能够更快速的迭代开发,Sqoop独立成为一个Apache项目。
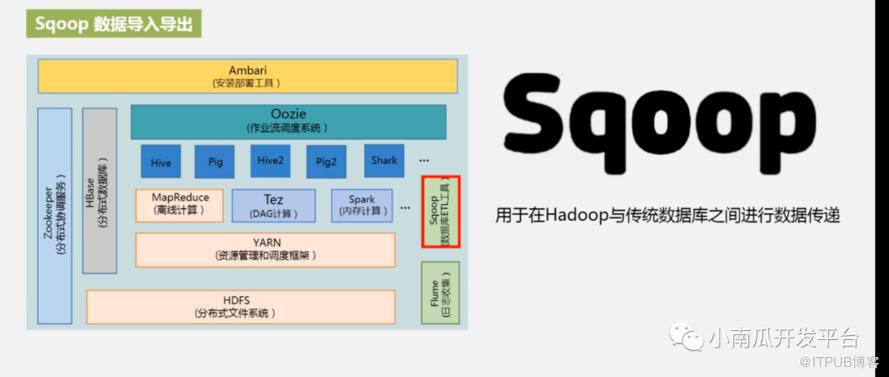
Sqoop是一款开源的数据迁移工具,主要用于在Hadoop(Hive)与传统的关系型数据库(如MySQL,Oracle,Postgres等)之间进行数据的传递。它可以将关系型数据库中的数据导入到Hadoop的HDFS中,也可以将HDFS的数据导入到关系型数据库中。
Sqoop的使用非常方便,它支持对数据库进行各种操作,如查看数据库和数据表,对数据进行导入和导出,甚至可以导入所有的表。用户最常使用的还是sqoop的export和import指令,用于将数据库和hadoop数据进行导出和导入。
Sqoop的架构非常简单,它整合了Hive、Hbase和Oozie,通过map-reduce任务来传输数据,从而提供并发特性和容错。Sqoop主要通过JDBC和关系数据库进行交互,理论上支持JDBC的database都可以使用sqoop和hdfs进行数据交互。
ambari
Ambari的作用主要是简化Hadoop以及相关大数据软件的使用,提供便捷的管理和监视工具。
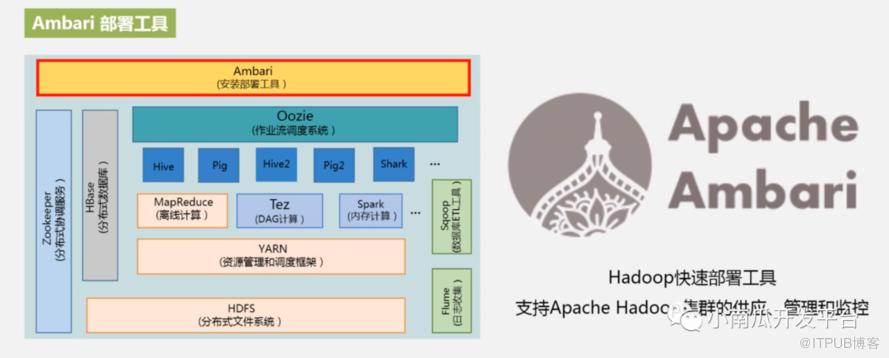
Apache Ambari是一种用于管理和监视Hadoop集群的开源工具。它提供了一个基于Web的用户界面,使用户可以轻松地安装、配置、管理和监视Hadoop集群中的各种组件和服务,包括HDFS、YARN、MapReduce、Hive、HBase、Zookeeper等。Ambari还提供了一组RESTful API,使开发人员可以与Ambari进行集成,并使用它来进行自动化管理和监视。
flume
Flume是一个功能强大的日志采集工具,可以帮助企业快速、可靠地采集、处理和存储大量数据,为业务决策提供有力支持。
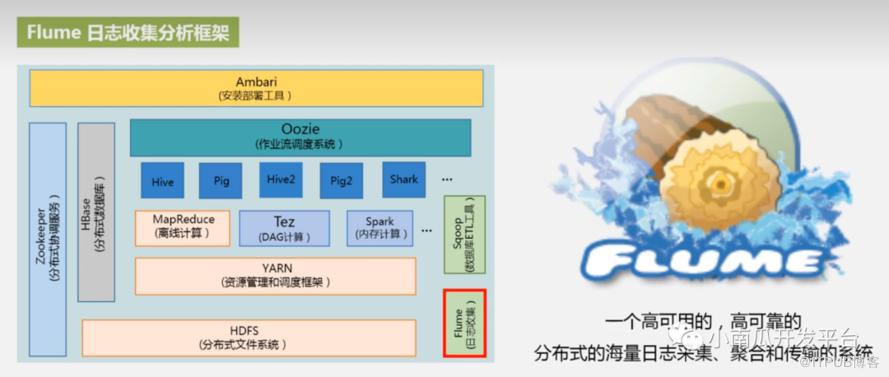
Flume是Apache基金会下的一个分布式、可靠、高可用的日志采集系统,主要用于从不同数据源(如Web服务器、数据库、应用程序等)中采集大量数据,并将其传输到Hadoop或其他存储系统中。Flume的主要作用是实现大规模数据采集和传输,实现数据的实时处理和分析,从而为企业提供更好的业务决策支持。
Flume可以高可靠性地采集、传输和存储大量数据,同时提供了定制化的数据接收方和数据处理能力,可以对数据进行简单的处理,并将处理后的数据写入各种数据接收方。此外,Flume还支持级联,可以合并多个Flume实例采集的数据,提高数据处理效率。
具体来说,Flume可以从不同数据源(如本地文件、实时日志、REST消息、Thift、Avro、Syslog、Kafka等)采集数据,并且可以定制数据接收方,将数据传输到目的地(如HDFS、HBase、Kafka等)。同时,Flume还提供了实时采集日志信息的能力,可以及时处理和分析大量数据。
hbase
HBase是一个基于Hadoop的分布式数据库,它是一个适合存储非结构化和半结构化的松散数据的高性能、高可靠、可伸缩的数据库。

HBase的主要作用包括:
存储和管理大规模数据:HBase支持非常大的数据集,数十亿行*数百万列的数据量级可以轻松应对,足以撑爆我们在J2EE阶段学习过的所有数据存储引擎。同时,HBase支持大数据量的随机、实时读写操作,在海量数据中,可以实现毫秒级的数据读写。这种强大的数据存储和管理能力,使得HBase能够应对大规模数据存储和处理的挑战。
实时数据处理:HBase从一开始就深度集成了Hadoop,并继承了Hadoop带来的强大的可扩展性。这意味着HBase可以基于廉价PC机组建庞大的应用集群,并且可以轻松融入到整个大数据生态圈中。HBase的数据是强一致性的,从CAP理论来看,HBase是属于CP的,这种设计可以让程序员不需要担心脏读、幻读这些事务最终一致性带来的问题。最重要的是,HBase的框架性能是足够高效的,经过很多大型商业产品的验证。例如,Facebook的整个消息流转的基础设施就构建于HBase之上。
-
提供键值(KV)数据库接口:Hbase是一个键值(KV)数据库,访问接口提供了原生Java API,可以通过shell命令、thrift gateway方式、rest gateway方式来访问。同时,HBase可以通过PIG、hive来提供类似SQL类型的接口,使得对数据的操作更加灵活和方便。
分布式锁
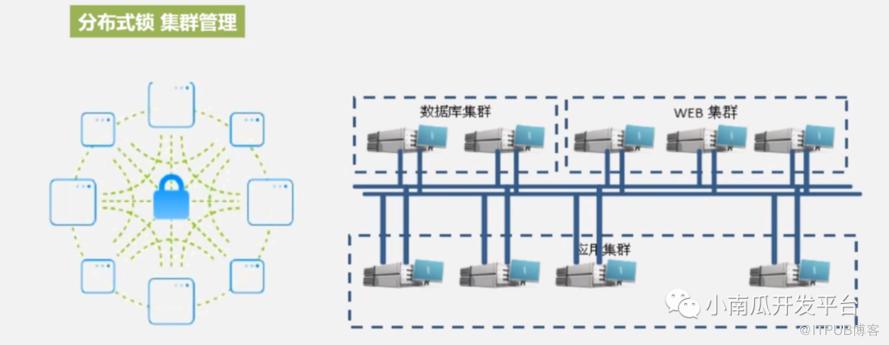
分布式锁是一种跨进程的,跨机器节点的一种互斥锁,用于保证在多个机器节点对共享资源访问的一个排他性。类似线程锁,分布式锁的生命周期是多进程多机器节点,本质上都要满足锁的基本特性,包括排他性、可重入性和锁的获取和释放的方法、锁的失效机制以避免死锁的问题。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

