一、什么是无监督学习?
机器学习的一种方法,没有给定事先标记过的训练示例,自动对输入的数据进行分类或分群。
优点:
①算法不受监督信息的约束,可能考虑到新的信息
②不需要标签数据,极大程度扩大数据样本
主要应用:
聚类分析,关联规则,维度缩减
一、什么是无监督学习?
机器学习的一种方法,没有给定事先标记过的训练示例,自动对输入的数据进行分类或分群。
优点:
①算法不受监督信息的约束,可能考虑到新的信息
②不需要标签数据,极大程度扩大数据样本
主要应用:
聚类分析,关联规则,维度缩减
二、什么是聚类分析?
聚类分析又称为群分析,根据对象某些属性的相似度,将其自动划分为不同类别。
聚类分析的方法众多,常用的包括以下几种:
基于划分的方法:如K-means算法,通过迭代将样本分组成k个簇,使得每个样本与其所属类的中心或均值的距离之和最小。
基于分层的方法:如层次聚类法,通过逐步合并或分解数据集来形成层次结构,最终得到多个聚类。
基于密度的方法:如DBSCAN算法,根据数据点的密度来发现任意形状的簇,并将高密度区域的数据点划分为同一簇。
基于网格的方法:如STING算法,利用网格单元保存数据统计信息,从而实现多分辨率的聚类。
基于模型的方法:如高斯混合模型(GMM),通过假设数据是由多个高斯分布混合而成的,从而进行聚类分析。
三、KMeans、KNN、Mean-shift算法
K-均值算法:以空间中K个点为中心进行聚类,对最靠近他们的对象归类,是聚类算法中最为基础但也最为重要的算法
1.特点:
KMeans是一种无监督的学习方法,用于发现数据内在的结构。
它的基本思想是将n个实例分成k个簇,使得同一簇内数据相似度高而不同簇之间数据相似度低。
算法简单、快速,对处理大数据集保持可伸缩性和高效率。
当簇近似为高斯分布时,KMeans算法的效果较好。
2.执行方式:
一开始会定义n个中心点,然后计算各数据点与中心点的距离。
判断数据点属于哪一类,主要看当前数据点离哪一个中心点的距离最近。
所有数据点分类完后,需要更新各个类的中心点,然后不断重复上述操作直至中心点不再变化。
3.优点:
1、原理简单、实现容易、收敛速度快
2、参数少、方便使用
4、缺点:
1、必须设置数量
2、随机选择初始聚类中心,结果可能缺乏一致性
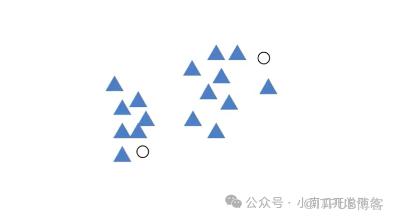
算法流程:
1、选择聚类的个数K
2、确定聚类中心
3、根据点到聚类中心聚类确定各个点所属类别
4、根据各个类别数据更新聚类中心
5、重复以上【3、4】步骤直到收敛(中心点不再变化)
2、KNN算法
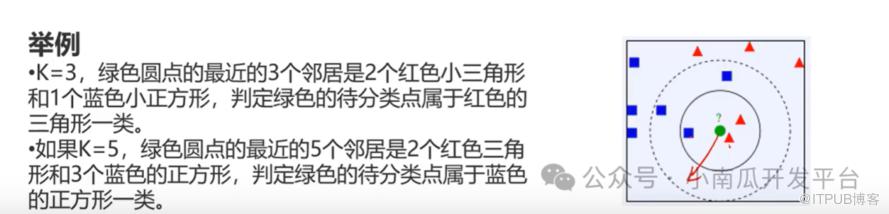
给定一个训练数据集,对新的输入实例,在训练数据集中找到与该实例最邻近的K个实例,这K个实例的多数属于某个类,就是把该输入实例分类到这个类中
1.特点:
KNN是一种基于最近邻的分类和回归方法。
它是一种无参数的方法,不需要假设数据服从某种特定的分布或者确定模型参数。
KNN是一种惰性的方法,不需要在训练阶段进行显式的学习,而是在预测阶段才进行计算。
KNN可以处理非线性可分的数据,但也可能受到噪声和异常值的影响。
2.执行方式:
对于给定的待分类样本,根据它与已知类别的训练样本之间的距离,找出最近的K个邻居。
根据这些邻居的类别进行多数表决或加权表决,从而确定样本的类别。
均值漂移算法:一种基于密度梯度上升的聚类算法(沿着密度上升方向寻找聚类中心点)

特点:
Mean-shift是一个基于密度梯度上升的聚类算法,沿着密度梯度上升寻找聚类中心点。
它是一个无监督学习算法,不需要事先制定类别个数k。
Mean-shift算法在很多领域都有成功应用,例如图像平滑、图像分割、物体跟踪等。
执行方式:
随机选择一个点作为中心点A,并定义半径r。
找出与A距离在r内的所有节点记为集合S。
计算偏移量中心节点的均值偏移量,不断移动中心点A直至收敛。
算法流程:
1、随机选择未分类点作为中心点
2、找出离中心点距离在带宽之内的点,记作集合S
3、计算从中心点到集合S中每个元素的偏移向量M
4、中心点以向量M移动
5、重复步骤2-4,直到收敛
6、重复1-5直到所有的点都被归类
7、分类:根据每个类,对每个点的访问频率,取访问频率最大的那个类,作为当前点集的所属类
Kmeans算法和KNN算法对比
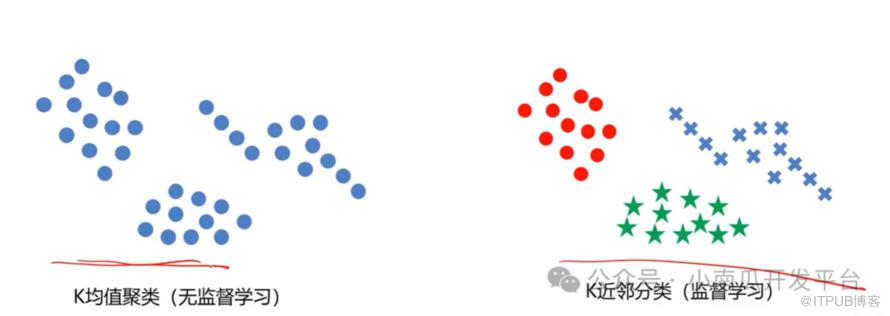
在数据划分任务中,这三种算法各有优劣:
KMeans算法适用于大数据集和高斯分布的簇,但需要对初值敏感,且必须事先给出要生成的簇的数目k。
KNN算法简单直观,但计算量大,对噪声和异常值敏感。
Mean-shift算法不需要事先制定类别个数k,但可能受到核函数和带宽选择的影响
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

北京盛拓优讯信息技术有限公司. 版权所有 京ICP备16024965号-8 北京市公安局海淀分局网监中心备案编号:11010802021510 niuxiaotong@pcpop.com 17352615567 未成年人举报专区
广播电视节目制作经营许可证(京) 字第1234号 中国互联网协会会员
违法和不良信息举报电话:18101376593
