一、机器学习
1、什么是机器学习?
前言
本文教程用到了python语言及在anaconda环境下实现,因此需要您具备基本的python语言理解能力以及安装anaconda环境。
相关安装可参考
【AI人工智能系列】1.环境搭建:阿里云服务器centos安装anaconda
一、机器学习
1、什么是机器学习?
机器学习是一种实现人工智能的方法,从数据中寻找规律,建立关系,根据建立的关系去解决问题。
2、机器学习的应用场景?
机器学习是实现人工智能的主流方法
数据挖掘、计算机视觉、自然语言处理、证券分析
医学诊断、机器人、DNA测序。。。。
3、实现机器学习的基本框架
将训练数据喂给计算机,计算机自动求解数据关系,在新的数据上做出预测或给出建议。
4、机器学习的类别?
监督学习:训练数据包括正确的结果
无监督学习:训练数据不包括正确的结果
半监督学习:训练数据包括少量正确的结果
强化学习:根据每次结果收获的奖惩进行学习,实现优化
5、监督学习的算法
线性回归、逻辑回归、决策树、神经网络、卷积神经网络、循环神经网络
6、scikit-learn
python中专门针对机器学习应用的一款开源框架(算法库),可以实现数据预处理、分类、回归、降维、模型选择等常用的机器学习算法。
特点:继承了机器学习中各类成熟的算法、容易安装使用
不支持python之外的语言,不支持深度学习和强化学习.
https://scikit-learn.org/stable/index.html
7、分类方法
逻辑回归、KNN近邻模型、决策树、神经网络
8、线性回归
回归分析:根据数据,确定两种或两种以上变量间相互依赖的定量关系.
根据变量数可以分为:一元回归y=f(x)、多元回归y=f(x1,x2,...xn)
根据函数关系可以分为:线性回归y=ax+b, 非线性回归y=ax^2+bx+c
线性回归:回归分析中,变量与因变量存在线性关系,即y=ax+b
9、逻辑回归
用于解决分类问题的一种模型。根据数据特征或属性,计算其归属于某一类别的概率P(X),
根据概率数值判断其所属类别。主要应用场景:二分类问题
二、运用逻辑回归模型实现二分类问题实战
需求:逻辑回归模型预测考试通过情况,建立逻辑回归模型,预测Exam1=75,Exam2=60时,该同学再Exam3中是通过还是不通过
1、首先准备一份训练数据examdata1.csv
Exam1 Exam2 pass75 85 162 70 090 88 155 60 085 90 170 75 160 55 088 92 150 45 095 90 178 82 168 65 082 87 158 52 092 89 1
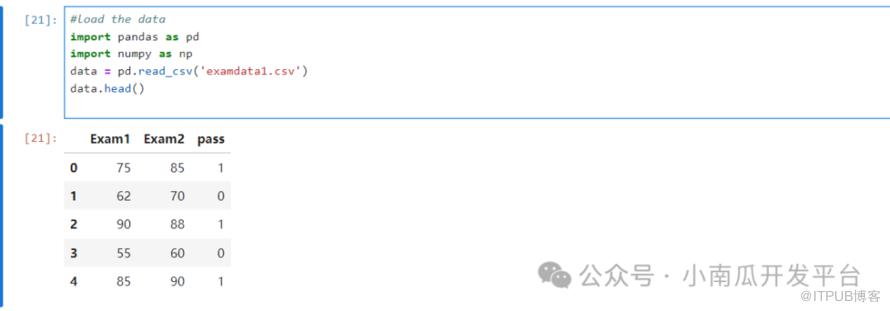
2、编写代码加载数据
import pandas as pdimport numpy as npdata = pd.read_csv('examdata1.csv')data.head()
3、可视化显示
%matplotlib inlinefrom matplotlib import pyplot as pltfig1 =plt.figure()plt.scatter(data.loc[:,'Exam1'],data.loc[:,'Exam2'])plt.title('Exam1-Exam2')plt.xlabel('Exam1')plt.ylabel('Exam2')plt.show()

4、只显示考试通过的学生
fig2 =plt.figure()plt.scatter(data.loc[:,'Exam1'][mask],data.loc[:,'Exam2'][mask])plt.title('Exam1-Exam2')plt.xlabel('Exam1')plt.ylabel('Exam2')plt.show()

5、通过不同颜色展示通过和不通过的考生
fig3 =plt.figure()passed = plt.scatter(data.loc[:,'Exam1'][mask],data.loc[:,'Exam2'][mask])failed = plt.scatter(data.loc[:,'Exam1'][~mask],data.loc[:,'Exam2'][~mask])plt.title('Exam1-Exam2')plt.xlabel('Exam1')plt.ylabel('Exam2')plt.legend((passed,failed),('passed','failed'))plt.show()

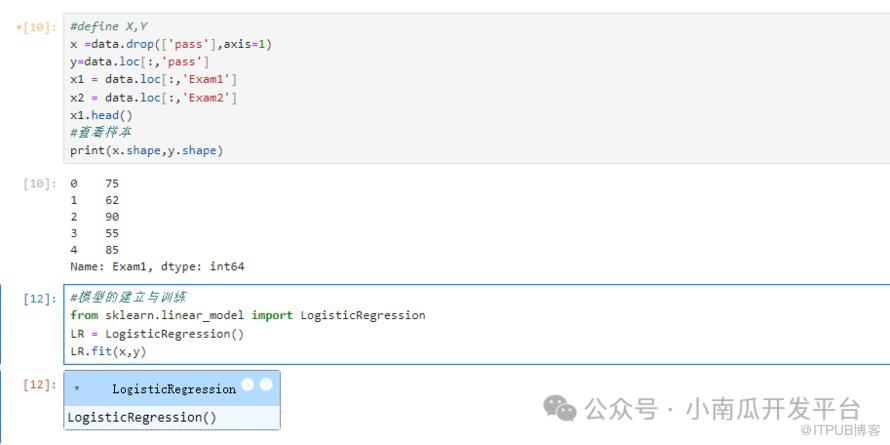
6、通过sklearn框架建立和训练模型
#define X,Y#去掉数据的pass列数据,将第exam1,exam2的数据g给到x1x =data.drop(['pass'],axis=1)#pass列的数据给到yy=data.loc[:,'pass']#获取exam1列的数据给到x1x1 = data.loc[:,'Exam1']#获取exam2的数据给到x2x2 = data.loc[:,'Exam2']#展示exam1列的数据x1.head()#查看样本print(x.shape,y.shape)#模型的建立与训练from sklearn.linear_model import LogisticRegressionLR = LogisticRegression()LR.fit(x,y)
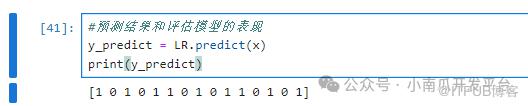
7、预测结果
#预测结果y_predict = LR.predict(x)print(y_predict)
8、评估模型表现
#评估模型from sklearn.metrics import accuracy_scoreaccuracy = accuracy_score(y,y_predict)#输出模型评估值print(accuracy)

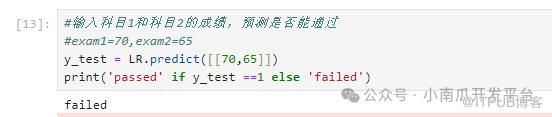
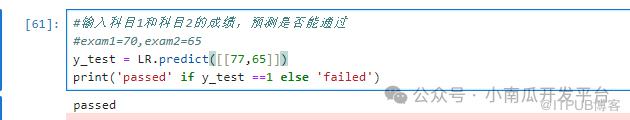
9、输入exam1和exam2的成绩,预测exam3是否能通过
#exam1=70,exam2=65时,exam3预测为不通过
#输入科目1和科目2的成绩,预测是否能通过#exam1=70,exam2=65y_test = LR.predict([[77,65]])print('passed' if y_test ==1 else 'failed')
#exam1=77,exam2=65时,exam3预测为通过
#输入科目1和科目2的成绩,预测是否能通过#exam1=77,exam2=65y_test = LR.predict([[77,65]])print('passed' if y_test ==1 else 'failed')
三、建立一阶函数
1、一阶边界函数
#获取模型的系数LR.coef_theta0 =LR.intercept_theta1,theta2 = LR.coef_[0][0],LR.coef_[0][1]print(theta0,theta1,theta2 )x2_new = -(theta0+theta1*x1)/theta2print(x2_new)#一阶边界函数fig4 =plt.figure()plt.plot(x1,x2_new)plt.show()

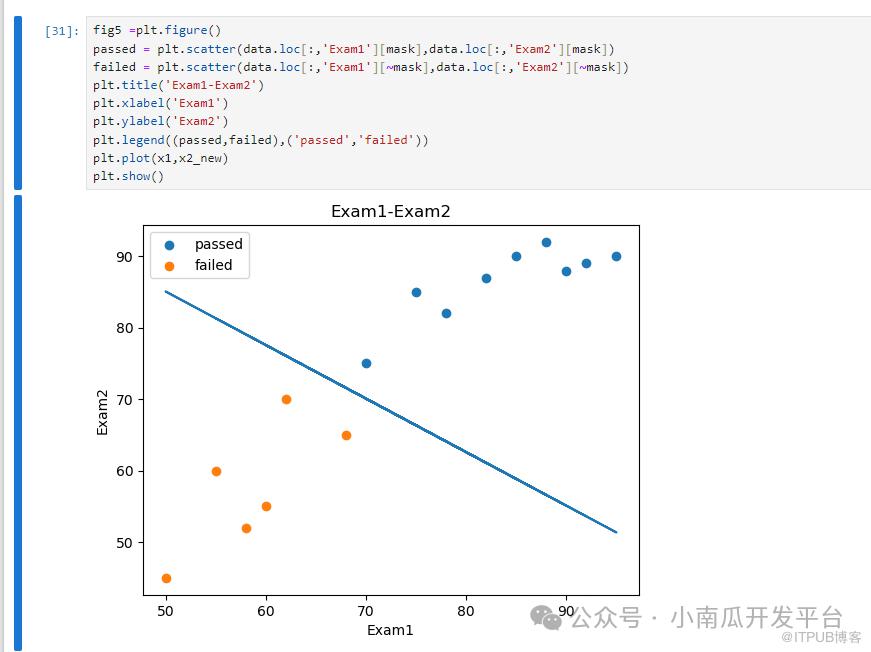
2、可视化一阶边界函数和考试通过情况
fig5 =plt.figure()passed = plt.scatter(data.loc[:,'Exam1'][mask],data.loc[:,'Exam2'][mask])failed = plt.scatter(data.loc[:,'Exam1'][~mask],data.loc[:,'Exam2'][~mask])plt.title('Exam1-Exam2')plt.xlabel('Exam1')plt.ylabel('Exam2')plt.legend((passed,failed),('passed','failed'))plt.plot(x1,x2_new)plt.show()
四、建立二阶边界函数
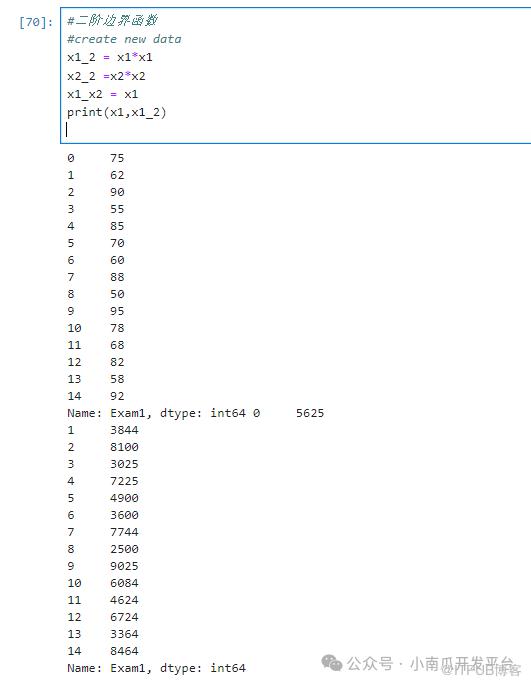
1、创建一份新数据
#二阶边界函数#create new datax1_2 = x1*x1x2_2 =x2*x2x1_x2 = x1print(x1,x1_2)
2、组织新数据
x_new = {'x1':x1,'x2':x2,'x1_2':x1_2,'x2_2':x2_2,'x1_x2':x1_x2}x_new =pd.DataFrame(x_new)print(x_new)

3、建立逻辑模型与训练
LR2 = LogisticRegression()LR2.fit(x_new,y)

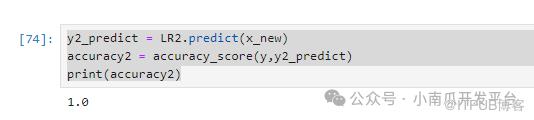
4、评估模型
评估系数为1,效果非常好
y2_predict = LR2.predict(x_new)accuracy2 = accuracy_score(y,y2_predict)print(accuracy2)
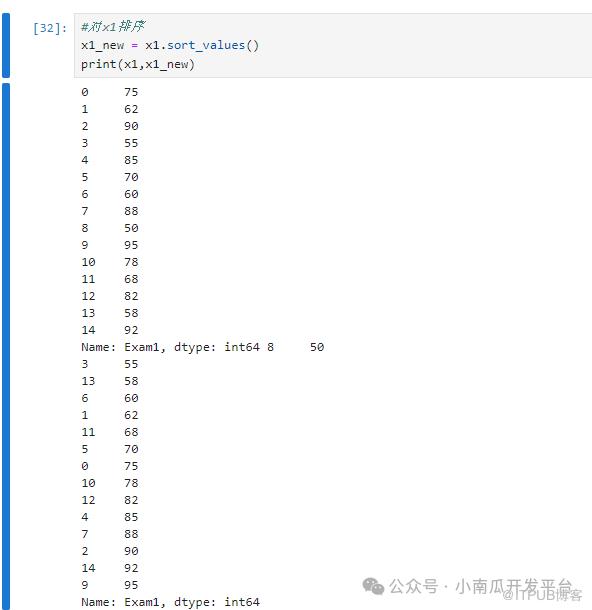
5、建立二阶函数
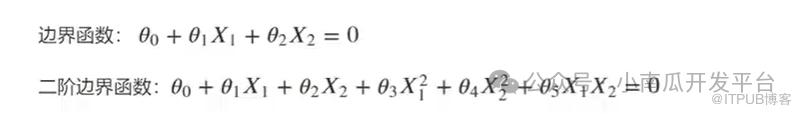
#对x1排序,确保x的数据是递增的,x1_new = x1.sort_values()print(x1,x1_new)
#边界值theta0 = LR2.intercept_theta1 ,theta2,theta3,theta4,theta5 =LR2.coef_[0][0],LR2.coef_[0][1],LR2.coef_[0][2],LR2.coef_[0][3],LR2.coef_[0][4]a = theta4b=theta5*x1_new+theta2c=theta0+theta1*x1_new+theta3*x1_new*x1_new#边界x2_new_boundary = (-b+np.sqrt(b*b-4*a*c))/(2*a)#print(theta0,theta1 ,theta2,theta3,theta4,theta5)#print(x2_new_boundary)fig6= plt.figure()passed = plt.scatter(data.loc[:,'Exam1'][mask],data.loc[:,'Exam2'][mask])failed = plt.scatter(data.loc[:,'Exam1'][~mask],data.loc[:,'Exam2'][~mask])plt.plot(x1_new,x2_new_boundary)plt.title('Exam1-Exam2')plt.xlabel('Exam1')plt.ylabel('Exam2')plt.legend((passed,failed),('passed','failed'))plt.show()

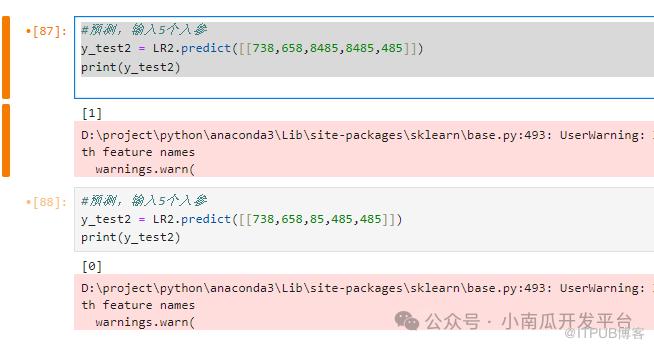
#预测,输入5个入参y_test2 = LR2.predict([[738,658,8485,8485,485]])print(y_test2)
五、总结
逻辑回归模型(Logistic Regression)是一种广泛用于二分类问题的统计方法。它通过将线性回归模型的输出映射到(0, 1)区间内,从而得到属于某一类别的概率。
解释性强:
逻辑回归模型输出的结果是概率,便于理解和解释。
特征变量的系数(权重)可以直接反映该变量对结果的影响方向和程度。
计算效率高:
逻辑回归模型的训练过程相对简单,计算速度快,适用于大规模数据集。
模型复杂度较低,易于实现和调试。
模型简单且直观:
逻辑回归模型是线性模型的一种扩展,形式简单,容易理解和应用。
适用于特征之间线性关系较强的情况。
输出可解释的概率值:
模型不仅能预测类别,还能给出属于某个类别的概率,这在某些应用场景中非常有用,比如信用评分、疾病诊断等。
鲁棒性较好:
对缺失值和异常值有一定的容忍能力,通过适当的预处理,可以较好地处理这些问题。
线性关系限制:
逻辑回归假设特征与目标变量之间存在线性关系,对于非线性关系的数据,逻辑回归的表现可能较差。
需要通过特征工程(如多项式特征、特征变换等)来增强模型的非线性表达能力。
特征空间限制:
逻辑回归在高维稀疏特征空间中表现不佳,因为模型依赖于特征之间的线性组合。
对于特征维度特别高或特别稀疏的数据集,如文本分类中的词袋模型,逻辑回归可能不如其他模型(如支持向量机、随机森林、神经网络等)有效。
对多重共线性的敏感:
逻辑回归对多重共线性较为敏感,如果特征之间存在严重的多重共线性,可能导致模型不稳定、系数估计不准确。
分类边界限制:
逻辑回归只能生成线性决策边界,对于复杂的非线性分类问题,可能需要更复杂的模型(如核方法、神经网络)来生成非线性决策边界。
过拟合风险:
在数据集较小或特征较多时,逻辑回归存在过拟合的风险,需要通过正则化(如L1正则化、L2正则化)来防止过拟合。
逻辑回归模型在二分类问题中具有解释性强、计算效率高、模型简单且直观等优点,但同时也存在线性关系限制、特征空间限制、对多重共线性的敏感、分类边界限制以及过拟合风险等缺点。在实际应用中,需要根据具体的数据集和问题需求来选择合适的模型
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

北京盛拓优讯信息技术有限公司. 版权所有 京ICP备16024965号-8 北京市公安局海淀分局网监中心备案编号:11010802021510 niuxiaotong@pcpop.com 17352615567 未成年人举报专区
广播电视节目制作经营许可证(京) 字第1234号 中国互联网协会会员
违法和不良信息举报电话:18101376593
