一、大数据的两大核心技术
分布式存储:这种技术主要用于解决如何存储海量数据的问题。具体的方法有很多种,比如GFS、HDFS、BigTable和HBase等,它们都可以实现数据的分布式存储。另外,NoSQL也是一种非常流行的分布式数据库技术。
-
分布式处理:这种技术主要用于解决如何处理海量数据的问题。最典型的分布式处理技术就是MapReduce。

二、HDFS的相关概念
HDFS:全称Hadoop Distributed File System,是Hadoop分布式文件系统,是Hadoop的核心组件之一,作为最底层的分布式存储服务而存在。
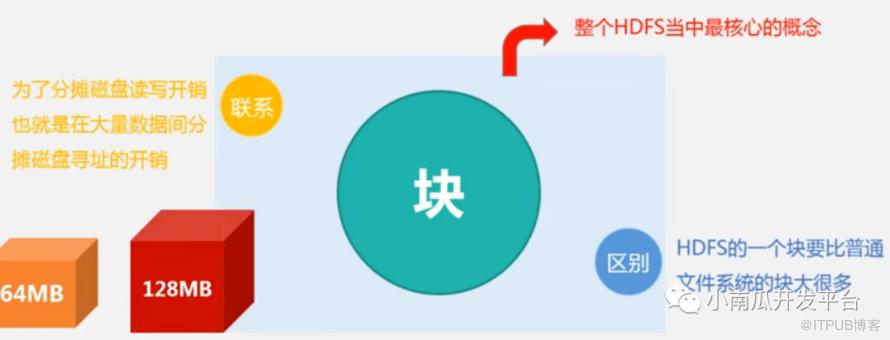
数据块:HDFS中的文件被切分成多个数据块(block),每个数据块大小通常为64MB或128MB,可以在集群中的多个数据节点上存储。
NameNode和DataNode:在HDFS中,有两大类节点,即NameNode和DataNode。NameNode是负责管理文件系统的元数据,比如文件名、文件大小、文件的副本数等信息。而DataNode则是实际存储数据的节点,它把一个或多个数据块存储在本地文件系统上。
Secondary NameNode:Secondary NameNode是NameNode的备用节点,主要用于备份NameNode的状态信息。当NameNode发生故障时,Secondary NameNode可以协助进行数据恢复。
-
HDFS设计目标:故障检测和自动快速恢复是HDFS的核心架构目标。HDFS被设计成适合批量处理,而不是用户交互式的,更注重数据访问的高吞吐量。
三、HDFS文件系统的结构组成
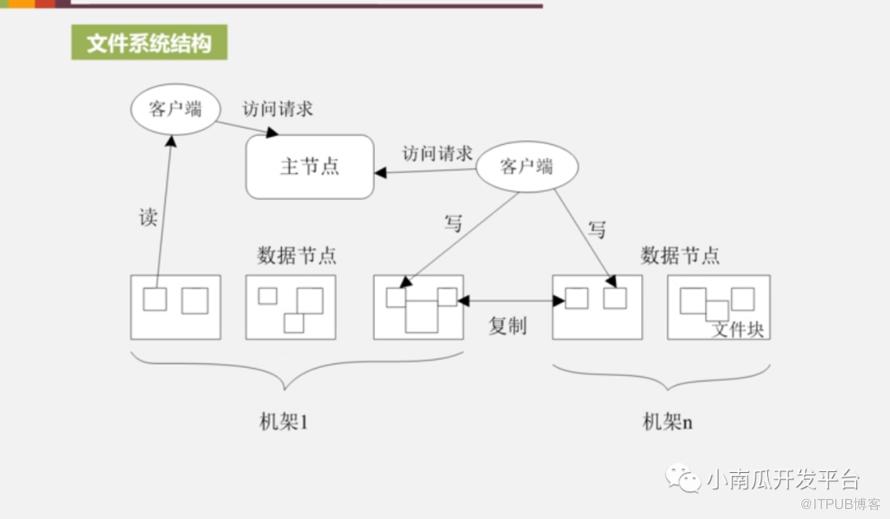
HDFS是一个主从结构模型,其真正的集群包括一个Namenode和若干数目的Datanode。
Client:这是用户接口,它负责将文件切分成数据块,并使用这些数据块进行存储和访问。Client还负责定期配合fsimages和fsedits,将数据块的信息推送给NameNode。在紧急情况下,Client甚至可以帮助辅助NameNode。
Namenode:这是中心服务器,负责管理文件系统的命名空间。具体来说,它在内存中维护着命名空间的最新状态,并持久化文件(fsimage和edit)进行备份,防止数据丢失。Namenode还负责管理客户端对文件的访问,比如权限验证等。在HDFS集群中,只有一个Namenode来负责所有元数据的管理工作。
Datanode:这些节点真正负责管理客户端的读写请求。在Namenode的统一调度下,Datanode进行数据块的创建、删除和复制等操作。数据块实际上都是保存在Datanode本地的Linux文件系统中的。每个Datanode会定期的向Namenode发送数据,报告自己的状态(我们称之为心跳机制)。
Secondary NameNode:这个节点可以看作是NameNode的辅助,主要负责对Namenode的状态进行检查和恢复。当Namenode发生故障时,Secondary NameNode可以协助进行数据恢复。但是,Secondary NameNode在正常情况下会充当普通Datanode的角色。
四、HDFS实现的目标
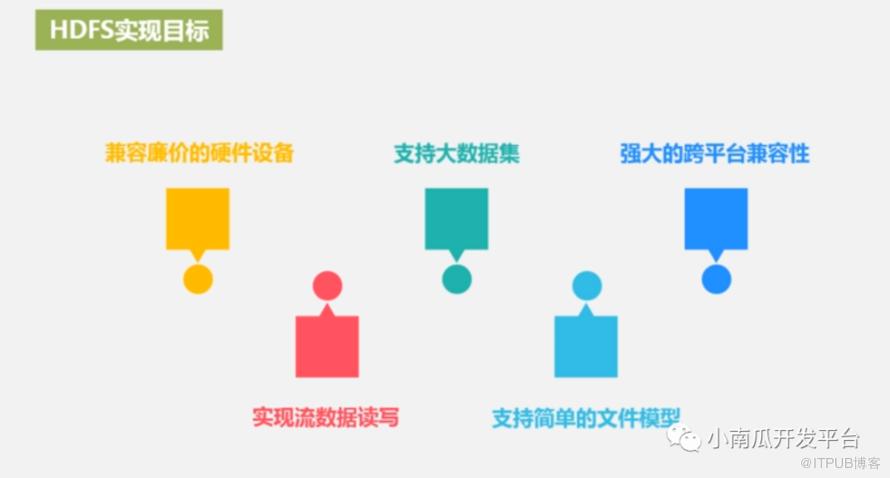
检测和快速恢复硬件故障:硬件故障是计算机常见的问题。由于整个HDFS系统由数百甚至数千个存储着数据文件的服务器组成,因此故障的检测和快速自动恢复是HDFS的一个核心目标。
流式的数据访问:HDFS使应用程序流式地访问它们的数据集。它被设计成适合进行批量处理,而不是用户交互式处理。因此,它重视数据吞吐量,而不是数据访问的反应速度。
简化一致性模型:大部分的HDFS程序对文件的操作需要一次写入,多次读取。一个文件一旦经过创建、写入、关闭就不需要修改了。这个假设简化了数据一致性问题和高吞吐量的数据访问问题。
通信协议:所有的通信协议都是在TCP/IP协议之上的。一个客户端和明确配置了端口的名字节点建立连接之后,它和名字节点的协议便是客户端协议。数据节点和名字节点之间则用数据节点协议。
五、HDFS自身的局限性
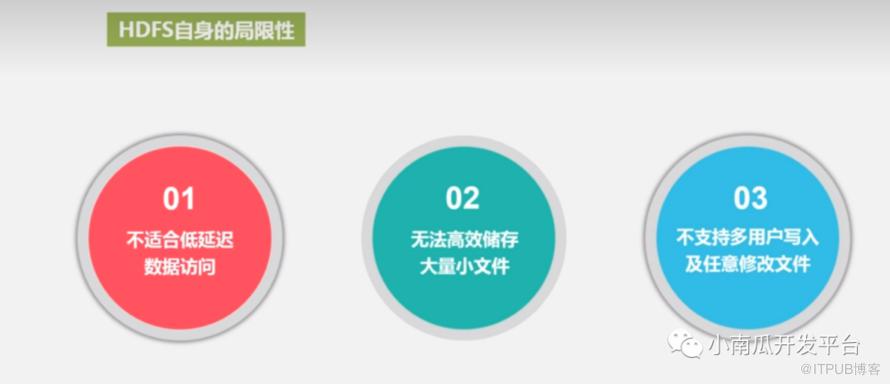
不适合低延时数据访问:例如毫秒级别的存储数据,HDFS目前还无法做到。
无法高效存储大量小文件:存储大量小文件会占用NameNode大量的内存存储文件、目录和块信息,而且小文件存储的寻址时间会超过读取时间,这违反了HDFS的设计目标。
不支持文件并发写入和随机修改:在HDFS中,一个文件只能有一个写操作,不允许多个线程同时写入。同时,它仅支持数据追加(append)追加,不支持文件的随机修改。
无法共享访问:在HDFS中,一个集群中的所有节点都是Hadoop实例的一部分。这意味着任何用户都可以访问Hadoop集群中的所有数据。因此,在某些情况下,这可能不是一个优点,尤其是当需要更高级别的数据安全性或隐私时。
-
对数据一致性要求严格:在大多数情况下,HDFS用于批量处理大量数据,而不是用于实时数据处理。因此,对于一些需要实时响应的应用程序来说,可能会感觉HDFS的反应速度不够快。
尽管存在这些局限性,但HDFS仍然是一个非常强大的工具,为大数据处理提供了许多重要的优势。在考虑是否使用HDFS时,最好根据您的特定需求和情况来确定。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

