一、HDFS的存储模式
在HDFS中,所有的文件都被抽象成为block块进行存储,而不管文件的大小,都是以block块的统一大小和形式进行存储,方便分布式文件系统对文件的管理。在Hadoop1中,文件的block块默认大小是64M,而在Hadoop2中,文件的block块大小默认是128M。不过,block块的大小可以通过hdfs-site.xml中的配置文件进行指定。
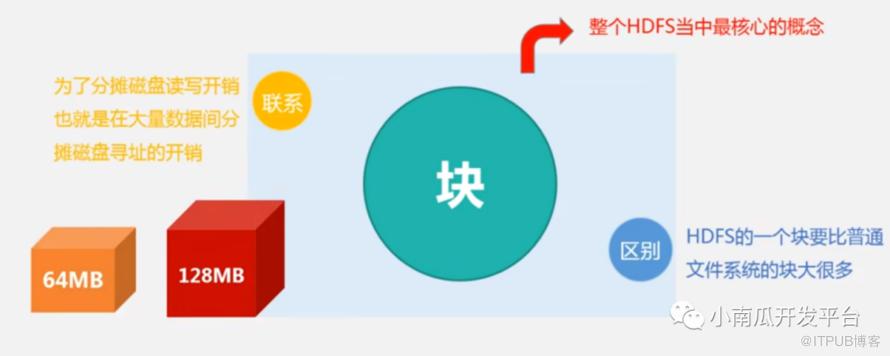
HDFS的块存储模式是它一个重要的特性。
二、HDFS的块存储模式设计主要原因
高容错性:如果存储节点出现故障,里面的数据文件可以被转移到一个新的节点机器中,其他节点可以代替其完成节点存储工作。由于是分布式的,可以拓展很多节点(机器),增强了系统的容错性和稳定性。
支持高并发访问:一次写入、多次读取是HDFS非常重要的特点,它降低了对并发控制的要求,简化了数据聚合性,支持高吞吐量访问。这是大数据系统的一个非常重要的指标,吞吐量高意味着能处理的数据量大。
方便数据复制和备份:HDFS的块存储模式方便数据复制和备份,一个数据块可以被复制到不同的节点,从而防止数据丢失。
易于管理:采用块存储模式,便于进行数据管理和维护,如数据备份、恢复、迁移等。
与本地文件系统的隔离:HDFS采用块存储模式,与本地文件系统隔离,使得数据的存储和管理更加安全和可靠。
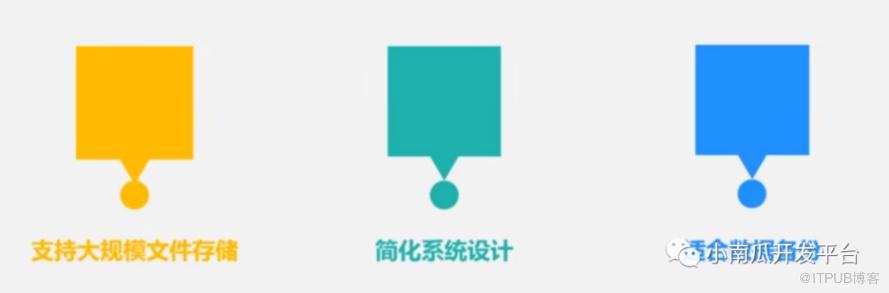
HDFS的块存储模式是为了提高系统的容错性、并发访问能力以及方便数据管理和维护等目的而设计的。如果块过大会导致MapReduce就一两个任务在执行完全牺牲了MapReduce的并行度,发挥不了分布式并行处理的效果。
三、HDFS的两大组件
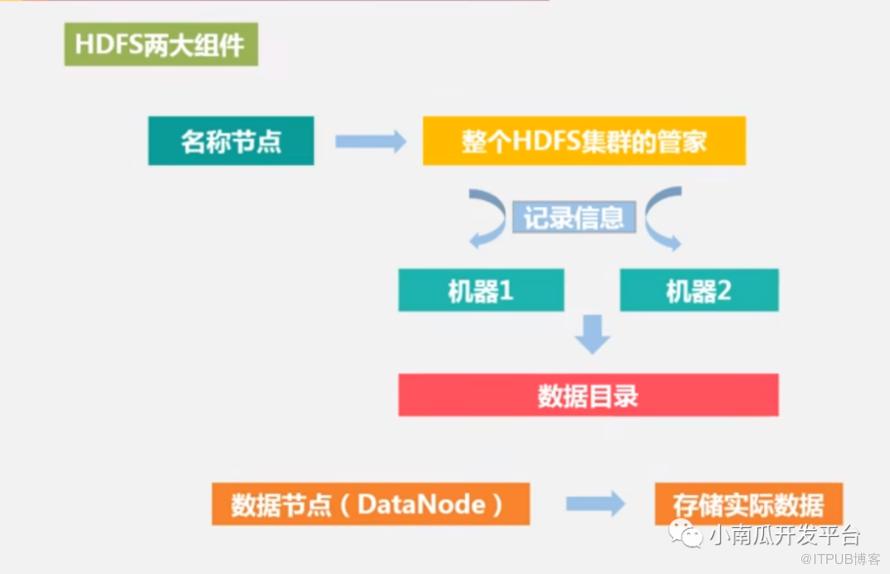
HDFS的两大组件是NameNode和DataNode。
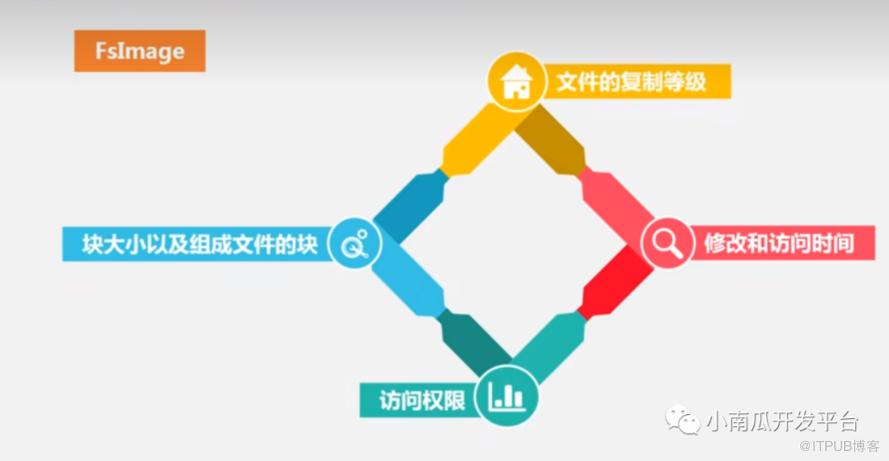
NameNode是HDFS的中央管理器,负责维护文件系统的命名空间并控制文件的访问。它存储文件的元数据,如文件名、文件目录结构、文件的访问权限和块列表等。
DataNode是存储实际数据块的节点。每个DataNode都存储文件系统的一部分数据。它们向NameNode报告它们所存储的块信息,并接收来自客户端和其他DataNode的请求。在HDFS中,DataNode的数量通常比NameNode多,这样可以增加系统的存储容量和并发处理能力。
四、关于NameNode
NameNode是HDFS(Hadoop Distributed File System)中的核心节点。
作用:
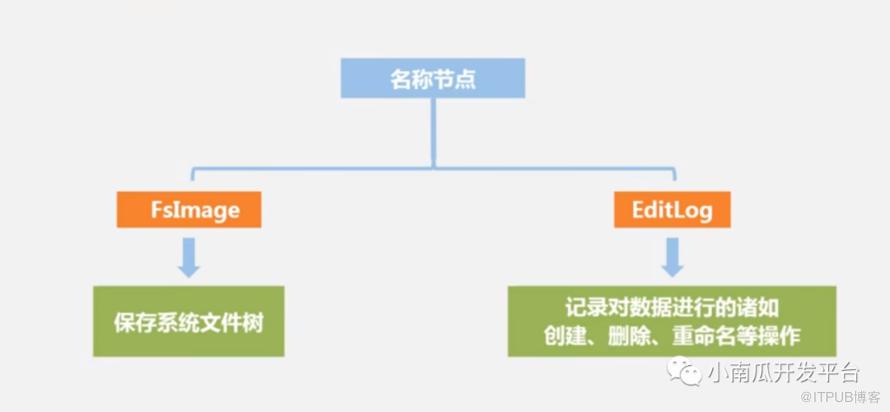
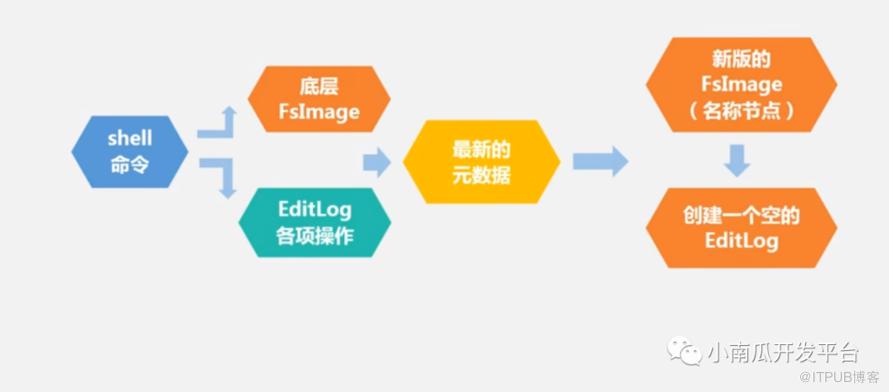
NameNode管理文件系统的命名空间。它维护着文件系统树以及整棵树内所有的文件和目录,这些信息以两个文件形式永久地保存在本地的磁盘上,即命名空间镜像文件和编辑日志文件。
NameNode记录着每个文件中各个块所在的数据节点信息,但并不永久保存块的位置信息,因为这些信息会在系统重新启动时由数据节点重建。客户端通过与NameNode和DataNode交互来访问整个文件系统。
特点:
NameNode是HDFS集群中的单点故障,如果NameNode关闭,整个HDFS/Hadoop集群将无法访问。
NameNode所在机器通常会配置有大量内存(RAM)。
五、关于DataNode
DataNode是HDFS(Hadoop Distributed File System)中的重要组件。

作用:
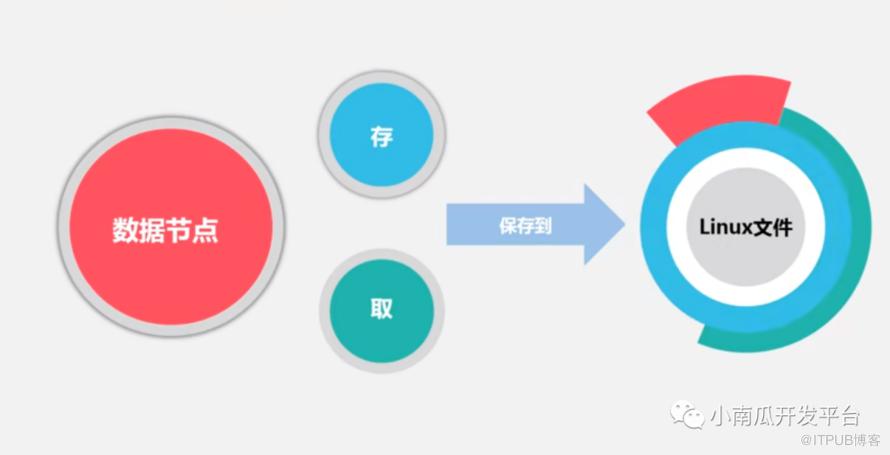
存储实际的数据块:在HDFS中,每个文件都被分成一个或多个数据块,这些数据块存储在DataNode上。
-
处理数据块的读/写操作:当客户端需要读取或写入数据时,它会首先与NameNode通信以获取文件的位置信息,然后直接与DataNode进行交互以读取或写入数据块。
特点:
DataNode是用于存储和管理数据的节点,是Slave。NameNode下达命令,DataNode执行实际的操作。
DataNode周期性地发送块信息给NameNode,包括数据块和元数据。如果DataNode发生故障,NameNode会接收到异常信息并重新分配数据块。
DataNode支持高并发访问:一次写入、多次读取是HDFS非常重要的特点,它降低了对并发控制的要求,简化了数据聚合性,支持高吞吐量访问。这是大数据系统的一个非常重要的指标,吞吐量高意味着能处理的数据量大
六、HDFS的体系结构
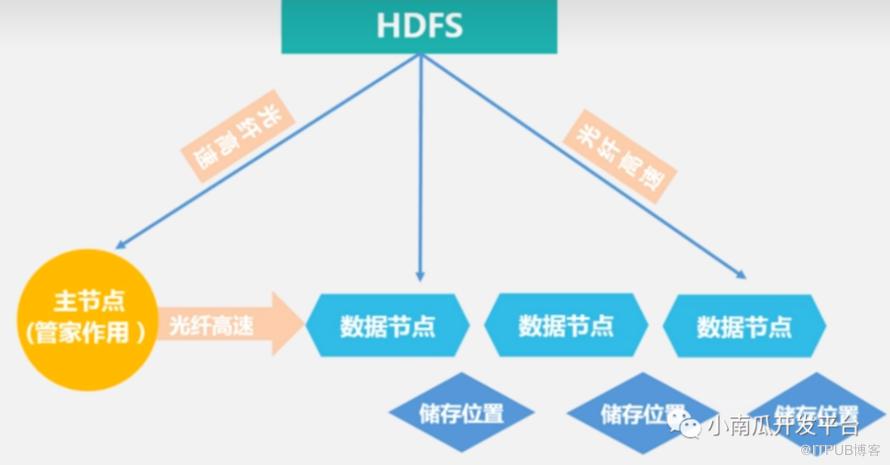
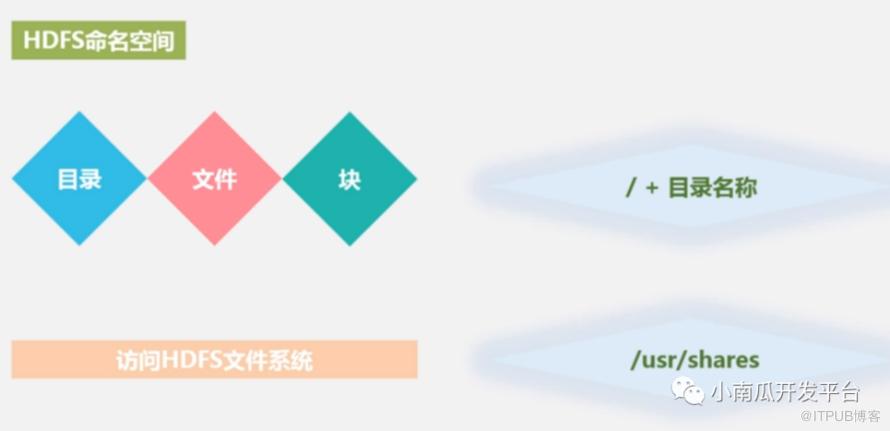
一个真正的HDFS集群包括一个名称节点和若干个数据节点。名称节点负责管理文件系统的命名空间和客户端对文件的访问,而数据节点则负责存储实际的数据块并处理客户端的读写请求。第二名称节点可以帮助名称节点处理一些任务,如检查文件系统的元数据等。
客户端(Client):客户端是用户与HDFS交互的接口,它可以在本地文件系统或HDFS中创建、读取或删除文件和目录。
名称节点(Namenode):名称节点是HDFS的主服务器,负责管理文件系统的命名空间和客户端对文件的访问。它维护着一个文件系统的树形结构,并记录着每个文件的数据块列表。
数据节点(Datanode):数据节点是HDFS中的存储节点,负责存储实际的数据块。每个数据节点运行一个Datanode进程,负责管理客户端的读写请求,并在名称节点的统一调度下进行数据块的创建、删除和复制等操作。数据块实际上都是保存在数据节点本地文件系统中的。
第二名称节点(SecondaryNameNode):第二名称节点是辅助名称节点的角色,它负责辅助名称节点的工作,比如检查文件系统的元数据。但是,它并不直接存储数据。
七、HDFS的体系结构的局限性
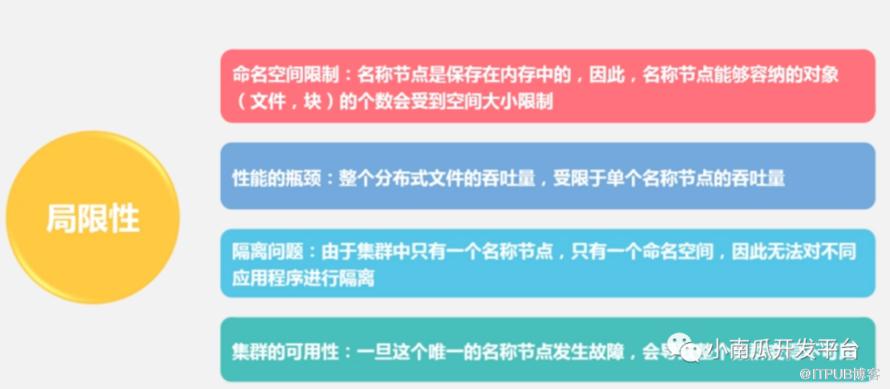
命名空间的限制:名称节点是保存在内存中的,因此名称节点能够容纳的对象(文件、块)的个数会受到内存空间大小的限制。
性能的瓶颈:整个分布式文件系统的吞吐量受限于单个名称节点的吞吐量。
隔离问题:由于集群中只有一个名称节点,只有一个命名空间,因此无法对不同应用程序进行隔离。
-
集群的可用性:一旦唯一的名称节点发生故障,会导致整个集群变得不可用。虽然第二名称节点可以帮助名称节点处理一些任务,但它不能替代主节点的工作。
为了克服这些局限性,可以采取一些措施,例如使用多个名称节点来分担负载、实现应用程序的隔离机制以提高安全性、以及采用高可用性的集群配置来确保数据的可用性和系统的可靠性。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

