一、HDFS的存储原理
HDFS的存储原理基于块的分布式存储。它将大文件分成固定大小的块,通常为64MB或128MB,然后将这些块分布在不同的DataNode上,以实现数据的冗余和可靠性。块是HDFS文件系统中的最小存储单元,块的大小是固定的,可以根据具体情况进行调整。
二、HDFS冗余数据保存的问题
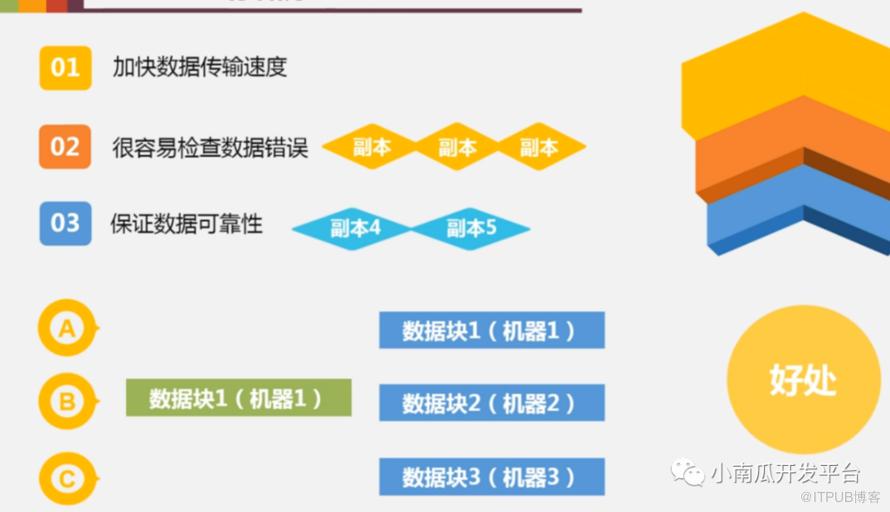
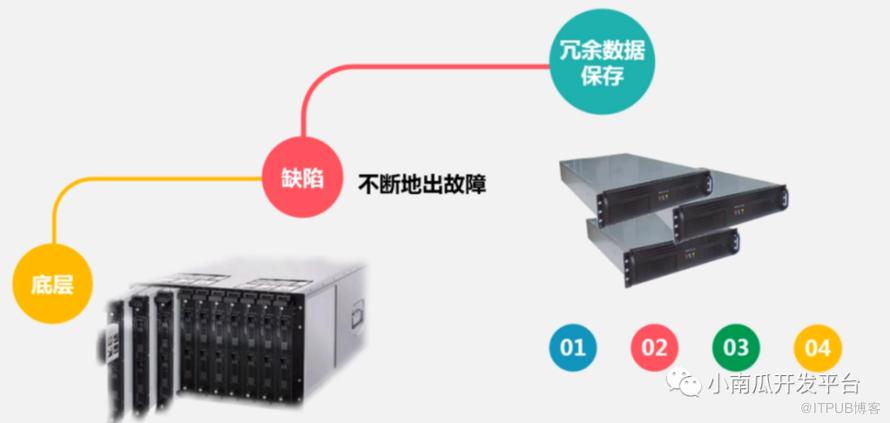
HDFS中冗余数据保存的问题主要是由于底层机器的廉价性导致故障频发。解决这种问题的方法是数据的冗余保存。默认的冗余因子是3,即一份数据有三份相同的数据。这样做的好处有以下几个方面:
加快访问速率:同时访问相同的数据时可以加快访问速率,并行访问相同的数据。
容易检查数据错误:通过检查其它版本来确定数据的准确性。
保证数据的可靠性:系统会周期性的探测数据的冗余数量是否符合配置的要求。

三、HDFS数据保存策略问题
HDFS的数据保存策略主要基于数据冗余和数据放置两方面考虑。
在冗余数据保存方面,HDFS采用了数据块的冗余存储机制,可以容忍节点宕机,不会影响数据完整性。当一个数据块在多个节点上有副本时,如果少数几个节点宕机,可以根据副本机制找回数据。这种冗余保存策略在大数据环境中是必要的。
在数据放置方面,HDFS具有以下特点:
放置策略:HDFS可以配置数据块放置的存储类型列表和备用存储类型列表。根据存储策略,可以将数据块放在不同类型的存储介质上,例如传统磁盘、SSD硬盘和RAM_DISK等。
-
异构存储:Hadoop2.6.0版本引入了异构存储特性,可以根据不同存储介质的读写特性进行选择。例如,对于冷数据,可以选择读写性能不高但容量大的存储介质如机械硬盘;对于热数据,可以选择使用SSD硬盘存储,以提高读写效率。这种异构特性允许对不同文件选择不同的存储介质进行保存,以实现机器性能的最大化。
总结起来,HDFS的数据保存策略综合考虑了数据冗余和数据放置两方面因素,通过数据块的冗余存储机制和灵活的数据放置策略来保证数据的可靠性和访问速率,以及最大化机器性能。
四、HDFS数据恢复的问题
在HDFS中,当一个数据块丢失或损坏时,可以通过以下策略进行恢复:
数据冗余:HDFS在多个计算节点上复制数据块,实现数据的冗余存储。当某个节点发生故障时,可以从其他副本节点中获取数据,保证数据的可靠性和可用性。
心跳检测:HDFS的主节点(NameNode)会定期向所有数据节点发送心跳信号,以检测节点的存活状态。如果某个数据节点长时间未发送心跳信号,主节点会将其标记为失效节点,并将其上的数据块复制到其他正常节点上。
副本选择:在数据写入过程中,HDFS会根据"就近复制(Rack Awareness)的策略选择数据块的副本位置。这样可以尽量将副本分布在不同的机架上,减少机架级别的故障对数据的影响。
-
副本重平衡:HDFS会定期检查每个计算节点上的数据块数量,如果某个节点上的数据块数量偏多或偏少,会触发副本重平衡操作。副本重平衡会将数据块从数量过多的节点移动到数量过少的节点上,以平衡整个集群的负载和数据分布。

此外,如果误删除了HDFS文件,可以利用回收站机制恢复。当我们执行hdfs dfs -rm -r some_file命令后,文件不会被立即删除,而是先将要删除的数据移动到当前用户的.Trash目录下,待超过一定时间后才会真正执行删除的操作。
五、HDFS的数据读取
HDFS的数据读取过程是这样的:
Client发起文件读取请求,通过RPC与NameNode建立通讯。NameNode检查目标文件,来确定请求文件block块的位置信息。
NameNode会视情况返回文件的部分或者全部block块列表,对于每个block块,NameNode都会返回含有该block副本的DataNode地址。
这些返回的DataNode地址,会按照集群拓扑结构得出DataNode与客户端的距离,然后进行排序:网络拓扑结构中距离Client近的排靠前;心跳机制中超时汇报的DN状态为STALE的排靠后。
Client选取排序靠前的DataNode调用FSDataInputSteam的read方法来读取block块数据。如果客户端本身就是DataNode, 那么将从本地直接获取block块数据。
-
当读完一批的block块后,若文件读取还没有结束,客户端会继续向NameNode获取下一批的block列表。当所有的block都读取完成之后,按照block排序,将读取的block一个一个连接起来,形成最终的文件,此时用户就能看到最终的文件了。
当客户端读取数据时,从名称节点获得数据块不同副本的存放位置列表,列表中包含了副本所在的数据节点,可以调用API来确定客户端和这些数据节点所属的机架ID,当发现某个数据块副本对应的机架ID和客户端对应的机架ID相同时就优先选择该副本读取数据,如果没有发现,就随机选择一个副本读取数据
六、HDFS数据的错误与恢复
在HDFS中,数据错误和恢复主要涉及以下几方面:
名称节点错误:名称节点负责存储整个文件系统的元数据信息,如果名称节点出现故障,会导致整个文件系统的读写操作受到影响。此时,需要尽快重启名称节点,以保证文件系统的正常运行。
数据节点错误:数据节点负责存储实际的数据块,如果某个数据节点发生故障或网络故障,导致名称节点无法收到该节点的心跳信息,那么名称节点会将其标记为“宕机”,并将其上的所有数据标记为不可读。此时,名称节点不会向该数据节点发送任何I/O请求。如果某个数据块在大多数数据节点中的副本数量小于冗余因子,名称节点会启动数据冗余复制,为它生成新的副本。
数据块错误:在文件被创建时,客户端会对每一个文件块进行信息摘录,并把这些信息写入同一个路径的隐藏文件中。当客户端读取文件的时候,会先读取该信息文件,然后利用该信息对每个读取的数据块进行校验。如果校验出错,客户端就会请求另外一个数据节点读取该文件块,并向名称节点报告该文件块有错误。名称节点会定期检查并重新复制该数据块。
-
数据删除与恢复:如果文件被删除,它会被保留到.Trash目录下。在这个时间限制过去之前,可以恢复被删除的文件。回收站机制为用户提供了误删除操作的空间,因此建议开启HDFS回收站功能。

请注意,由于涉及大量数据和计算资源,HDFS的数据恢复过程可能会比较复杂和耗时。因此,预防和灾备方案的设计和实施也是非常重要的。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

