一、HDFS的基本编程方法
HDFS的编程主要通过Hadoop的Java API来实现。以下是基本的使用方法:
获得FileSystem实例:可以通过Configuration来获取FileSystem的实例,如:staticFileSystemget(Configuration)。也可以通过URI和Configuration来获取,如:staticFileSystemget(URI,Configuration),它会根据URI查找适合的配置文件,如果找不到,则从默认位置读取。
读取数据:可以通过FSDataInputStream来打开指定路径的文件,并返回输入流。如:FSDataInputStreamopen(Path)。也可以通过abstractFSDataInputStreamopen(path,intbuffersize)来打开指定路径的文件,其中buffersize为读取时的缓冲大小。
-
写入数据:可以通过FSDataOutputStream来打开指定文件进行写入。如:FSDataOutputStreamcreate(Path),该方法默认是重写文件,并且会自动生成所有父目录。
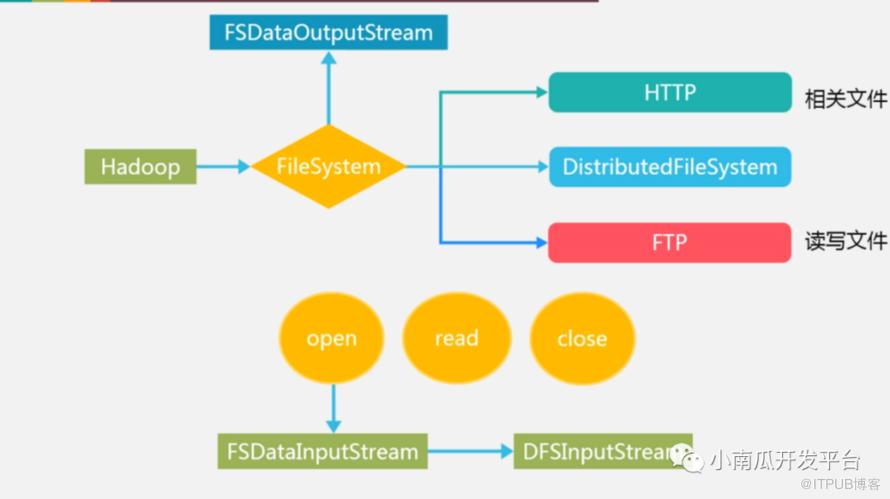
对于以上步骤,所有的操作完成后都需要关闭输入输出流,以释放资源。
同时,在Shell中,HDFS也可以通过hdfs dfs或hadoop fs命令来实现对文件的操作,如查看、上传和下载、创建文件等。
二、hdfs支持哪些方式操作
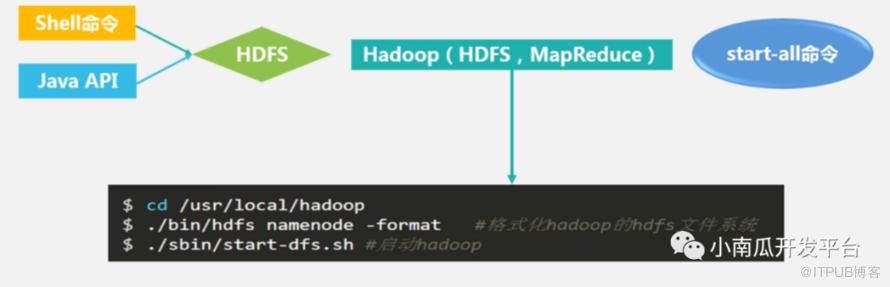
HDFS可以通过以下两种方式进行操作:
命令行方式:Hadoop提供了一套与Linux文件命令类似的命令行工具,可以通过命令行终端对HDFS进行文件上传、下载和复制等操作。
Java API:利用Hadoop的Java库,采用编程的方式操作HDFS的文件。
三、HDFS的读数据过程
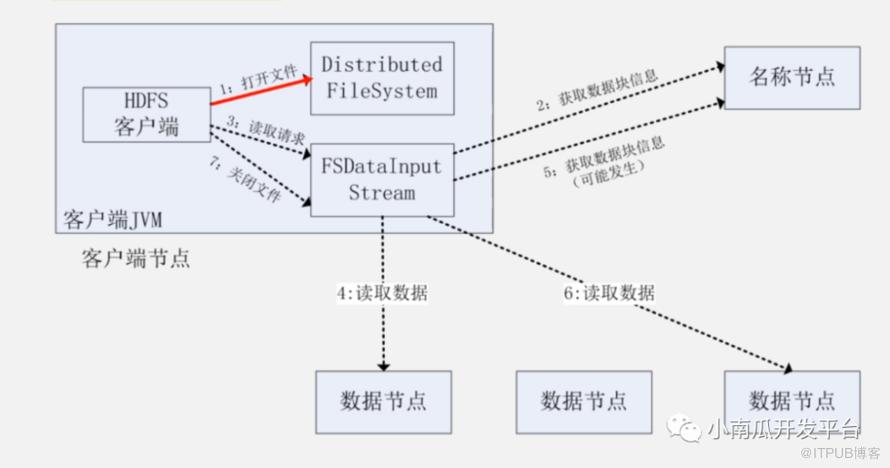
HDFS的读数据过程如下:
客户端向NameNode发送下载文件请求,NameNode通过查询元数据,找到文件块所在的DataNode服务器。
客户端挑选一台DataNode服务器,请求读取数据。
DataNode向客户端发送数据,从磁盘里面读取数据流,以packet为单位来做校验。
客户端以packet为单位接收,先在本地缓存,然后写入目标文件,然后将每块的数据拼接起来组合成一个完整的文件。
四、HDFS的写数据过程
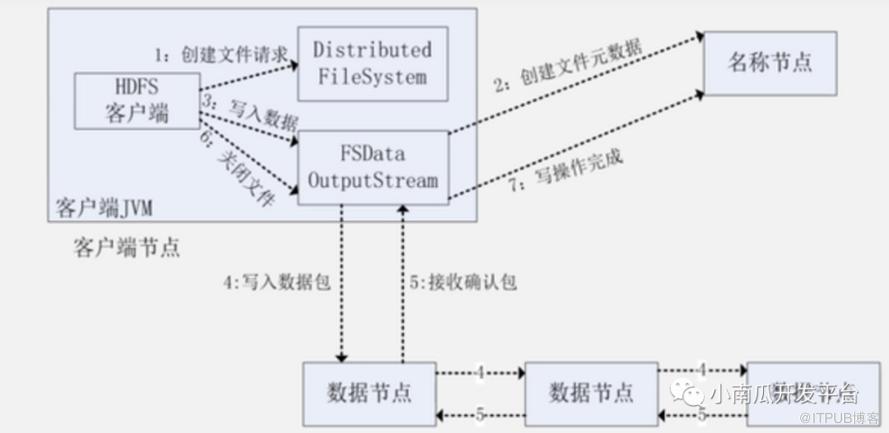
客户端向NameNode请求写入数据。
NameNode接受写入请求后,首先判断当前这个操作用户是否拥有写入权限,如果不具有直接报错。
从接受列表中选择第一台DataNode与之连接,建立pipeline(管道)。
当连接第一台后,让第一台与第二台连接,然后第二台与第三台连接形成一条pipeline(管道)。
客户端通过package(数据包64kB)的形式发送数据,当第一台DataNode接受完数据后,然后将数据转发给第二台DataNode,当第二台DataNode接受完数据后,将数据转发给第三台DataNode。
当第一个请求完成后,搭建一个反向应答队列,当每个节点都将数据包接受后,反向给予应答反应(ACK确认机制)。
-
此时客户端开始源源不断的发送数据即可,当第一个block发送完成后,此时客户端重新向NameNode发送请求,获取第二个block应该存储到哪个DataNode中。
五、hdfs的java编程实例
import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.FileSystem;import org.apache.hadoop.fs.Path;import org.apache.hadoop.fs.FSDataOutputStream;import java.io.IOException;public class HDFSExample {public static void main(String[] args) throws IOException {// 1. 获取配置对象,设置HDFS文件系统的地址Configuration conf = new Configuration();conf.set("fs.defaultFS", "hdfs://localhost:9000");// 2. 获取HDFS文件系统对象FileSystem fs = FileSystem.get(conf);// 3. 创建新文件并打开输出流Path path = new Path("/example.txt");FSDataOutputStream outputStream = fs.create(path);// 4. 向文件中写入数据String data = "Hello, HDFS!";outputStream.write(data.getBytes());// 5. 关闭输出流,这样数据就会被刷到HDFS磁盘上outputStream.close();// 6. 关闭文件系统连接fs.close();}}
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

