背景
某集团公司需要将大批量数据进行系统间的业务数据分析和传递,技术团队在存储介质技术选型上进行思考,最终选定的存储方案是:kafka、S3、clickhouse。
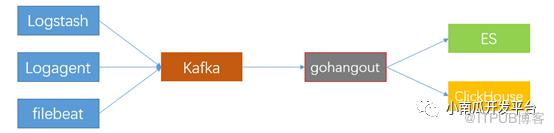
1、kafka:业务系统把业务数据通过kafka主题下发数据到数据平台;
2、S3:数据平台将数据转换成S3文件,再将数据下发到分析系统;
3、clickhouse:分析系统通过ETL将S3文件增量写入到clickhouse数据库;
4、关系型数据库:ETL再将click house的数据下发到业务系统数据库。
以上数据流通方案也是基于业务的特点进行选型的,下边是各个存储引擎的特点:
Kafka
Kafka是一个稳定、可靠的消息中间件,可以用于各种不同的应用场景。主要特点如下:
高吞吐量:Kafka可以处理和存储大量的数据,同时保证低延迟的消息传递。
可扩展性:Kafka集群可以轻松扩展到数百个broker,并且可以跨多个数据中心进行数据复制。
持久性:Kafka将消息持久化到磁盘上,因此即使在系统崩溃时,数据也不会丢失。
灵活性:Kafka支持发布和订阅消息流,可以将其用于各种用途,例如日志聚合、实时数据流处理和消息队列等。
-
容错性:如果消费者在读取消息时出现异常,Kafka可以保证其从上次中断的地方继续处理消息。
S3
S3文件是Amazon Simple Storage Service中使用的文件存储形式.其特点包括以下几点:
对象存储:S3中的文件以对象的形式存在,可以无限次访问。对象存储是一种专为高并发访问、持久性和共享访问设计的存储方式。
高可用性:S3服务具有高可用性,它通过在多个物理位置存储数据的副本,以防止数据丢失。它能在发生故障或灾难时,保持数据的完整性和可用性。
数据保护:S3支持数据保护特性,它不仅提供了数据的持久性存储,还通过加密的方式保护用户的数据安全,防止数据被未经授权的访问。
扩展性强:S3服务提供了高扩展性,用户可以根据需要增加存储空间和访问带宽,以满足数据增长的需求。
可靠性:S3服务在设计和操作上都具有很高的可靠性,它通过分布式系统确保数据的可靠性和完整性。
-
快速廉价:S3提供了一个快速且廉价的数据存储基础架构,使得用户可以以低成本、高效率的方式存储和访问大量数据。
S3文件的这些特点使其成为非常受欢迎的对象存储服务之一,适用于需要大容量存储、高持久性和可扩展性的文件存储场景。
clickhouse
ClickHouse和Elasticsearch都是很受欢迎的大数据存储和查询引擎,它们都有自己的优点和缺点。
ClickHouse的优点包括:
高性能:ClickHouse写入吞吐量大,查询速度快,单服务器日志写入量可以达到50MB到200MB/s,每秒写入超过60w记录数,是ES的5倍以上。
成本较低:ClickHouse的数据压缩比比ES高,相同数据占用的磁盘空间只有ES的1/3到1/30,可以节省磁盘空间并有效减少磁盘IO。此外,ClickHouse比ES占用更少的内存和CPU资源。
稳定性更高:ClickHouse采用集群和Shard策略,通过轮询写的方法,可以让数据比较均衡的分布到所有节点,稳定性更高,运维成本更低。
使用方便:ClickHouse采用SQL语法,比ES的DSL更加简单,学习成本更低。
ClickHouse的缺点包括:
功能相对较少:ClickHouse主要是用于大数据的存储和查询,相比ES提供的全文检索等功能,其功能相对较少。
无法进行冷热数据分离:ClickHouse按天分partition,一般不需要考虑冷热分离,但特殊场景下如果确实需要冷热分离,数据量也会小很多。
关系型数据库
关系型数据库的优点主要包括:
保持数据的一致性:关系型数据库中的数据保持了一致性,这是因为它采用了严格的数学理论来描述数据之间的关系,从而确保了数据的准确性和可靠性。
数据更新的开销较小:关系型数据库以标准为前提,相同的字段基本只有一处,因此在进行数据更新时,只需要更新一次即可,从而减少了数据更新的开销。
成熟的技术和丰富的实际成果:关系型数据库拥有大量的实际成果和专业技术信息,这使得它成为了许多应用系统的首选。
易于理解和使用:关系型数据库的二维表结构非常贴近逻辑世界,这使得关系模型相对其他模型来说更容易理解。此外,通用的SQL语言使得操作关系型数据库变得非常方便,可以进行复杂查询。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

