什么是hadoop?
hadoop是一个由Apache基金会所开发的分布式系统基础架构。用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。
Hadoop的核心设计是HDFS和MapReduce。HDFS为海量的数据提供了存储,而MapReduce则为海量的数据提供了计算。
hadoop的特点
Hadoop的特点在于其灵活性和可扩展性,以及其强大的数据处理能力,使得其成为处理大规模数据集的理想工具。
支持超大文件:Hadoop可以处理和存储超大文件,使其适用于处理大规模数据集。
高扩展性:Hadoop的设计使得其能够方便地添加或删除节点,从而能够在大规模计算机集群中轻松扩展。
可靠性:Hadoop能够检测和快速应对硬件故障,并且拥有完善的数据备份机制,以防止数据丢失或损坏。
低成本:Hadoop可以运行在廉价的硬件上,使得用户可以利用现有的计算机硬件资源进行大规模数据处理和分析。
灵活性:Hadoop支持各种数据类型和数据源,可以灵活地处理和整合不同类型的数据。
安全性:Hadoop具有强大的权限管理和认证机制,能够保证数据的安全性和隐私性。
容错性:Hadoop设计时就考虑到了容错性,即使在某个节点出现故障,也能够保证数据的完整性和计算的持续性。
Hadoop的应用场景
Hadoop的应用领域还在不断扩展,例如在物联网、云计算、社交媒体分析和网络安全等领域都有应用。尤其在处理大规模数据集方面
大数据分析:Hadoop提供了分布式计算和存储能力,企业可以处理大规模数据集并从中提取有价值的信息。通过使用Hadoop生态系统中的工具和技术,如Hive、Pig和Spark,企业可以进行复杂的数据分析和挖掘。例如,沃尔玛通过Hadoop分析顾客搜寻商品的行为,在社交网站上对商品的讨论,从而竞争对手提前一步发现顾客需求,智能规划下一季商品的促销策略。
数据仓库:许多组织正在将Hadoop用作传统数据仓库的补充或替代品。因为Hadoop的分布式架构和可扩展性使其成为存储和处理大量结构化和非结构化数据的理想选择。此外,Hadoop还与传统的关系型数据库和数据仓库集成,形成了混合式数据存储和处理环境。
日志和事件处理:许多企业需要实时监控和分析日志和事件数据。Hadoop的弹性和可伸缩性使其成为处理大量日志和事件数据的理想平台。通过使用实时处理框架,如Apache Kafka和Apache Flume,结合Hadoop的批处理能力,企业可以实现实时的日志和事件分析。
-
机器学习和人工智能:Hadoop生态系统中的工具和技术为机器学习和人工智能提供了强大的支持。通过使用Hadoop和相关技术,如Apache Mahout和TensorFlow,企业可以训练和部署复杂的机器学习模型,以提高业务决策和自动化流程。

然而,尽管Hadoop的应用广泛,但在实际使用中仍存在一些挑战,例如数据安全、高并发访问、低延迟访问等问题需要解决。
hadoop的两大核心
Hadoop的两大核心是Hadoop分布式文件系统(HDFS)和MapReduce计算模型。
HDFS:这是一个分布式文件系统,可以将大型数据集分成多个数据块,并存储在集群中的多个计算机节点上。它自动地将数据复制到多个节点上,从而提高数据的可靠性和可用性。
MapReduce:这是一种分布式计算模型,可以将大型数据集分成多个数据块,并将这些数据块分配给多个计算机节点进行并行处理。它可以自动地将数据分组、排序和聚合,并将结果返回给用户。MapReduce计算模型方便进行大规模数据处理和分析,被广泛应用于数据挖掘、机器学习和大数据分析等领域。
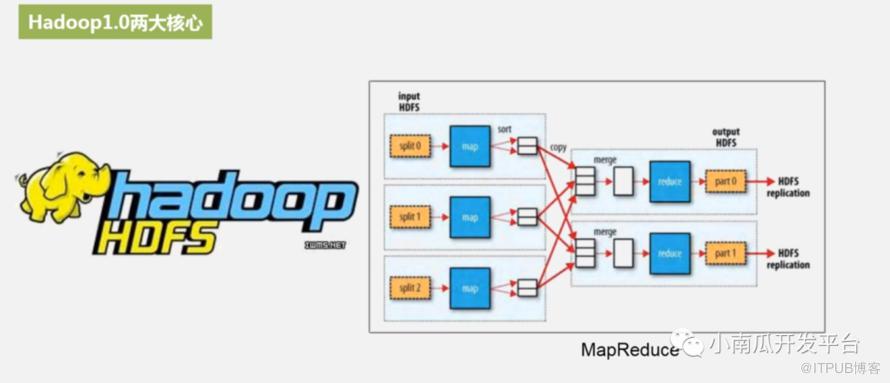
这两个核心为Hadoop提供了强大的数据处理和存储能力,使得Hadoop可以处理大规模的数据集。
Hadoop的发展历史
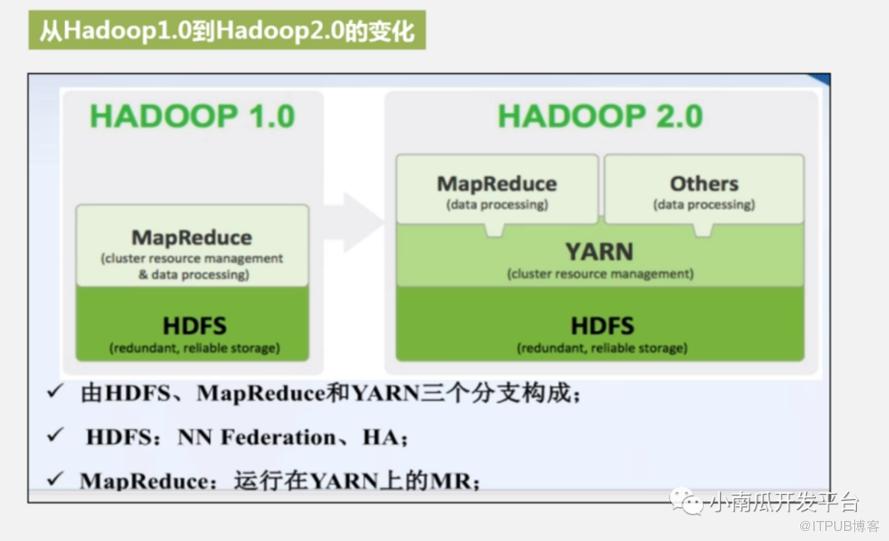
从初始的搜索引擎项目需求开始,到成为一个被广泛应用的分布式计算框架,Hadoop的发展历程充分体现了开源社区的力量和创新精神
初始阶段:Hadoop的初始版本(现在称为HDFS和MapReduce)由Doug Cutting和Mike Cafarella于2004年底开始实施。这个版本的Hadoop是为了解决Nutch搜索引擎项目中的数据存储和计算问题。
移植阶段:2005年12月,Nutch移植到新的框架Hadoop,并在20个节点上稳定运行。此时,Hadoop已经开始展现出分布式计算的优势。
独立发展阶段:2006年2月,Apache Hadoop项目正式启动,以支持MapReduce和HDFS的独立发展。这个阶段,Hadoop开始成为一个独立的计算框架,不再仅仅服务于Nutch项目。
子项目阶段:随着Hadoop的不断发展,一些与Hadoop相关的项目开始出现。例如,Hive成为Hadoop的子项目(2008年9月),Cloudera推出CDH(Cloudera’s Dsitribution Including Apache Hadoop)(2009年3月)。
分离和独立发展阶段:一些子项目在发展过程中逐渐脱离了Hadoop项目。例如,2010年5月,Avro脱离Hadoop项目成为Apache顶级项目;同年5月,HBase也脱离了Hadoop项目成为Apache顶级项目。这些分离的项目在脱离后都得到了更快速的发展。
当前阶段:当前的Apache Hadoop已经成为一个功能强大且稳定的分布式计算框架,被广泛应用于大数据处理、存储和分析领域。不仅在学术界得到了广泛的应用和研究,在工业界也得到了广泛应用,例如在Facebook、Google等大型互联网公司中都有应用。
原文作者:小南瓜开发平台;如有侵权,请联系管理员删除。

