LinkedIn如何将ClickHouse从分布式追踪扩展至指标发现与分析 | ClickHouse
摘要
LinkedIn 的可观测性团队在 ClickHouse 上运行分布式追踪、指标元数据发现和分析,此前已先在追踪场景中验证了该数据库。
即使在 1% 头部采样率下,该系统每天仍产生约 0.8 万亿个 span 和 200 TB 未压缩数据。
指标元数据索引将三个系统整合到单个 ClickHouse 集群之后,在 130 亿+ 指标上以 68 毫秒平均延迟服务每分钟 15 万+ 查询。
从旧技术栈迁移后,内存使用降至约五分之一,计算降至约三分之二,并有余力将指标量翻倍。
LinkedIn 在全球拥有超过十亿会员和数千个相互交互的服务,一次 LinkedIn 信息流加载或职位搜索就会触及数十个后端系统。当其中某个系统变慢时,找到罪魁祸首意味着要能够看清所有这些系统内部的情况。
这种可见性由公司的可观测性团队负责,他们拥有保持平台可度量的全栈,从主机、容器、服务和存储,一直到在线、近线和离线工作流以及真实用户监控,还包括构建在其上的摄取、告警、分诊、值班和可视化层。该技术栈覆盖所有类型的可观测性信号,包括指标、日志、追踪、事件、性能剖析和异常。
LinkedIn 的 ClickHouse 之旅始于两年前的分布式追踪。正如 Arun Gupta 在 2026 年 4 月于旧金山举行的 ClickHouse meetup 上详细说明的那样,团队将其投入三个数据中心的生产环境,构建了一个每天处理约 8000 亿个 span 的系统,并为工程师提供近实时的故障排查界面。“对 LinkedIn 的 ClickHouse 来说,这仅仅是开始,”Arun 当时说道。
在 Open House SF 2026 上,员工软件工程师 Jacob Zelek 接过了这个话题,分享了 LinkedIn 可观测性之旅的下一步:团队如何将旧的指标元数据系统整合到单个 ClickHouse 索引上,从而构建出一个运行成本更低、能够回答旧技术栈无法回答的问题、并且仍有充足增长空间的系统。
LinkedIn 与 ClickHouse 的初始篇章 #
2024 年,Arun 和团队正在加速构建一个基于 OpenTelemetry 的分布式追踪系统,该系统端到端跟踪请求,从会员的应用向下贯穿其触及的每个后端服务。即使在 1% 头部采样率下,该系统每天仍产生约 0.8 万亿个 span 和 200 TB 未压缩数据。他们需要一种存储,既能在写入侧跟上这一数据量,又能在读取侧保持快速,因为正如 Arun 所说:“当有人看到问题,或者工程师在调试他们正在添加的功能时,他们应该能够使用我们的应用,并非常快速地看到追踪显示的内容。”
在他们为该系统的目标中,端到端摄取必须在 10 秒内完成,列出两小时窗口内的追踪必须在 P99 下于 2.5 秒内返回,按 ID 获取完整追踪必须在 750 毫秒或更短时间内返回。他们还希望具备 7 天保留策略、分层存储、可自定义索引和查询工作负载隔离。最后,无论他们选择什么解决方案,都必须支持 KQL,这是 LinkedIn 偏好的查询语言之一。
如今,该部署横跨三个数据中心。每个数据中心都有自己的 ClickHouse 集群,由 PubSub 提供数据,包含 22 个分片和一层 ingester。团队采用红黑部署方案,同时写入两个集群并从一个集群读取,第二个集群随时准备在第一个集群出现问题时接管,第三个集群负责验证。模式被扁平化,span 属性随行携带,并在分布式表上运行 3 倍本地复制。压缩率约为 5 倍。每个节点在稳态下每秒接收 350,000 个 span,在最大负载下可突破 120 万。
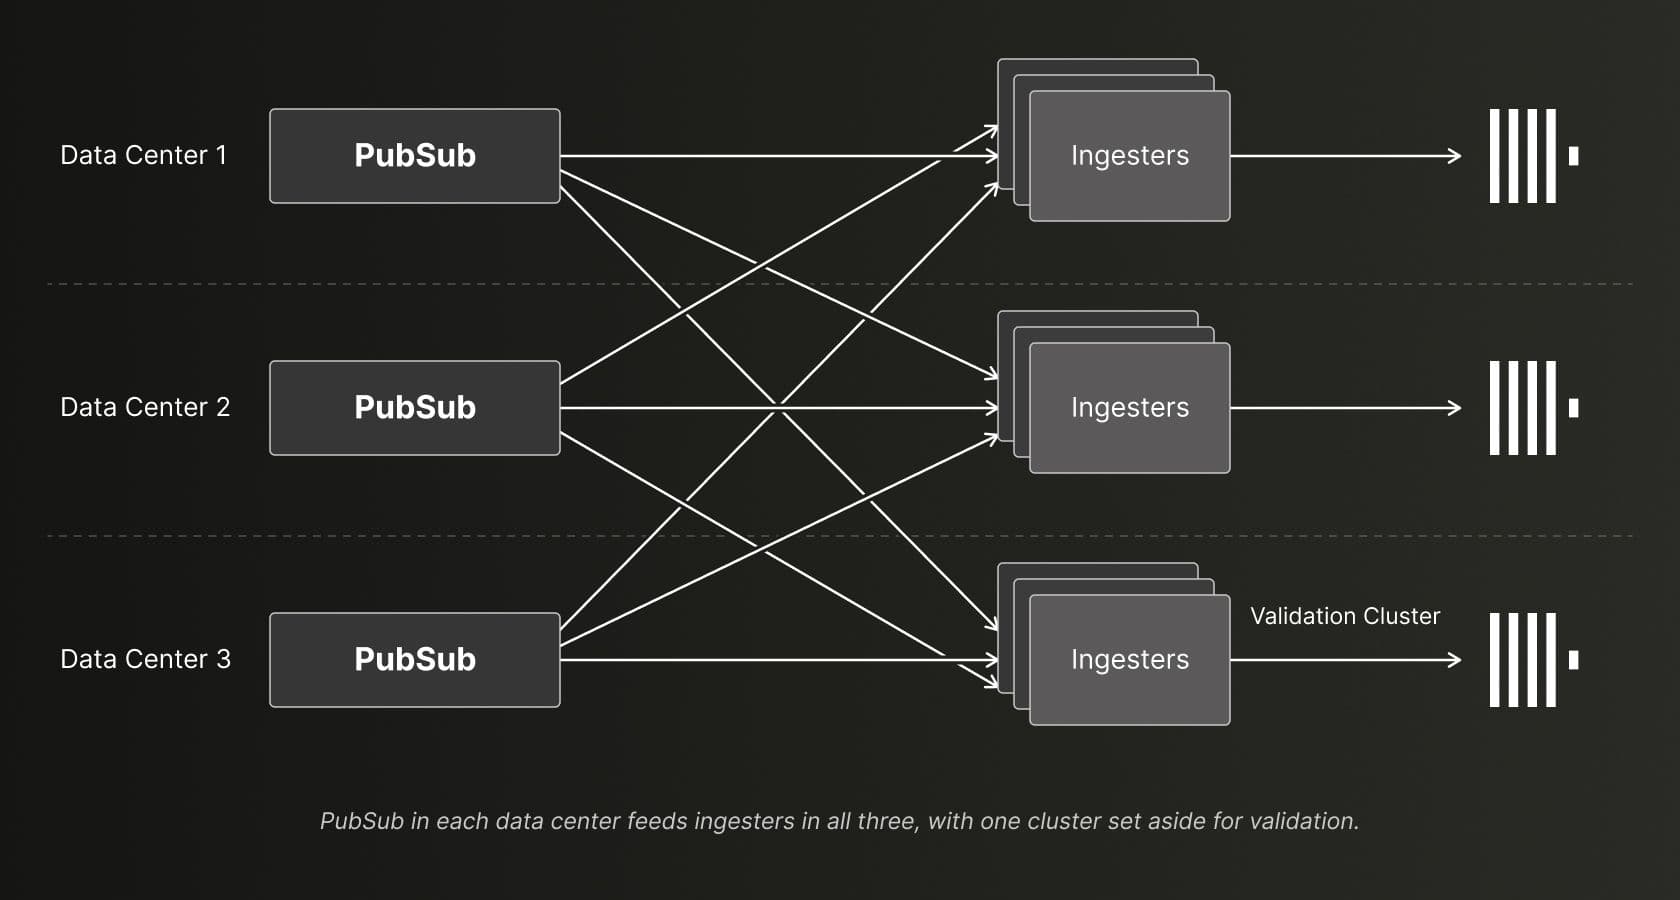
每个数据中心的 PubSub 为所有三个数据中心的 ingester 提供数据,其中一个集群专门用于验证。
团队重新排列表格,将低基数(low-cardinality)列放在前面,根据实际查询的字段重新分区,并在成本较低的列上收紧 Bloom filter 的假阳性率,使查询运行时间缩短至两秒以内。“这对我们来说意义重大,”Arun 说。
同样重要的是,该项目将 ClickHouse 大规模投入生产,并让多个团队能够熟练运行它。当 LinkedIn 的可观测性团队将其从分布式追踪扩展到指标发现和分析时,这一势头被证明至关重要。
下一个挑战:遗留指标元数据 #
多年前,LinkedIn 依赖一个名为 RRDtool 的遗留时间序列数据记录和绘图系统。然而,它引入的命名约定从未消失,在 LinkedIn 的规模和体量下,它一直保留至今。
如今,该指标仍通过 RRD 引用,即一个将两到六个标准化维度拼接在一起的单一字符串(例如 “my-server/responses.status.200.rrd”)。最初,用户可以针对单个指标,但后来团队引入了对多个指标应用正则表达式的能力,以便在一个图中生成多个序列,或为每个匹配项生成单独的图。“你可以看出为什么这开始成为一个问题,”Jacob 说。
这个问题因 LinkedIn 的运营规模而更加复杂。该公司有超过 130 亿个指标仍使用 RRD 语义引用,每日周转率约为 30%。数百万个图表和告警以这种方式定义,数十个工具和服务仍在查询 RRD 指标。与此同时,指标数量持续攀升,新的工具、服务和用例不断被接入。
LinkedIn 可观测性团队面临的挑战是让人们能够发现和分析所有这些内容。例如,工程师可能想查询哪些主机发出给定指标、某个服务发出哪些 RRD、哪些指标在所有服务中匹配某个模式,以及唯一指标计数如何趋势变化以进行增长跟踪。“最大的问题是,”Jacob 说,“我们需要人们能够查询这些东西,直到我们最终能让所有人迁移出去。”
旧技术栈已发展成单一网关后面的三个独立服务。当 Jacob 加入时,有一个自定义的内存搜索索引和一个自定义的内存 KV 存储。他后来引入了 Elasticsearch,希望它能服务所有查询并让他们移除其他服务。“不幸的是,它成了又一个服务这些查询的服务,”他说,并指出 Elasticsearch 不能很好地处理更大的跨维度聚合,返回大型结果集意味着需要在内存中序列化它们。
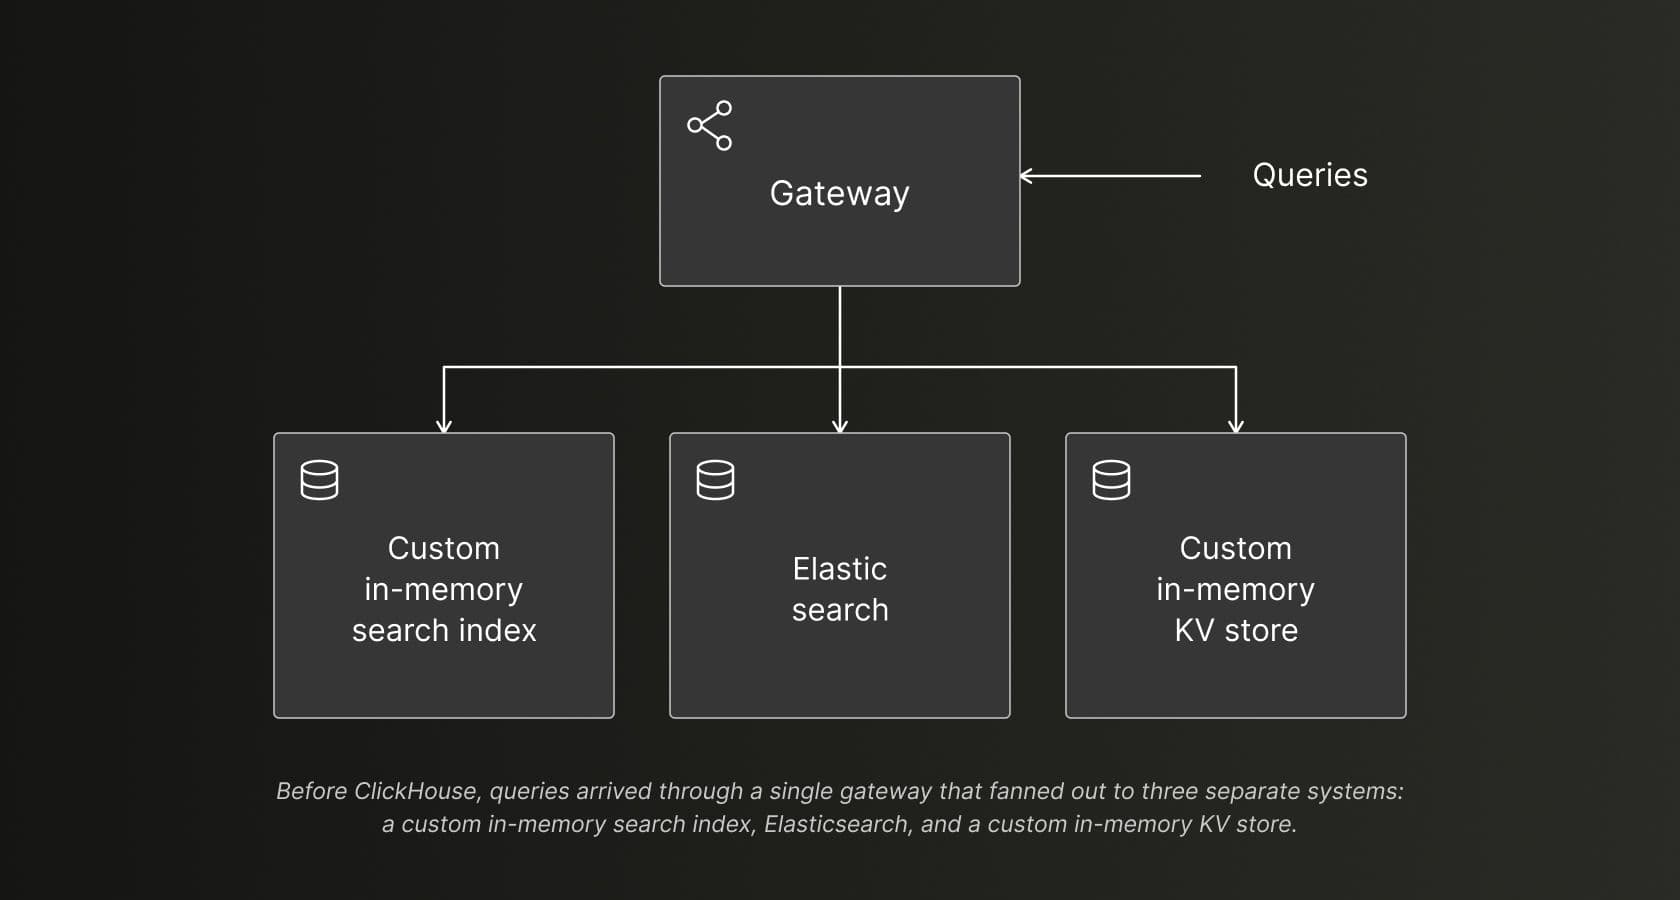
在使用 ClickHouse 之前,查询通过单一网关到达,该网关扇出到三个独立系统:一个自定义的内存搜索索引、Elasticsearch 和一个自定义的内存 KV 存储。
到 2025 年,所有三个现有服务都已达到扩展极限,管理三个独立系统已成为运营负担,即使它们加在一起也无法服务工程师提出的一些查询。他们需要一个更好的解决方案。
在 LinkedIn 构建 ClickHouse 生态系统 #
团队考虑了多种方案。再构建一个定制解决方案并不吸引人,因为正如 Jacob 所说,“它永远不会像通用解决方案那样灵活”,而且专业知识将仅限于少数开发者。“我们已经这样做过了,不想再走那条路,”他补充道。
分片 MySQL 是一个已知的选择,但原因并不理想,因为团队之前曾使用 Vitess 作为真相来源,发现它无法扩展读取。Elasticsearch 已经在手并且已经尝试过,但之前将流量迁移到它的尝试失败了,导致团队仅将其保留用于探索目的。
与此同时,ClickHouse 支持所有现有查询。与定制的内存数据库进行基准测试相比,大多数查询在 ClickHouse 上运行得更快,较慢的查询也仍在可接受范围内。其配额和查询日志让团队能够看到哪个团队或服务在驱动每个查询,并且正如 Jacob 所说,“不仅停止滥用查询,还与那些团队合作重写查询以提高效率。”作为一个持有所有维度的通用 OLAP 存储,它允许团队支持他们从未想到的分析查询,其中一些可以更高效地替代现有查询。
“我们从使用 ClickHouse 进行追踪中获得的专业知识使新项目的入门变得非常容易。我们正在 LinkedIn 开始开发一个 ClickHouse 生态系统。” — Jacob Zelek,Staff Software Engineer
“对我们来说,扩展 ClickHouse 比引入另一个像 Elasticsearch 这样的系统(人们正在远离它)或尝试构建只有我们团队才能理解的定制东西更舒适,”Jacob 说。
用于遗留指标元数据的新基于 ClickHouse 的架构 #
当前架构“相当简单”,Jacob 说。团队的时间序列数据库通过一个持续变更捕获系统向 ClickHouse 提供数据,而之前作为每个元数据查询前端的网关现在将这些查询重写为 SQL 并对 ClickHouse 运行它们。
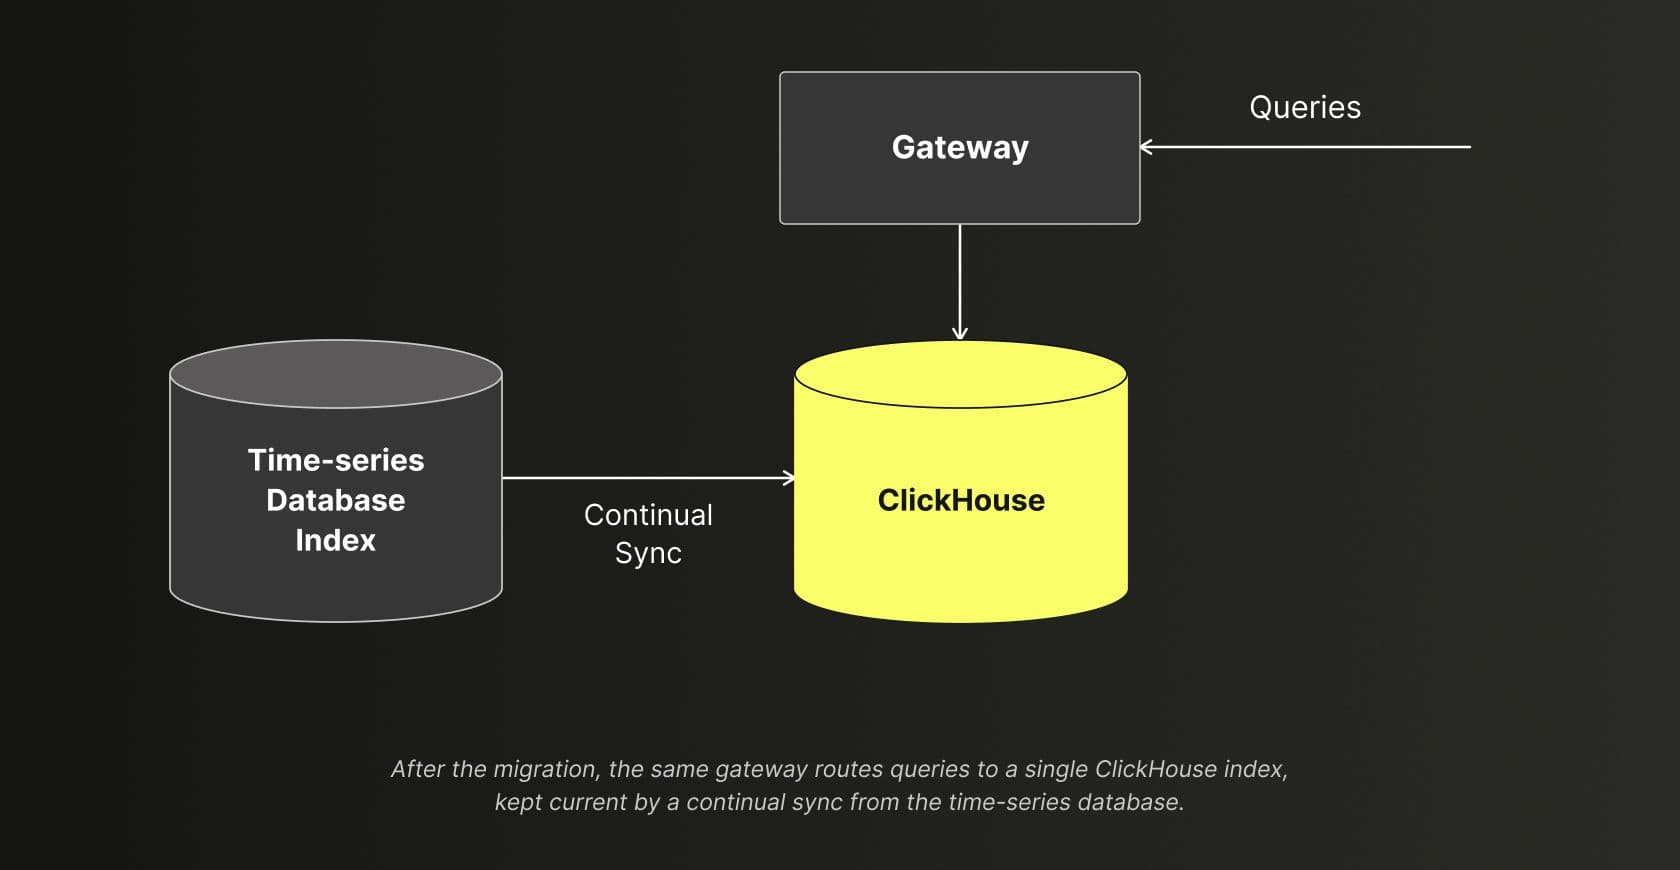
迁移后,同一个网关将查询路由到单个 ClickHouse 索引,该索引通过来自时间序列数据库的持续同步保持最新。
Jacob 说,那个网关使迁移“透明”。公司中的每个工具和服务都已经通过它路由,所以当网关停止扇出到三个独立服务并开始向 ClickHouse 写入 SQL 时,下游无需任何更改。“任何使用 RRD 的人已经在使用 ClickHouse,”他说。
底层,表是一个复制的 ReplacingMergeTree,排序以保持发现维度高效,去重基于唯一 ID。变更捕获流提供至少一次交付,因此重复不可避免;让 ClickHouse 在其合并期间丢弃它们意味着团队可以容忍流的语义而无需额外管道。管道从离线时间序列数据库构建一个新的每日表,用变更捕获数据追赶它,然后使用别名交换表指针并在删除旧表之前切换流量。
投影处理旧系统无法处理的更重聚合,包括服务到指标计数、服务到唯一 RRD 计数以及数据中心到主机列表。模式还直接暴露各个维度,因此曾经对完整 RRD 字符串运行正则表达式的工程师现在改为在列上过滤。“这效率高得多,”Jacob 说。
结果与未来之路 #
如今,这个整合后的索引在整个集群中每分钟处理超过 150,000 次查询,平均延迟为 68 毫秒。正如 Jacob 所指出的,这个平均值涵盖了所有查询类型,包括旧系统完全无法处理的缓慢、深度分析查询。“如果你把它拆开来看,你会看到一些个位数毫秒的查询,”他说。它在全部 130 多亿个指标上实现了这一点,同时应对 LinkedIn 每天 30% 的数据周转,且仅运行在单个分片上。
在资源方面,Jacob 估计这次迁移将内存使用量削减至此前三系统技术栈所需的大约五分之一,并将计算资源减少到约三分之二。由于元数据索引是单个分片,团队无需考虑重新分片,而且还有足够的余量将指标量翻倍,这与已达到扩展极限的旧架构相比是一个巨大的转变。
现在每个维度都可查询,主要客户正在将他们旧的、大量使用正则表达式的查询改写为更高效的原生查询。这意味着即使指标量增长,集群实际上可能会随时间缩减。借助 ClickHouse,同一个索引正在成为帮助工程师查找和推理其指标的工具,因为 LinkedIn 正在将图表和告警从 RRD 语义迁移到原生语义,从而实现了 Jacob、Arun 和可观测性团队多年来一直努力推进的更大规模迁移。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:ClickHouse Blog
原创地址:https://clickhouse.com/blog/linkedin-observability-at-scale
原文作者:ClickHouse;如有侵权,请联系管理员删除。

