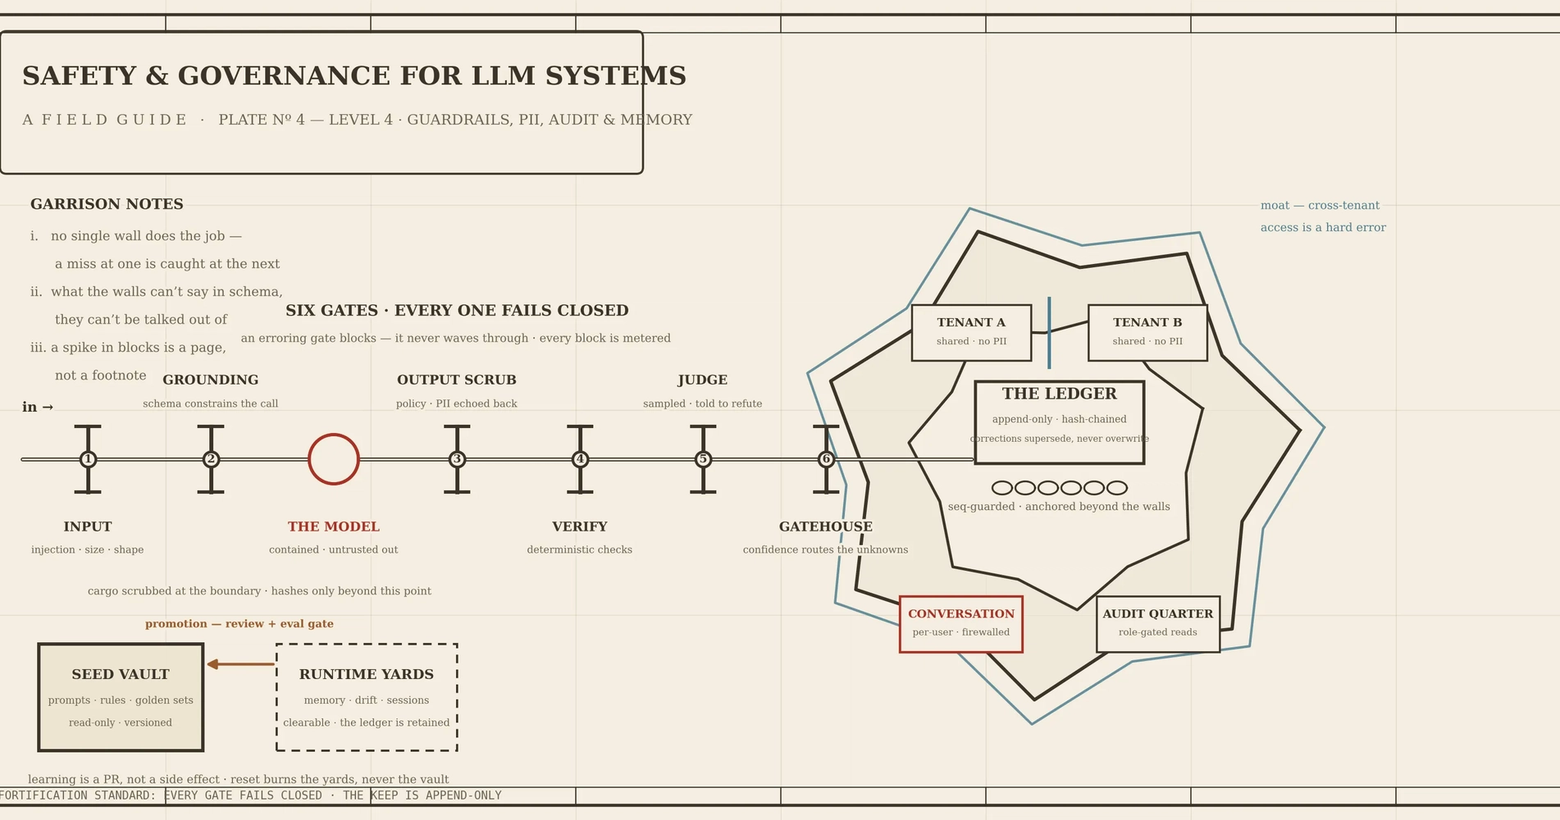
LLM(大语言模型) 系统不再只是演示、真正有权接触真实数据和真实决策的那个层级:分层护栏,故障时关闭,在边界处理 PII,不可篡改的审计追踪,以及有作用域的记忆。
当 LLM 系统开始做出重要决策时,“通常能跑通”就不再是标准了。这是成熟度模型的第 4 级——安全与治理——也是团队往往后期才补上的四个学科必须被设计进去的地方。它们共享一个理念:不要信任单一节点能做对事情。分层独立的护栏,让某一层的遗漏在下一层被捕获。在每个边界处理敏感数据,使其永远不会在不该积累的地方积累。写入不可篡改的审计追踪,让“它为什么那样做?”在几个月后仍有答案。并按类别限定记忆作用域,使一个客户的数据永远不会影响另一个客户的决策——在你交付的内容和系统赢得的能力之间划清界限。
这些都不是什么稀奇的东西。每一个都是在代码中强制执行的小型、可测试的契约。下面是它们如何协同工作。
纵深防御:分层设置护栏
很多团队“添加护栏”的方式是在模型输出上挂一个审核过滤器,然后就说完成了。这相当于 AI 版的单条防火墙规则。真正的安全,就像真正的信息安全一样,是纵深防御:多个独立层,每一层捕获不同类别的问题,并安排得让某一层的遗漏在下一层被捕获。
让每个护栏都遵循同样的小型契约,这样你就可以独立地添加、移除、测试和重新排序它们。
from typing import Protocol, Literal
from dataclasses import dataclass, field

@dataclass
class GuardrailResult:
    action: Literal["ok", "block", "redact", "flag"]
    layer: str
    rule: str = ""
    detail: dict = field(default_factory=dict)   # e.g. {"fields": ["email"]}

class Guardrail(Protocol):
    layer: str
    def check(self, ctx: "Context") -> GuardrailResult: ...
然后,请求在进入和出去的路上会经过检查点:
#  Layer                          Catches                                                 Stage
-  -----------------------------  ------------------------------------------------------  ---------------------
1  Input / pre-prompt             injection, oversized/malformed input                    before the model
2  Grounding constraints          model using disallowed actions/data; off-schema output  shapes the model call
3  Output scrub                   policy violations, PII echoed back                      after generation
4  Verification                   business-rule / consistency violations                  deterministic code
5  Judge                          "plausible but wrong" that passed mechanical checks     sampled second model
6  Composed confidence + routing  the unknowns — anything still uncertain                 final net
in ─▶[1 input]─▶[2 grounding]─▶(model)─▶[3 output scrub]─▶[4 verify]─▶[5 judge]─▶[6 confidence/route]─▶ act|escalate顺序和通过/失败逻辑集中在一个可读的地方。两条规则:故障时关闭(出错或不可用的护栏会阻止或升级——它绝不会让请求通过),并将每次阻止都记录为一等信号。
def run_guardrails(ctx, layers, metrics) -> list[GuardrailResult]:
    applied = []                                     # accumulate — a redacted result must be visible to the caller/audit
    for g in layers:
        try:
            r = g.check(ctx)
        except GuardrailError:                       # NARROW — don't swallow your own bugs as a "block"
            metrics.incr("guardrail_blocks_total", layer=g.layer, rule="error")  # rule = bounded enum, NEVER matched content
            return applied + [GuardrailResult("block", g.layer, "error")]   # same label the metric emitted
        if r.action == "ok":
            continue
        metrics.incr("guardrail_blocks_total", layer=g.layer, rule=r.rule)
        if r.action in ("redact", "flag"):
            ctx.apply(r); applied.append(r); continue
        if r.action == "block":
            return applied + [r]                     # stop at first hard block
        return applied + [GuardrailResult("block", g.layer, "unknown_action")]  # unknown action == block (fail closed)
    return applied or [GuardrailResult("ok", "all")]
这里最重要的一个测试证明它会故障时关闭:
def test_fail_closed_on_error():
    class Boom:                                 # a guardrail that throws
        layer = "x"
        def check(self, ctx): raise GuardrailError("boom")
    result = run_guardrails(ctx, [Boom()], NullMetrics())
    assert result[-1].action == "block"         # an erroring guardrail BLOCKS, never silently passes
为什么分层胜过一个大过滤器:没有单点故障(注入绕过了第 1 层?接地限制了它能做什么;输出异常?清洗或验证会捕获它)。每一层都简单且可测试——六个单一用途的检查各自有清晰的契约,而一个巨型过滤器则无法推理。不同层捕获不同的故障模式:输入清洗捕获攻击,验证捕获逻辑错误,评判器捕获看似合理的错误,置信度捕获未知的未知。没有任何单一机制能覆盖全部四种。
还有一个理由要计量每次阻止:guardrail_blocks_total{layer, rule} 是你拥有的最敏锐的生产健康信号之一。峰值意味着攻击、回归或糟糕的部署——对它告警。
反模式大多是规则的反面。故障时开放比没有护栏更糟——它给出虚假的保证。一层做所有事情是不可维护的。模型可以绕过的护栏(在提示中说“请不要做 X”)不是护栏——约束输出空间(枚举/模式),使不允许的事情无法表示。静默阻止意味着你无法区分攻击和 bug。还要注意最后一项第 3 层工作——清洗模型回显的 PII——这是向下一个学科的自然交接。
边界处的 PII
AI 系统对数据有着异乎寻常的渴求——它们需要丰富的上下文才能进行良好的推理,并且会记录它们所做出的每一个决定。这与一项基本义务相冲突:不要积累你并不需要的敏感个人数据。解决方案是在边界处处理 PII——在数据进出时进行清洗,绝不让原始敏感数据沉淀到你的存储、日志或模型流量中。
基于声明的分类来驱动脱敏,而不是到处散落临时的 if field == "email"。
class Sensitivity(Enum):
    PUBLIC = 0      # ok anywhere
    INTERNAL = 1    # ok in tier-1/2 logs + ledger summary
    PII = 2         # mask in summaries; never in shared memory; tier-3 only if retained at all
    SECRET = 3      # never persisted, never logged, never to the model unless essential

FIELD_POLICY = {                         # the single source of truth
    "name": Sensitivity.PII, "email": Sensitivity.PII, "card_number": Sensitivity.SECRET,
    "amount": Sensitivity.INTERNAL, "category": Sensitivity.PUBLIC,
}
数据在组件之间移动的每一个位置都是一个边界——进入系统、进入模型、进入账本、进入日志、输出到服务。在每一个边界处都要问:这里跨越边界的内容是否需要原始敏感数据?通常不需要——在跨越之前进行脱敏、掩码或哈希。
inbound ─▶[scrub]─▶ working set ─▶[scrub]─▶ model
                          ├─▶[redact + hash]─▶ ledger    (no raw PII)
                          └─▶[redact]─▶ logs             (no raw PII)
账本边界需要特别关注:你需要证明决策是基于什么做出的,而不是保留敏感载荷。存储哈希值加上脱敏摘要;之后重新哈希以证明等价性——可验证性而不承担责任。
def classify(key) -> Sensitivity:
    return FIELD_POLICY.get(key, Sensitivity.PII)      # DEFAULT-DENY: unknown keys are treated as PII

def redact(obj):                                       # MUST recurse — real payloads are nested
    if isinstance(obj, dict):
        return {k: ("•••" if classify(k).value >= Sensitivity.PII.value else redact(v))
                for k, v in obj.items()}
    if isinstance(obj, list):
        return [redact(v) for v in obj]
    return obj

def drop_secrets(obj):                                 # SECRET fields never even enter the hash input
    if isinstance(obj, dict):
        return {k: drop_secrets(v) for k, v in obj.items() if classify(k) is not Sensitivity.SECRET}
    if isinstance(obj, list):
        return [drop_secrets(v) for v in obj]
    return obj

def ledger_view(raw: dict, tenant_key: bytes) -> dict:   # the ONLY way to write to the ledger
    safe = drop_secrets(raw)
    # HMAC with a per-tenant key, NOT bare sha256 — a plain hash of low-entropy PII (card, email,
    # phone) is brute-forceable / rainbow-tableable, so "verifiability without liability" needs a key.
    return {"inputs_hmac": "hmac-sha256:" + hmac_sha256(tenant_key, canonical_json(safe)),
            "inputs_summary": redact(raw)}
> 有两个决策需要一次确定并在各处复用:(a) 对任何低熵字段使用带密钥的哈希(HMAC,在 KMS 中使用每租户密钥)——对 16 位数字进行裸 SHA-256 是可逆的;(b) 单一的规范 JSON 规范(例如 RFC 8785 / JCS——排序键、规范化 unicode、固定数字格式),因为审计账本的哈希链依赖于重新哈希产生完全相同的字节。
模型也是一个外部边界——通常是第三方。从提示中剥离它不需要用于推理的敏感字段,并在持久化或返回之前清洗其输出,因为模型会回显输入。(那个输出清洗正是上面的第 3 层。)
失败模式是“我们在大多数地方都做了脱敏”——一种多了几步的泄露。让清洗成为通过每个边界的唯一路径,这样开发者就不会忘记:
ledger.append(ledger_view(raw, tenant_key))   # there is no ledger.append(raw) — redaction isn't optional
log.tier2(redact(event))            # the logging helper redacts; raw logging isn't exposed
并且要提前为数据驻留和访问进行设计。敏感数据带有关于它可以存放在哪里以及谁可以读取它的约束——每租户密钥、受监管层级的区域固定存储、访问门控的审计读取。在数据已经扩散到各处之后再改造,正是你要避免的噩梦。微妙的泄露不是向外,而是横向的——每用户上下文到达了为其他用户做决定的组件——但这个问题最好在结构上处理,即在下面的内存模型中。
仅追加的审计账本
当第一次有人问“为什么系统在三月对案例 X 做出了那个决定?”,你就会发现你构建的是一个审计追踪还是仅仅有日志。日志用于调试——它们会轮转,它们是非结构化的,它们不是真相。审计账本是每一个决策及其原因的规范、仅追加、防篡改的记录。对于任何有后果的事情,它都不是可选项。
CREATE TABLE decision_ledger (
  decision_id     TEXT PRIMARY KEY,        -- threads through logs/traces for this decision
  ts              TIMESTAMPTZ NOT NULL,
  tenant_id       TEXT NOT NULL,
  identity        TEXT NOT NULL,           -- who/what authority it ran with
  capability      TEXT NOT NULL,
  inputs_hash     TEXT NOT NULL,           -- keyed hash of canonical inputs (NOT the raw payload)
  inputs_summary  JSONB NOT NULL,          -- redacted, PII-free human-readable summary
  model_version   TEXT NOT NULL,
  prompt_version  TEXT NOT NULL,
  decision        JSONB NOT NULL,          -- the structured decision
  confidence      REAL,                    -- nullable: a manual supersede carries no model confidence
  routing         TEXT NOT NULL,           -- auto | hitl_recommended | hitl_required | reject | abstain
  outcome         JSONB,                   -- the ONE mutable column, filled in later; EXCLUDED from the hash
  supersedes      TEXT REFERENCES decision_ledger(decision_id),
  seq             BIGSERIAL,               -- monotonic, for the hash chain
  prev_hash       TEXT,                    -- entry_hash of seq-1
  entry_hash      TEXT NOT NULL            -- H(canonical(row-without-hash) + prev_hash)
);
-- App role gets INSERT + SELECT only. Revoke mutation in the DB, not just in code.
REVOKE UPDATE, DELETE, TRUNCATE ON decision_ledger FROM app_role;
GRANT  UPDATE (outcome) ON decision_ledger TO app_role;   -- column-level: ONLY `outcome` is writable later
-- NOTE: this stops the APP, not a DB superuser/owner who can still DROP/TRUNCATE/rewrite. True
-- append-only against an operator needs WORM/object-lock storage or external anchoring (below).
三个设计选择承担了主要工作。
仅追加——更正通过取代实现,绝不覆盖。你永远不会编辑或删除条目;更正是一条指向旧条目的新记录。
seq 1041  decision=approve  conf=0.91  supersedes=NULL
seq 1207  decision=reject   conf=NULL  supersedes=<id of 1041>  reason="manual review"
历史即真相——一条记忆模糊的旧条目永远不会悄无声息地出错,而是会被明显地取代。在数据库层面强制执行(撤销 UPDATE/DELETE 权限),因为“我们承诺不会更新它”并不等于仅追加。
对输入进行哈希——证明内容,而非存储内容。这与 PII 部分中的 ledger_view 相同:存储哈希值加上脱敏摘要,通过重新哈希并比对来证明决策是基于特定输入做出的。为了“完整性”而存储完整的敏感载荷,只会构建一个蜜罐。
防篡改——签名或链式哈希。“仅追加”在实现密码学保障之前只是一种纪律。
import hashlib
IMMUTABLE = ("decision_id","ts","tenant_id","identity","capability","inputs_hash","inputs_summary",
             "model_version","prompt_version","decision","confidence","routing","seq","supersedes")
GENESIS = "0" * 64

def _h(payload: dict) -> str:                                  # runnable: encode + hexdigest
    return hashlib.sha256(canonical_json(payload).encode()).hexdigest()

def seal(row: dict, prev_hash: str) -> dict:
    row["prev_hash"]  = prev_hash
    # hash ONLY immutable fields (NOT `outcome`, written later) via a STRUCTURED payload —
    # never string-concat hash+json (boundary ambiguity: two different rows could serialize identically).
    row["entry_hash"] = _h({"row": {k: row[k] for k in IMMUTABLE}, "prev": prev_hash})
    return row
哈希链是针对篡改的防篡改证据——修改一行,后续所有 entry_hash 都将不再匹配。它无法阻止截断(删除尾部)或从创世块开始的完全重写。因此验证器需要断言 seq 的连续性和已知的 GENESIS;对于操作员级别的威胁,还需用由独立签名者持有的非对称密钥对每个 entry_hash 进行签名,并定期将签名的检查点发布到外部存储。REVOKE 能阻止应用层;签名加锚定才能阻止拥有数据库写权限的人。
def verify_chain(rows):                      # returns first broken/missing seq, or None
    prev, expect = GENESIS, None
    for r in sorted(rows, key=lambda r: r["seq"]):
        if expect is not None and r["seq"] != expect:        # contiguity → detects truncation/deletion
            return expect                                     # a gap means rows were removed
        if r["entry_hash"] != _h({"row": {k: r[k] for k in IMMUTABLE}, "prev": prev}):
            return r["seq"]                                   # mutation detected
        prev, expect = r["entry_hash"], r["seq"] + 1
    return None
在锁下追加:在同一事务中,使用 SELECT … FOR UPDATE(或咨询锁)读取尾部的 entry_hash 并执行 INSERT,否则两个并发追加会在相同的 prev_hash 上分叉链。
证明防篡改——用一个测试验证全部价值主张:
def test_tamper_detected():
    chain = seal_all([row(1), row(2), row(3)])     # three sealed, chained rows
    chain[1]["decision"] = {"label": "tampered"}    # mutate a sealed row in place
    assert verify_chain(chain) == chain[1]["seq"]   # detected exactly at the altered row
以及账本所服务的查询:
-- "why did the system do X, and what's its current state?" — the FULL supersede chain, both directions
WITH RECURSIVE lineage AS (
  SELECT * FROM decision_ledger WHERE decision_id = $1
  UNION
  SELECT d.* FROM decision_ledger d JOIN lineage l
    ON d.decision_id = l.supersedes      -- walk back to ancestors
    OR d.supersedes  = l.decision_id     -- walk forward to whatever superseded it
)
SELECT * FROM lineage ORDER BY seq;      -- the current state is the last row
-- auto-execution rate by capability, last 7 days
SELECT capability, avg((routing='auto')::int) FROM decision_ledger
 WHERE ts > now() - interval '7 days' GROUP BY capability;
账本是骨干,而非副作用:分析、漂移检测、覆盖率和调试都从中读取,decision_id 将每个条目与其追踪关联。因此,无条件地将条目写为每个决策的最后一个节点——绝不要“如果队列满了就跳过账本”,否则你的审计恰好在出问题时出现漏洞。
多租户代理的记忆模型
当你的代理服务多个客户——甚至多个用户——时,“记忆”就不再是一个功能,而变成了一个披着功能外衣的数据治理问题。单一未区分的记忆存储正是 PII 部分中侧向泄露的具体体现:跨租户数据暴露随时可能发生,且审计无法通过。解决方案不是更花哨的向量数据库;而是一个类型化的记忆模型——命名的类别,每个类别对范围、访问和敏感性有明确的规则,并在存储边界的代码中强制执行。
from enum import Enum

class MemoryCategory(Enum):
    TENANT_SHARED      = "tenant_shared"      # org-wide knowledge — NO personal data
    AGENT_NAMESPACE    = "agent_namespace"    # learned patterns (abstractions only, never raw records)
    WORKFLOW_CONTEXT   = "workflow_context"   # scratch state for ONE invocation; discarded after
    AUDIT              = "audit"              # immutable record; role-gated reads only
    SEMANTIC_KNOWLEDGE = "semantic_knowledge" # curated reference/grounding facts
    CONVERSATION       = "conversation"       # per-user, per-session; FIREWALLED from decision agents
重点不在于这六个具体类别——而在于每个数据项恰好属于一个类别,且类别决定规则。对于每个类别,明确三件事并在代码中强制执行,而非文档中:
category            scope (partition key)  who can read             may hold PII?
------------------  ---------------------  -----------------------  -----------------------------
TENANT_SHARED       tenant                 any caller in tenant     **no**
AGENT_NAMESPACE     tenant                 the system               patterns only, **no raw PII**
WORKFLOW_CONTEXT    invocation             that invocation          transient only
AUDIT               tenant                 audit role only          hashes/redacted
SEMANTIC_KNOWLEDGE  global/tenant          the system               curated, **no** user PII
CONVERSATION        user + session         that user's own session  yes, firewalled
租户作用域是不可协商的:每次读/写都携带 tenant_id(如果类别是用户作用域的,还携带 user_id),在存储层进行检查,跨租户访问是硬错误。
@dataclass
class Caller:                       # comes from the validated auth context, NOT the request body
    tenant_id: str
    user_id: str | None = None
    role: str | None = None

def partition_key(category, tenant_id, *, user_id=None, session_id=None, invocation_id=None) -> str:
    C = MemoryCategory                                          # each branch matches the table's scope column
    if category is C.WORKFLOW_CONTEXT:                          # invocation-scoped — the next run can't read it
        assert invocation_id, "workflow context is invocation-scoped"
        return f"{category.value}:{tenant_id}:{invocation_id}"
    if category is C.CONVERSATION:                             # per-user, per-session
        assert user_id and session_id, "conversation is per-user, per-session"
        return f"{category.value}:{tenant_id}:{user_id}:{session_id}"
    if category is C.SEMANTIC_KNOWLEDGE:                       # may be global; 'global' never collapses tenants together
        return f"{category.value}:{tenant_id or 'global'}"
    return f"{category.value}:{tenant_id}"                     # TENANT_SHARED, AGENT_NAMESPACE, AUDIT

def read(category, *, tenant_id, key, caller: Caller, user_id=None, session_id=None, invocation_id=None):
    enforce_access(category, tenant_id, caller, user_id)        # raises Forbidden on ANY violation
    return store.get(partition_key(category, tenant_id, user_id=user_id,
                                   session_id=session_id, invocation_id=invocation_id), key)

def enforce_access(category, tenant_id, caller: Caller, user_id):
    if caller.tenant_id != tenant_id:                          # THE cross-tenant gate
        raise Forbidden("cross-tenant access")
    if category is MemoryCategory.AUDIT and caller.role != "audit":
        raise Forbidden("audit memory is role-gated")
    if category is MemoryCategory.CONVERSATION:                 # firewall: only your OWN session
        if user_id is None or caller.user_id != user_id:
            raise Forbidden("conversation memory is per-user")

def write(category, *, tenant_id, key, value, caller: Caller, user_id=None, session_id=None, invocation_id=None):
    enforce_access(category, tenant_id, caller, user_id)
    if category in (MemoryCategory.TENANT_SHARED, MemoryCategory.AGENT_NAMESPACE) and contains_pii(value):
        raise Forbidden(f"{category} must not hold personal data")   # explicit raise, NOT assert (-O strips asserts)
    store.put(partition_key(category, tenant_id, user_id=user_id,
                            session_id=session_id, invocation_id=invocation_id), key, value)
防止尴尬泄露的防火墙是 CONVERSATION:用户 B 的决策代理绝不能读取用户 A 的对话。将其保留在独立的类别中,仅在 A 自己的会话内可读,并且绝不注入到共享决策路径中。这一边界防止了一整类“为什么 AI 知道关于我的这些事?”的事件——这也是对之前标记的侧向泄露的结构性答案。
在第一天就测试你最害怕的泄露——在边界处测试,而不是通过字符串搜索序列化上下文(数据的 base64 或嵌入会绕过子字符串检查):
def test_no_cross_tenant_read():
    write(MemoryCategory.TENANT_SHARED, tenant_id="A", key="policy", value="x", caller=Caller("A"))
    with pytest.raises(Forbidden):                                   # A's caller may not read B's partition
        read(MemoryCategory.TENANT_SHARED, tenant_id="B", key="policy", caller=Caller("A"))

def test_conversation_firewalled_to_owning_user():
    write(MemoryCategory.CONVERSATION, tenant_id="A", user_id="u1", session_id="s1", key="msg",
          value="secret", caller=Caller("A", user_id="u1"))
    with pytest.raises(Forbidden):                                   # u2 can't read u1's conversation
        read(MemoryCategory.CONVERSATION, tenant_id="A", key="msg",
             user_id="u1", session_id="s1", caller=Caller("A", user_id="u2"))
即使今天是单租户,这样编写也能让迁移到多租户成为配置更改而非重写。反模式包括:一个未区分的存储(无类别、无规则、最终泄露);“通常在应用程序中”过滤,而不是在每次访问时在存储边界处过滤;共享/命名空间内存中的原始记录(这些仅限抽象——在写入时检查);以及清除内存时抹掉精心整理的知识——这正是上一节旨在划定的边界。
种子 vs 运行时:你交付的内容 vs 系统获得的内容
我多次目睹的一个 bug:有人运行“清除内存”或“重置”来清除累积状态,结果也删除了系统运行所需的提示词、规则和参考数据。系统恢复后失忆了——不仅忘记了它学到的东西,还忘记了它是什么。
根本原因是缺少区分。在任何有状态 AI 系统中,有两种完全不同类型的数据,它们应该以不同的方式存储、版本化和生命周期管理:种子(你交付的内容——提示词、提示词版本、决策规则和策略、黄金集和评估基线、基础数据)和运行时(系统获得的内容——审计账本、学习到的记忆、漂移信号、事件、每会话上下文)。种子是基因组:由你编写,受版本控制,随部署一起发布,绝不被运行中的系统修改。运行时是经验:运行的副产品,可变,大部分可丢弃——清除它,系统仍然工作,回到基线行为,因为它的身份存在于种子中。
一种编码该边界的目录布局:
seed/            # shipped with the release, READ-ONLY at runtime, version-controlled
  prompts/
  rules/
  golden_sets/
  grounding/
runtime/         # earned by operating, mutable, clearable without breaking behavior
  ledger/        # decisions made (canonical audit)
  memory/        # learned/earned state
  drift/         # signals, incidents, governance
  sessions/      # per-invocation context
最重要的函数是作用域重置——守卫必须是真正的 raise,而不是 assert(生产环境使用 -O 运行会丢弃 assert 并静默允许种子被清除):
def clear_state(scope: str):
    if scope != "runtime":                            # explicit raise — `assert` is STRIPPED under python -O
        raise ValueError("refusing to clear seed — seed is shipped config, not state")
    for area in ("memory", "drift", "sessions"):      # NOT ledger by default — it's the audit record
        storage.purge(f"runtime/{area}")
    # seed/** is never touched. The amnesia bug cannot happen.
注意即使在运行时中,账本也会被保留——它是之前的审计记录;清除内存和会话,而不是历史。(注意:“清除运行时,行为返回种子基线”假设获得的记忆是附加上下文,而不是决策的承重输入——为你的系统明确这一假设。)
新行为不会从运行时悄悄进入系统的行为方式。你通过一个深思熟虑的、经过审查的步骤将验证过的运行时信号提升为种子:
runtime signal (e.g. a pattern recurs, humans keep correcting X the same way)
   └─▶ candidate (proposed prompt/rule/golden-case change)
        └─▶ review + eval gate (does it improve quality without regressing baseline?)
             └─▶ merged into seed/  → ships in the next release
系统在运行时绝不编辑自己的种子——那将是无版本、未经审查、不可复现的行为变更。学习是一个 PR,而不是副作用。这一边界让难题变得简单:重置只清除运行时;种子中的任何内容都不会在没有经过审查、评估门控的发布的情况下改变;任何种子驱动的内容在给定输入下都是可复现的,而明确学到的内容则不是;新行为总是来自通过审查提升的运行时信号,绝不是运行时 → 行为直接转换。
要点
这一层级的安全与治理不是你可以添加的功能,而是你需要编排的架构,四个部分相互强化。护栏在一个契约之后组合并故障关闭,因此单点故障就是被捕获的故障。PII 在每个边界处被擦除,并以哈希而非明文存储,因此 AI 所需的丰富上下文得以积累,而无需承担原始数据的责任——输出擦除只是一个护栏层,而账本哈希只是边界的 ledger_view。审计账本是仅追加、防篡改的,并作为每个决策的最终无条件步骤写入,因此“它在三月份为什么那样做?”只需查询一行即可获得可验证的谱系。内存是有类型和范围的,因此一个租户——或一个用户——的数据永远不会到达另一个租户的决策中,这是对横向泄漏的结构性治愈。而种子/运行时接缝使这一切可重置和可复现,学习通过审查流动,而不是就地改变行为。在 Level 4 中构建这些,系统就会成为一个你可以在审计下站得住脚的系统——而不是一个你只能为之道歉的系统。
系列:在生产环境中运行 LLM 系统——第 4 级(共 6 级):安全与治理。
这些文章根据 Creative Commons Attribution-ShareAlike 4.0 International 许可协议授权。
creativecommons.org/licenses/by-sa/4.0/deed.en
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Stack Overflow Blog
原文作者:Varun Jindal;如有侵权,请联系管理员删除。

