在 Amazon SageMaker HyperPod 上微调 GPT-OSS-20B 以实现多语言推理 | Amazon Web Services
GPT-OSS-20B 是一个开放权重的推理模型,它以英语进行思考。要求它用法语、德语、西班牙语或意大利语推理时,它会确认该指令,但随后仍然用英语生成其思维链。在一个包含 50 个示例的多语言推理测试中,基础模型仅在 22% 的情况下用正确的目标语言进行推理。这 22% 几乎全部来自英语示例(英语 100%,法语 0%,德语 10%,西班牙语 0%,意大利语 0%)。
对于为非英语用户部署推理模型的团队来说,这一差距至关重要。用法语提问的用户期望模型用法语推理和回答,而不是在思考中途切换到英语。弥合这一差距是一个微调问题。这引出了每个团队在开始定制开放权重模型时都会面临的问题:监督微调(SFT)、使用组相对策略优化(GRPO)的强化学习,还是两者兼用?
在本文中,我们将介绍如何在 Amazon SageMaker HyperPod 上微调 GPT-OSS-20B 以实现多语言推理。我们将展示仅使用 SFT 何时已经足够,以及 GRPO 何时在其基础上增加了可衡量的价值。为了更广泛地理解 GRPO 何时有帮助,我们还在两个具有不同能力差距的任务上运行了一个受控的 Qwen2.5-7B 实验。简短的答案是:SFT 完成了大部分工作,GRPO 在有改进空间时进行优化,而将技术与能力差距相匹配才是决定结果的关键。
解决方案概述
本节涵盖多语言推理任务和数据集、SFT 和 GRPO 如何互补,以及我们在 Amazon SageMaker HyperPod 上运行的训练栈。
任务和数据集
数据集是 HuggingFaceH4/Multilingual-Thinking——一个思维链推理数据集,除英语外还被翻译成法语、西班牙语、德语和意大利语,大约有 949 个训练示例和 50 个验证示例。模型接收一个推理语言:系统提示指令,并且必须用该目标语言进行推理和回答,覆盖其强烈的英语先验。评估包含 50 个测试用例:5 种语言(EN/FR/DE/ES/IT)的 10 个数学/逻辑问题。
推理语言正确——思维链是否使用了请求的语言?
答案语言正确——最终答案是否使用了请求的语言?
SFT 和 GRPO 如何配合
思考这两种技术最清晰的方式是:SFT 教模型一种它不具备的行为。GRPO 优化模型已经有时能够产生的行为。GRPO 的工作原理是为每个提示采样一组响应,并将策略推向高于平均水平的响应。如果期望的行为在基础分布中的概率为零,那么 GRPO 几乎没有可强化的内容。这一个想法解释了本文中几乎所有的结果。
训练技术栈
我们在 Amazon SageMaker HyperPod 上运行,并使用 Amazon Elastic Kubernetes(容器编排平台) Service(Amazon EKS)进行编排。对于 GPT-OSS-20B 的初始 SFT 和 GRPO 运行,我们使用了 PyTorch TRL 库。对于 Qwen 对照实验,我们改用 veRL 作为训练器,并使用 Ray 和 KubeRay 进行分布式编排,使用 vLLM 进行快速 rollout 生成。检查点和数据集存放在 Amazon FSx for Lustre 上,节点间通信结构使用 Elastic Fabric Adapter(EFA)。所有微调均使用 Low-Rank Adaptation(LoRA),该方法参数高效,非常适合 SFT 和 GRPO。
下图展示了端到端的训练数据路径。用户提交的任务到达 Amazon SageMaker HyperPod 集群的 Amazon EKS 控制平面。Amazon EKS 调度一个 Ray head pod 以及运行 veRL 训练器和 vLLM rollout worker 的 worker pod。这两组 pod 都挂载 Amazon FSx for Lustre,用于存放基础模型、训练数据和检查点。节点间集合通信使用 EFA。Rollout 从 vLLM 流式传输回 veRL 训练器,训练器将检查点写回 Amazon FSx for Lustre。
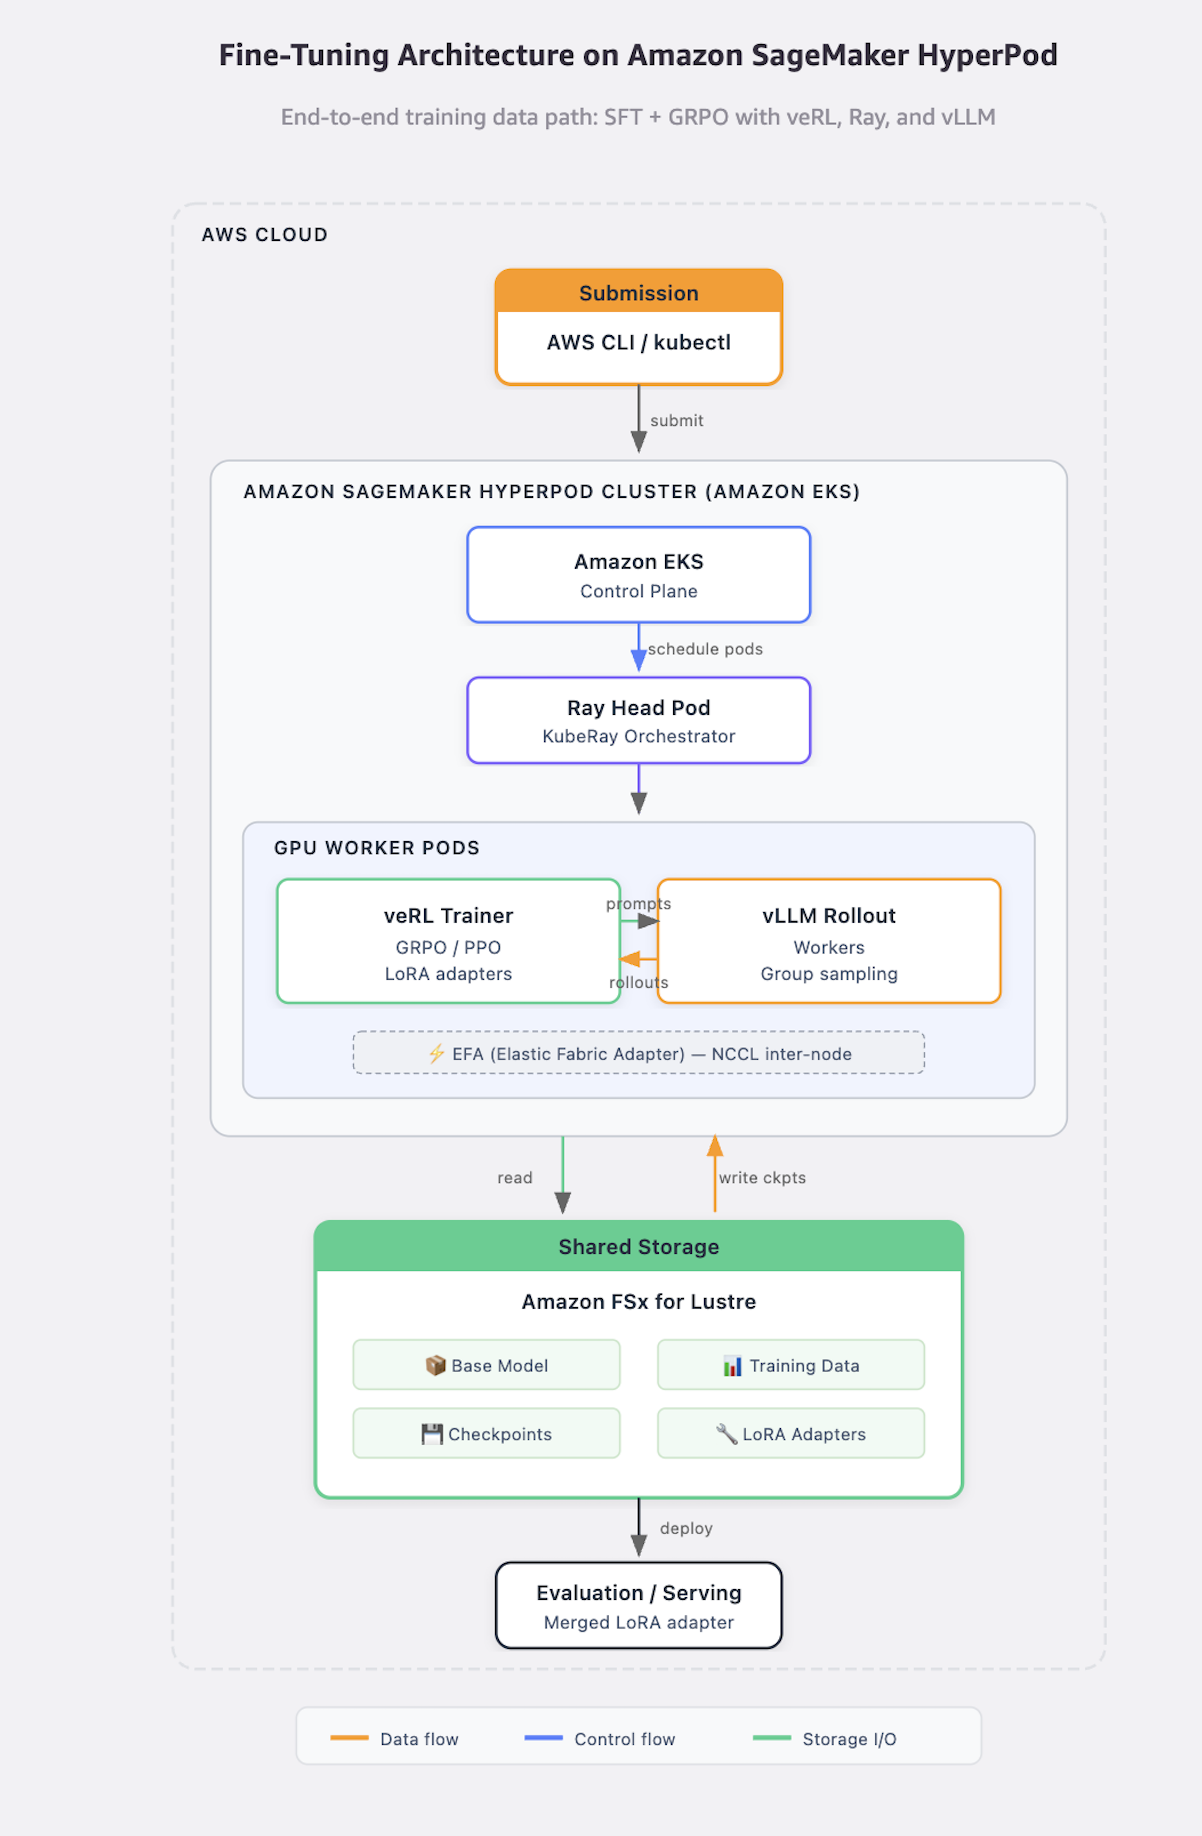
图 1:在 Amazon SageMaker HyperPod 上使用 veRL、Ray、KubeRay、vLLM 和 Amazon FSx for Lustre 进行 Qwen 对照实验的 SFT 和 GRPO 微调端到端训练数据路径
以下更详细地描述每一跳。提交者从 Amazon SageMaker Studio 或 AWS Command Line Interface(AWS CLI)启动运行。Amazon SageMaker HyperPod 上的 Amazon EKS 控制平面将 pod 放置在 GPU(图形处理器) 节点上,并启动一个 Ray head 以及用于 veRL 训练器和 vLLM rollout worker 的 worker pod。Amazon FSx for Lustre 为基础模型、训练数据和检查点提供共享的高吞吐量存储。训练完成后,训练器将 LoRA 适配器写回 Amazon FSx for Lustre,以供下游评估或服务使用。
先决条件
要跟随操作,你需要:
一个使用 Amazon EKS 编排的 Amazon SageMaker HyperPod 集群。GPT-OSS SFT 使用了 4× ml.g6e.12xlarge(16× L40S 48GB)。Qwen 对照使用了 2× g6e.48xlarge(16× L40S)。
一个挂载在集群上的 Amazon FSx for Lustre 文件系统,并在 /fsx 处有一个名为 fsx-claim 的 PersistentVolumeClaim。
支持 EFA 的实例,以及用于多节点 SFT 的可正常工作的 NVIDIA Collective Communications Library(NCCL)和 aws-ofi-nccl 栈。
一个容器注册表,例如 Amazon Elastic Container Registry(Amazon ECR),用于存放从参考仓库构建的训练镜像。
用于 openai/gpt-oss-20b 和 HuggingFaceH4/Multilingual-Thinking 数据集的 HuggingFace 访问令牌。
你的工作站上可用的 AWS Command Line Interface(AWS CLI)、kubectl、docker 和 envsubst。
设置训练环境
下面引用的所有命令、清单和脚本都位于 awsome-distributed-ai GitHub 仓库的 3.test_cases/pytorch/trl/gpt-oss-lora-grpo/ 下。克隆仓库并切换到测试用例目录:
git clone https://github.com/awslabs/awsome-distributed-ai
cd awsome-distributed-ai/3.test_cases/pytorch/trl/gpt-oss-lora-grpo
复制环境模板,然后编辑 env_vars 以设置你的 ECR 注册表、镜像名称、标签和 HuggingFace 令牌:
cp env_vars.example env_vars
source env_vars
构建训练镜像并将其推送到你的注册表。该镜像捆绑了 PyTorch、TRL、HuggingFace Transformers、PEFT 以及训练和推理脚本:
cd artifacts && ./build_push.sh && cd ..
将 kubectl 指向你的集群,并应用 FSx 存储管理器 pod。存储管理器为你提供一个进入共享文件系统的 shell,用于检查点转换和评估日志检查:
aws eks update-kubeconfig --name--region us-east-2
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/fsx-storage-manager.yaml | kubectl apply -f -
使用 SFT 和 LoRA 微调 GPT-OSS-20B
我们首先测量基础模型,然后配置 SFT 运行并检查结果。
基础模型的差距
基础 GPT-OSS-20B 在 50 个案例的评估中,推理语言正确率为 22%(11/50)。按语言划分:英语 100%,法语 0%,德语 10%,西班牙语 0%,意大利语 0%。无论指令如何,模型默认使用英语推理。
SFT 配置
SFT 设置使用 LoRA r=8、α=16,在 4× ml.g6e.12xlarge(16× L40S 48GB)上训练 1,000 步,采用完全分片数据并行(FSDP)全分片、bf16 精度和梯度检查点。该作业作为由 Kueue 管理的弹性 HyperPodPyTorchJob 运行,通过 hyperpodrun 启动。
应用 SFT 清单:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < hyperpod-eks/train-lora-hyperpod-elastic-g6e.yaml | kubectl apply -f -
监控训练进度:
kubectl get pods -l app=gpt-oss-lora-elastic
kubectl logs -f -l app=gpt-oss-lora-elastic
每一步都会打印损失和梯度范数。健康的运行如下所示:
{'loss': 1.035, 'grad_norm': 0.163, 'learning_rate': 0.0002, 'mean_token_accuracy': 0.716, 'epoch': 3.25}
{'loss': 1.003, 'grad_norm': 0.171, 'lr': 0.0002, 'acc': 0.722, 'epoch': 3.32}
{'loss': 0.976, 'grad_norm': 0.159, 'lr': 0.0002, 'acc': 0.726, 'epoch': 3.57}
训练完成后,将 FSDP 检查点转换为 TRL 的 GRPO 训练器和推理脚本所期望的参数高效微调(PEFT)格式:
kubectl exec -it fsx-storage-manager -- python /app/convert_fsdp_checkpoint.py \
  --checkpoint /fsx/checkpoints/checkpoint-1000 \
  --output    /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft
SFT 结果与分阶段学习曲线
经过 SFT 后,模型在所有五种语言中 100% 的情况下(50/50)用正确的语言进行推理。SFT 分两个阶段学会了这一点:
大约在第 200 步,模型学会了用目标语言进行推理(推理语言指标达到 100%)。
大约在第 1000 步,模型进一步学会了用目标语言给出答案。
最终 SFT 评估(第 1000 步):
推理语言正确:100%(50/50)。
答案语言正确:62%(31/50)。
两者均正确:62%(31/50)。
各语言答案准确率:FR 60%,DE 60%,ES 30%,IT 60%,EN 100%。
要点:SFT 在这里不是可选项。基础模型完全无法遵循推理语言指令,而 SFT 将推理语言从 22% 提升到 100%。剩余的差距在于答案语言,为 62%。这是更难的一半,因为最终答案很短,而英语先验在那里最强。
使用 GRPO 改进答案语言
答案语言是 GRPO 的明显目标。SFT 已经 100% 产生正确的推理,并且模型有时会用正确的语言给出答案,因此有信号可以强化。
在 SFT 检查点之上运行 GRPO
我们使用 TRL 的 GRPOTrainer 运行 GRPO,从 SFT 检查点开始。设置:加载 SFT LoRA,调用 merge_and_unload,并添加新的 LoRA(r=8,α=16,约 0.068% 可训练参数,20B 中的 13.6M)。训练使用每个提示 K=8 次生成,device_map=auto,学习率 1e-6,10 个 epoch。奖励函数对答案语言(±5.0)、推理语言(±1.5)和简洁性(+0.5 或 −1.0)进行评分,总范围为 −7.5 到 +7.0。
从转换后的 SFT 检查点启动 GRPO:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/train-grpo-singlenode.yaml | kubectl apply -f -
kubectl logs -f grpo-single
GRPO 将检查点写入 /fsx/checkpoints/grpo-singlenode/。根据你的留出评估选择最佳检查点(答案语言指标在此次运行中早期达到峰值),并将其转换为 PEFT 格式以进行推理和评估。
结果(来自 SFT 检查点):
推理语言正确率:100%(保持:GRPO 没有破坏 SFT 所教的内容)。
回答语言正确率:62% 至 70%(+8 个百分点,35/50)。
两者均正确:70%。
各语言回答正确率:FR 70%,DE 80%,ES 60%,IT 40%,EN 100%。
GRPO 在回答语言指标上带来了真实的 +8 个百分点提升,同时将推理保持在 100%。提升出现在有提升空间的地方。回答语言是 SFT 尚未完全收敛的有时正确的行为,GRPO 对其进行了强化。
并排比较 base、SFT 和 GRPO 推理
要查看定性差异,请部署三个推理 Pod,它们共享相同的基础模型但加载不同的适配器:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-base.yaml    | kubectl apply -f -
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-trained.yaml | kubectl apply -f -
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-grpo.yaml    | kubectl apply -f -
通过每个变体运行相同的法语推理提示:
kubectl exec -it inference-base    -- python /app/inference_g6e.py \
  --reasoning_language French

kubectl exec -it inference-trained -- python /app/inference_g6e.py \
  --checkpoint /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft \
  --reasoning_language French

kubectl exec -it inference-grpo    -- python /app/inference_grpo_new.py \
  --use_grpo \
  --grpo_checkpoint /fsx/checkpoints/converted-peft/checkpoint-1470-peft \
  --reasoning_language French
base Pod 尽管有指令仍用英语推理。SFT Pod 用法语推理但通常用英语回答。GRPO Pod 用法语推理并用法语回答。要复现生成前面数字的完整 50 个案例评估,请运行评估清单并从 FSx 存储管理器读取结果文件:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/eval-grpo.yaml | kubectl apply -f -
kubectl logs -f eval-grpo
kubectl exec fsx-storage-manager -- \
  cat /fsx/experiments/grpo_eval_checkpoint1470_*.txt
为了更广泛地理解 GRPO 何时增加价值,我们在 Qwen2.5-7B 上针对两个具有不同能力差距的任务进行了受控实验。
用 Qwen2.5-7B 对照测试该模式
为了在不同模型和不同任务上测试“将技术与能力差距匹配”的论点,我们在 Qwen2.5-7B-Instruct 上进行了受控实验。第一个任务与多语言推理任务相同(存在提升空间)。第二个任务是 GSM8K,该模型在此任务上已达到峰值准确率。这是一项内部实验,公共仓库尚未发布。
基础设施:2× g6e.48xlarge(16× L40S),EFA 100Gbps,FSx Lustre,Ray 2.44 + KubeRay 1.4.2,veRL v0.6.1,vLLM 0.8.4。
实验组:A = base,B = 仅 SFT,C = SFT+GRPO。
多语言推理(50 个案例)
| 指标 | A 基础 | B SFT | C SFT+GRPO | Δ GRPO |
| --- | --- | --- | --- | --- |
| 结构化格式 | 0% | 92% | 98% | +6 |
| 推理语言 | 0% | 96% | 98% | +2 |
| 答案语言 | 0% | 38% | 44% | +6 |
| 两者均正确 | 0% | 38% | 44% | +6 |
GSM8K:一个没有提升空间的任务
在 GSM8K 上,基础 Qwen2.5-7B 已经达到 90.5%(181/200)。第 30 步的 GRPO 同样达到 90.5%。当大多数采样组全部正确时,组相对优势会坍缩为零,因此没有学习信号。这是该论点的另一半:GRPO 需要提升空间(pass@k >> pass@1)才有可优化的内容。没有提升空间就意味着没有收益。
最佳实践
从 SFT 开始。GRPO 无法教会模型一个基础概率为零的行为。它只能强化模型已经偶尔产生的响应。SFT 将推理语言从 22% 提升到 100%,而本工作中 GRPO 的每一次收益都建立在该 SFT 检查点之上。
在 SFT 和 GRPO 中都使用 LoRA。LoRA r=8/α=16 具有参数效率(可训练参数占 0.068%),并且在 Qwen 对照实验中,它在 GRPO 过程中保持数值稳定(梯度范数 0.23,每 GPU 约 11.7 GB)。当你希望 SFT 和 GRPO 共享相同的适配器形状时,这是一个强有力的默认选择。
让技术与差距相匹配。使用 SFT 来弥补缺失的行为。使用 GRPO 来优化已有的、有时正确的行为。GRPO 在此处的现实上限是 +6 到 +8 分。
在花费 GPU 小时之前检查奖励提升空间。如果大多数组全部正确(GSM8K 基础为 90.5%),组相对优势会坍缩为零,GRPO 得不到梯度。在开始 GRPO 运行之前,验证是否存在提升空间(pass@k >> pass@1)。
清理资源
为避免持续产生费用,请先删除工作负载资源,然后删除底层基础设施:
删除训练和推理 Pod 及作业:kubectl delete hyperpodpytorchjob lora-hyperpod-elastic --ignore-not-found kubectl delete pod grpo-single inference-base inference-trained inference-grpo \ eval-grpo fsx-storage-manager --ignore-not-found
缩减或删除 Amazon SageMaker HyperPod 集群或其节点组。
在导出要保留的检查点后,删除 Amazon FSx for Lustre 文件系统。
删除用于训练数据或检查点归档的任何 Amazon Simple Storage Service(Amazon S3)存储桶或对象。
结论
我们展示了如何在 Amazon SageMaker HyperPod 上为 GPT-OSS-20B 进行多语言推理微调,以及如何在 SFT 和 GRPO 之间做出选择。SFT 完成了大部分工作:推理语言从 22% 提升到 100%。GRPO 在此基础上增加了真实但适度的优化(答案从 62% 提升到 70%),前提是存在提升空间。并行的 Qwen2.5-7B 对照实验证实了这一模式。GRPO 在多语言推理上增加了 +6%,因为那里有改进空间。它在 GSM8K 上没有带来收益,因为模型已经达到峰值准确率(90.5%)。
模型完全无法做到的行为:使用 SFT。
模型有时能做到、且有提升空间的行为:先使用 SFT,再使用 GRPO 以获得额外几分。
模型已达到峰值准确率,或目标的基础概率为零:GRPO 不会有所帮助。
要自行尝试,请逐步运行 awsome-distributed-ai 仓库中的测试用例。有关 Amazon SageMaker HyperPod 的更多信息,请参阅服务详情页和 Amazon SageMaker HyperPod 文档。有关在 Amazon SageMaker HyperPod 上使用 Ray 的演练,请参阅相关文章《Running distributed training on Amazon SageMaker HyperPod with Ray and Amazon SageMaker Studio》。该链接将在文章发布后添加。欢迎在评论中分享你的结果。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Mijanur Palash;如有侵权,请联系管理员删除。

