使用 ARC Zonal Shift 运行多日可用区疏散演练,是证明应用程序能够承受持续故障的有效方式。多可用区部署是在 AWS 上构建弹性应用程序的架构最佳实践,但在部署多可用区与证明其能在持续压力下正常工作之间仍存在差距。传统的灾难恢复(DR)测试验证的是故障转移机制。典型测试会转移流量、确认目标响应,并在几分钟内回滚。这些短时演练无法暴露那些仅在数小时或数天后才会出现的问题。
多日可用区疏散会迫使依赖时间的行为完全展开,从而暴露短时测试所遗漏的故障模式:
Auto Scaling 策略未针对全天持续 N-1 运行进行调优。
部署管道在放置新工作负载前未验证可用区健康状态。
过期的 DNS 或缓存的数据库端点。
基于时间的例行运维流程在 N-1 架构下进行测试(证书轮换、凭证和密钥轮换、维护窗口、日志轮转、备份自动化以及 cron 任务)。
长期存在的数据库连接被固定到特定可用区,但仅被不频繁地使用。
持续多日切换后的恢复,这是一种与在几分钟内回滚到温暖且几乎相同的可用区不同的运维流程。
通过使用 Amazon Application Recovery Controller (ARC) Zonal Shift 将所有流量从单个可用区转移开 48–72 小时,您将迫使架构在 N-1 个可用区上维持完整生产负载。这证明了容量充足性、数据库稳定性以及客户端重连行为,但最重要的是,证明您的团队能够在 N-1 容量下正常运行数天。
本文向您展示如何跨 Amazon Elastic Container Service (Amazon ECS)、Amazon Elastic Kubernetes(容器编排平台) Service (Amazon EKS)、Amazon Relational Database Service (Amazon RDS) for PostgreSQL(开源关系型数据库) 和 Amazon Aurora PostgreSQL 规划和运行多日可用区疏散演练,包括分步 CLI 命令、先决条件部分、可观测性指标以及恢复流程。
为什么金融服务机构已经在这样做
金融服务组织面临独特的监管压力,要求其不仅记录灾难恢复能力,还要证明该能力。在全球范围内,受监管实体越来越关注构建和展示运营韧性。这正在将思维模式从“向我们展示您的运行手册”转变为“向我们展示证据”。控制环境的这种提升正推动金融服务公司开展真实条件下的实时 DR 测试,并在规定时间范围内生成可审计的恢复证明。一些保险公司和银行现在正在将定期可用区疏散演练作为其运营韧性计划的一部分,从“我们有多可用区”转向“我们已证明多可用区”。使用 ARC Zonal Shift,您可以在基础设施层转移流量,而无需更改应用程序代码。它原生适用于 Application Load Balancer、Network Load Balancer、Amazon Elastic Compute Cloud (Amazon EC2) Auto Scaling 组和 Amazon EKS 集群。
解决方案概述
在本演练中,我们演示如何为运行在 AWS 上的多层数字平台疏散一个可用区。
我们有意同时包含 ECS 和 EKS,以及两种数据库引擎,以展示读者可能运行的主要服务类型各自的疏散流程。该架构仅用于说明。
下表概述了该架构:
| 层级 | 组件 | 多可用区配置 |
| --- | --- | --- |
| 流量入口 | 面向 ECS 的 Application Load Balancer (ALB) | 部署在 3 个可用区,已启用跨区域负载均衡 |
| 计算(容器) | Amazon ECS (Fargate) | 无状态任务分布在 3 个可用区子网 |
| 流量入口 | 面向 EKS 的 Network Load Balancer (NLB) | 部署在 3 个可用区,已启用跨区域负载均衡 |
| 计算(Kubernetes) | Amazon EKS 或 EKS Auto Mode | 无状态服务通过拓扑分布约束分布在 3 个可用区 |
| 数据库 | Amazon RDS for PostgreSQL | 多可用区:主实例在可用区 A,备用实例在可用区 B |
| 数据库 | Amazon Aurora PostgreSQL | 写入器在可用区 A,读取器在可用区 B。存储跨所有 3 个可用区复制 |
请注意,Aurora 存储层与标准 RDS 多可用区不同。Aurora 独立于计算实例,将数据同步复制到跨可用区的六个存储节点,因此只需对写入器或读取器实例进行故障转移,因为存储在整个演练过程中始终保持完全可用。
在本演练中,我们撤离可用区 A,即承载 RDS 主实例和 Aurora 写入器的区域。
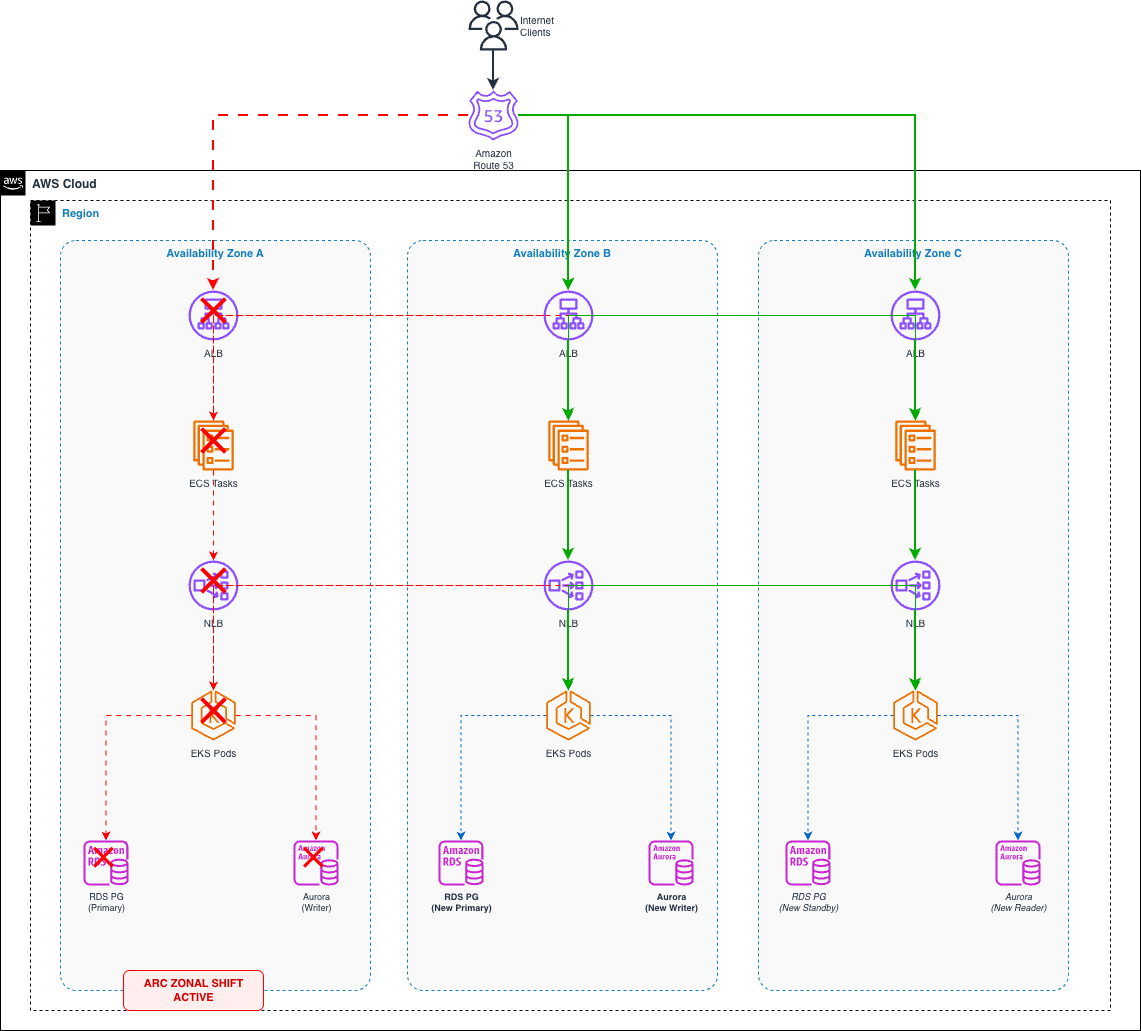
ARC Zonal Shift 的工作原理
当您启动区域转移时,ARC 会针对 Amazon Route 53 和 Elastic Load Balancer 采取两项协调操作:
DNS 移除:受影响可用区中负载均衡器的 IP 地址会从 DNS 中移除。新的客户端查询不会解析到该端点。
跨区域流量阻断:其余可用区中的负载均衡器节点停止将请求路由到已转移可用区中的目标,即使已启用跨区域负载均衡也是如此。
对于启用了区域转移的 Amazon EKS 集群,ARC 会进一步执行以下操作:
封锁受影响可用区中的所有节点,阻止新的 Pod 调度。
从 EndpointSlice 资源中移除受影响可用区中的 Pod 端点,将东西向服务间流量重定向到健康的可用区。
暂停托管节点组的可用区再平衡,并更新 ASG 以仅在健康的可用区中启动实例。
保留已转移可用区中的节点和 Pod(它们不会被终止),在转移结束后保持完整容量可用。
结合针对 ECS 任务重新分配和数据库故障转移的服务特定流程,这在所有三个流量维度上实现了完整的可用区撤离:南北向入口、东西向服务通信以及出站数据库连接。
ARC Zonal Shift 在设计上是一种数据平面操作。由于它独立于 AWS 控制平面运行,即使在可用区受损期间也仍然可用。本演练中的其他步骤(ECS 服务更新、手动 RDS 故障转移、手动 Aurora 故障转移、子网组修改)属于控制平面操作。对于计划内演练,这一区别没有实际影响,因为控制平面是健康的。在真实的可用区受损期间,应优先执行数据平面操作(首先启动区域转移以立即停止流量),并且仅在流量已经转移后才执行控制平面操作。
先决条件
在首次轮班之前,请提前配置好这些先决条件。这些是基础设置,用于验证你的架构在任何时候都具备轮班就绪状态。在本演练中,你应具备以下条件:
一个 AWS 账户
一个跨 3 个可用区部署的多层应用,包含 ALB/NLB、ECS 或 EKS 工作负载,以及 RDS 或 Aurora 数据库。
用于管理 ARC Zonal Shift、ECS、EKS 和 RDS 资源的 IAM 权限。
已安装并配置 AWS Command Line Interface (AWS CLI) v2。
熟悉 ARC Zonal Shift 概念。
包含按可用区指标细分(故障率、延迟和目标健康状态)的 Amazon CloudWatch 仪表板。
已验证可在持续 N-1 可用区运行模式下工作的 Auto Scaling 策略。
具体针对 Elastic Load Balancing (ELB):
将 ALB/NLB 注销延迟设置为 60 秒,使现有连接在轮班后快速排空,而不是使用默认的 300 秒。
在每个目标组上配置 target_group_health.dns_failover.minimum_healthy_targets.count。
具体针对 EKS:
已为你的 EKS 集群安装并配置 kubectl。
在 EKS 服务上开启 Topology Aware Routing(或配置 Istio 位置感知负载均衡)。
在你的 EKS 集群上激活 zonal shift(一次性设置)。
具体针对 ECS:
在任务定义中将 ECS stopTimeout 设置为 55 秒,略低于 ALB 注销延迟,以便任务在被强制停止前完成正在处理的请求,避免在排空窗口期间出现 502 错误。
具体针对 RDS:
验证你的 RDS 主实例和备用实例是否预置在不同的可用区。
多日轮班有哪些变化
无论你运行 1 小时还是 72 小时,启动 zonal shift 的机制都是相同的。变化的是运维涉及面:
过期管理:区域转移有最大持续时间。您必须在它们过期前监控并延长,否则流量会意外返回到被转移的可用区。
扩缩容漂移:数天后,健康可用区中的 Auto Scaling 事件可能会导致容量不平衡。监控并限制扩缩容,以免恢复过程使返回的可用区过载。
连接池轮换:24 小时以上后,大多数客户端连接将已回收。这可在整个客户端集群中验证 DNS TTL 合规性,而 1 小时的测试无法完全覆盖这一点。
运维信心:团队将学会在减少一个可用区的环境中部署、修补和排查故障。多天的演练会促使这种情况自然发生,而不是在受控时间窗口内发生。
安全恢复:在 N-1 容量下运行数天后,恢复被转移的可用区需要谨慎安排顺序。验证健康状况,逐步缩容,并以增量方式重新引入流量,而不是一次性全部恢复。
解决方案详情
以下各节将逐一介绍架构中每一层的区域转移流程,从计算层开始,到数据库层结束。
Amazon ECS — 通过任务重新分配进行区域转移
对于位于 ALB 后的 ECS 服务,在负载均衡器层发起区域转移会阻止新流量到达被疏散可用区中的目标。该可用区中现有的 ECS 任务会继续运行,但会停止接收请求。要执行完整疏散,请按照以下步骤操作:
步骤 0。开始之前,请验证负载均衡器上已启用 ARC Zonal Shift(默认禁用)
aws elbv2 modify-load-balancer-attributes \
    --load-balancer-arn $ALB_ARN \
    --attributes Key=zonal_shift.config.enabled,Value=true
步骤 1。在负载均衡器上发起区域转移。
aws arc-zonal-shift start-zonal-shift \
    --resource-identifier $ALB_ARN \
    --away-from $AZ_ID_TO_EVACUATE \
    --expires-in "72h" \
    --comment "Multi-day AZ evacuation drill"
区域转移会在 --expires-in 中设置的持续时间后过期。如果转移在您取消之前过期,流量会自动返回到被转移的可用区。对于多天演练,请监控剩余时间,并在过期前使用以下命令延长:
aws arc-zonal-shift update-zonal-shift \
    --zonal-shift-id $SHIFT_ID \
    --resource-identifier $RESOURCE_ARN \
    --expires-in "24h" \
    --comment "Extending drill"
当启用跨区域负载均衡时(ALB 的默认设置),该转移会指示健康可用区中的负载均衡器节点不要将请求路由到受损可用区中的目标。无论您的跨区域配置如何,目标都会被完全隔离。
步骤 2。将新任务放置限制在健康可用区。
更新 ECS 服务的网络配置,以排除被疏散可用区中的子网。这会阻止新任务在被转移的可用区中启动:
aws ecs update-service \
    --cluster $CLUSTER_NAME \
    --service $SERVICE_NAME \
    --network-configuration "awsvpcConfiguration={subnets=[$AZB_SUBNET,$AZC_SUBNET],securityGroups=[$SG_ID],assignPublicIp=DISABLED}"
步骤 3。如有需要,进行扩缩容以验证 N-1 可用区容量。
aws ecs update-service \
    --cluster $CLUSTER_NAME \
    --service $SERVICE_NAME \
    --desired-count $N_MINUS_1_COUNT
注意:更新 ECS 服务网络配置和所需数量属于控制平面操作。请在演练开始前执行这些更改,而不是在真实可用区(AZ)故障期间执行,因为此时控制平面可用性可能已经降级。
我们建议你在演练前预先扩展服务,以应对一个可用区容量损失。你的架构应能在无需反应式扩展的情况下容忍可用区损失。请参阅 Amazon Builders' library 中的静态稳定性。
在 3 个可用区环境中,为 N-1 容量进行预扩展意味着运行的计算资源大约比基线峰值所需多 50%。如果对所有工作负载而言成本不合理,可以考虑在计划演练窗口期间增加容量的计划扩展策略、采用激进扩容阈值的 Auto Scaling,或负载削减机制。请记住,在非计划故障期间,你没有时间进行反应式扩展。未预扩展的工作负载将在降级状态下运行,直到扩展跟上,这在负载下可能需要数分钟。
步骤 4. 监控任务分布。
aws ecs describe-tasks \
    --cluster $CLUSTER_NAME \
    --tasks $(aws ecs list-tasks --cluster $CLUSTER_NAME --service-name $SERVICE_NAME --query 'taskArns' --output text) \
    --query 'tasks[].[taskArn,availabilityZone]' --output table
恢复:将网络配置恢复为包含全部三个可用区子网,然后取消 zonal shift。任务将在后续部署期间逐步在所有可用区之间重新平衡。
重要:zonal shift 不适用于单可用区目标组,因为如果健康目标仅存在于一个可用区,ALB 将拒绝该切换。在继续之前,请验证每个目标组至少在两个可用区中注册了目标。有关更多详细信息,请参阅 ARC 文档中的 Application Load Balancers。
Amazon EKS — 使用 EndpointSlice 隔离的 Zonal Shift
Amazon EKS 原生支持 ARC zonal shift。当你开启此能力并触发切换时,ARC 会自动处理基础设施和 Kubernetes 网络层。
当你对 EKS 集群执行 zonal shift 时,ARC 会执行以下操作:
受影响可用区中的节点会被 cordon(不再调度新 Pod)。
内置的 Kubernetes EndpointSlice 控制器会移除受影响可用区中的 Pod 端点,因此东西向服务流量会自动重定向到健康可用区中的 Pod。
对于托管节点组,可用区再平衡会被暂停,ASG 会被更新为仅在健康可用区中启动。
被切换可用区中的节点和 Pod 不会被终止,从而确保切换结束时容量可立即完全可用。
步骤 1. 为你的 EKS 集群激活 zonal shift(一次性设置):
aws eks update-cluster-config \
    --name $CLUSTER_NAME \
    --zonal-shift-config enabled=true
步骤 2. 在负载均衡器和 EKS 集群上启动 zonal shift:
# Shift north-south traffic at the load balancer
aws arc-zonal-shift start-zonal-shift \
    --resource-identifier $NLB_ARN \
    --away-from $AZ_ID_TO_EVACUATE \
    --expires-in "72h" \
    --comment "Multi-day AZ evacuation drill - north-south traffic"

# Shift east-west traffic within the EKS cluster
aws arc-zonal-shift start-zonal-shift \
    --resource-identifier $EKS_CLUSTER_ARN \
    --away-from $AZ_ID_TO_EVACUATE \
    --expires-in "72h" \
    --comment "Multi-day AZ evacuation drill - east-west traffic"
步骤 3. 验证 EndpointSlice 更新:确认已迁移可用区中的 Pod 不再接收流量:
# Endpoints should only show AZ B/AZ C
kubectl get endpointslices -l kubernetes.io/service-name=$SERVICE_NAME -o yaml | \
    grep -A2 "zone:"
步骤 4. 验证节点和 Pod 状态:
# Nodes in evacuated AZ should show SchedulingDisabled
kubectl get nodes -l topology.kubernetes.io/zone=$AZ_NAME_TO_EVACUATE

# Confirm traffic distribution across healthy AZs
kubectl get pods -o wide -l app=$APP_LABEL
验证你的 Pod 是否在 topology.kubernetes.io/zone 上使用 maxSkew: 1 的 topologySpreadConstraints,并且已预先扩展以处理 N-1 可用区负载。区域转移本身不会驱逐 Pod 或触发自动扩缩容。
请注意,ARC 区域转移不控制 Pod 到外部依赖(如 Amazon RDS)的出站连接。如果你的 Pod 连接到特定可用区的数据库端点,请考虑使用具有位置感知路由的 Istio。有关实现细节,请参阅 End-to-end recovery from AZ impairments in EKS using Zonal Shift and Istio。
对于 Aurora,集群端点会自动路由到当前写入器,无论可用区如何,因此写入器流量无需 Istio 配置。但是,如果你使用特定可用区的读取器实例端点,请为每个端点配置 Istio ServiceEntry 资源,并应用带有 localityLbSetting 的 DestinationRule 以优先选择健康的可用区。这将引导出站数据库流量遵循与南北向和东西向流量相同的转移模式。
恢复:取消两个区域转移。ARC 会自动取消节点封锁,将 Pod 端点添加回 EndpointSlices,并恢复可用区再平衡。流量返回到所有三个可用区,且容量已完全就位。
aws arc-zonal-shift cancel-zonal-shift \
    --zonal-shift-id $EKS_SHIFT_ID \
    --resource-identifier $EKS_CLUSTER_ARN

aws arc-zonal-shift cancel-zonal-shift \
    --zonal-shift-id $NLB_SHIFT_ID \
    --resource-identifier $NLB_ARN
Amazon RDS for PostgreSQL — 多可用区故障转移
关于多可用区部署中的 Amazon RDS for PostgreSQL,如果主实例位于正在疏散的可用区中,你必须触发到同步备用实例的故障转移。RDS 通过带故障转移的重启来处理此操作。
前提条件:验证你的 RDS 主实例和备用实例是否在不同的可用区中预置。如果两者位于同一可用区,以下步骤将无法按预期疏散该可用区。
步骤 1. 检查当前主实例位置:
aws rds describe-db-instances \
    --db-instance-identifier $RDS_INSTANCE \
    --query 'DBInstances[0].[DBInstanceIdentifier,AvailabilityZone,MultiAZ,SecondaryAvailabilityZone]' \
    --output table
步骤 2. 如果主实例位于被疏散的可用区中,手动强制故障转移:
aws rds reboot-db-instance \
    --db-instance-identifier $RDS_INSTANCE \
    --force-failover
步骤 3. 等待可用性并验证新的主实例可用区:
aws rds wait db-instance-available \
    --db-instance-identifier $RDS_INSTANCE

aws rds describe-db-instances \
    --db-instance-identifier $RDS_INSTANCE \
    --query 'DBInstances[0].AvailabilityZone'
故障转移后,RDS 会自动在撤离的可用区中重新创建备用实例。对于持续演练而言这是可以接受的,因为备用实例不接收客户端流量。监控 ReplicaLag 以确认复制健康状况。
步骤 4.(可选)从撤离的可用区中移除备用实例。
如果你希望在撤离的可用区中完全没有 RDS 存在,可以通过修改数据库子网组来迁移备用实例:
创建手动快照作为安全网。
在实例上禁用多可用区。
修改数据库子网组,仅包含健康的可用区子网,移除已撤离可用区的子网。
重新启用多可用区,使新的备用实例在剩余的健康可用区之一中创建。
此方法对 Amazon RDS for PostgreSQL 与对任何使用多可用区部署的 RDS 引擎同样适用。请注意,RDS 多可用区修改(禁用/重新启用多可用区、子网组变更)可能需要几分钟才能完成。请在演练窗口内为此做好规划。
Amazon Aurora PostgreSQL — 写入器故障转移与读取器管理
Aurora 比标准 RDS 多可用区提供更多对可用区放置的控制。你可以使用故障转移优先级层级显式选择要提升的读取器,并管理读取器跨可用区的放置。
步骤 1. 识别集群拓扑:
aws rds describe-db-clusters \
    --db-cluster-identifier $CLUSTER_ID \
    --query 'DBClusters[0].DBClusterMembers[].{Instance:DBInstanceIdentifier,IsWriter:IsClusterWriter}'

aws rds describe-db-instances \
    --filters Name=db-cluster-id,Values=$CLUSTER_ID \
    --query 'DBInstances[].[DBInstanceIdentifier,AvailabilityZone,DBInstanceStatus]' \
    --output table
步骤 2. 如果写入器位于撤离的可用区中,故障转移到健康可用区中的读取器:
aws rds failover-db-cluster \
    --db-cluster-identifier $CLUSTER_ID \
    --target-db-instance-identifier $READER_IN_HEALTHY_AZ
步骤 3. 等待集群稳定:
aws rds wait db-cluster-available \
    --db-cluster-identifier $CLUSTER_ID
如果你的 Aurora 集群在健康可用区中没有预先存在的读取器,写入器提升需要创建新实例,这通常需要不到 10 分钟。在单独的可用区中预先配置读取器可减少故障转移时间,通常可缩短至不到 30 秒。
步骤 4.(可选)移除撤离的可用区中的读取器,并在健康可用区中创建一个。
对于需要将数据库完全撤离转移区域的完整 AZ 疏散:
# Delete the reader instance in the evacuated AZ
aws rds delete-db-instance \
    --db-instance-identifier $INSTANCE_IN_EVACUATED_AZ \
    --skip-final-snapshot

# Create a new reader in a healthy AZ
aws rds create-db-instance \
    --db-instance-identifier ${CLUSTER_ID}-reader-${TARGET_AZ} \
    --db-cluster-identifier $CLUSTER_ID \
    --db-instance-class $INSTANCE_CLASS \
    --engine aurora-postgresql \
    --availability-zone $TARGET_AZ
步骤 5. 在整个演练过程中监控复制和性能:
aws cloudwatch get-metric-statistics \
    --namespace AWS/RDS \
    --metric-name AuroraReplicaLag \
    --dimensions Name=DBInstanceIdentifier,Value=$READER_INSTANCE \
    --start-time $TIMESTAMP_5MIN_AGO \
    --end-time $TIMESTAMP \
    --period 60 --statistics Average
使用 CloudWatch 监控演练
多日演练的价值取决于其产生的证据。与短暂的故障转移测试(通过目视确认目标响应)不同,48–72 小时的疏散需要持续、自动化的观察,捕获只有在持续 N-1 AZ 负载下才会显现的容量趋势、复制健康状况和延迟变化。
在开始演练之前,请确认您拥有 CloudWatch 仪表板,其中包含架构每一层的按 AZ 指标细分。在演练期间,这些指标有两个用途:实时运营感知和为利益相关者提供演练后证据。
按层划分的关键指标
以下指标让您在演练期间实时了解架构每一层的可见性。
Application Load Balancer / Network Load Balancer
| 指标 | 维度 | 关注内容 |
| --- | --- | --- |
| HealthyHostCount | 按目标组、按 AZ | 在疏散的 AZ 中应降至 0。在健康 AZ 中保持稳定 |
| UnHealthyHostCount | 按目标组、按 AZ | 疏散 AZ 中的目标可能显示不健康(预期内) |
| RequestCount | 按 AZ | 转移的 AZ 中流量为零。其余 AZ 中分布均匀 |
| TargetResponseTime | 按 AZ | 关注健康 AZ 在集中负载下的延迟增加 |
| HTTPCode_Target_5XX_Count | 按目标组 | 持续增加表明容量压力 |
| 指标 | 维度 | 关注内容 |
| --- | --- | --- |
| CPUUtilization | 按服务 | 持续不应超过 70–80%(表明容量余量) |
| MemoryUtilization | 按服务 | 集中负载下的内存压力 |
| RunningTaskCount | 按服务 | 确认任务仅在健康 AZ 中运行 |
| DesiredTaskCount vs RunningTaskCount | 按服务 | 差距表明放置失败(检查子网/容量) |
Amazon EKS(使用 Container Insights)
| 指标 | 维度 | 关注内容 |
| --- | --- | --- |
| node_cpu_utilization | 按节点,按 AZ 过滤 | 健康 AZ 中的节点吸收转移的负载 |
| pod_cpu_utilization | 按 Pod/命名空间 | N-1 运行下的热点检测 |
| node_status_condition | 按节点 | 疏散 AZ 中的节点应显示 SchedulingDisabled |
| pod_number_of_container_restarts | 按 Pod | 重启循环可能表明资源压力 |
Amazon RDS for PostgreSQL
| 指标 | 维度 | 关注要点 |
| --- | --- | --- |
| CPUUtilization | 每实例 | 故障转移后主实例在更高负载下的表现 |
| DatabaseConnections | 每实例 | 故障转移后的连接激增(注意连接池耗尽) |
| ReadIOPS / WriteIOPS | 每实例 | 主实例跨可用区迁移时 I/O 模式的变化 |
| ReplicaLag | 每备用实例 | 应在故障转移后数秒内趋于稳定 |
| FreeableMemory | 每实例 | 客户端全面重连时的内存压力 |
Amazon Aurora PostgreSQL
| 指标 | 维度 | 关注要点 |
| --- | --- | --- |
| AuroraReplicaLag | 每读取器实例 | 在正常运行期间建立集群基线。持续高于基线表明存储压力。Aurora 副本通常滞后 100 毫秒或更少 |
| CommitLatency | 每写入器 | 提交延迟增加表明写入争用 |
| BufferCacheHitRatio | 每实例 | 降至 99% 以下可能表明工作集无法容纳在内存中 |
| DatabaseConnections | 每实例 | 写入器提升后的客户端重连行为 |
| VolumeBytesUsed | 每集群 | Aurora 存储与可用区无关(应不受影响) |
在演练前、演练中和演练后,将各可用区的 CloudWatch 仪表板导出为快照。将这些快照与 ARC zonal shift 事件历史(可通过 list-zonal-shifts 获取)结合,形成可审计的证据包。
清理
完成演练后,请谨慎恢复服务。顺序很重要,尤其是当 Auto Scaling 已在健康可用区中增加了容量时:
验证被疏散的可用区状态健康:确认目标已注册、Pod 正在运行、数据库实例可用。
首先取消 EKS 集群的 zonal shift(东西向流量恢复)。在内部流量重新平衡时监控错误。
取消负载均衡器的 zonal shift(南北向流量恢复)。随着 DNS 传播,流量会逐步恢复。
如果 Auto Scaling 在其余可用区增加了容量,请在 15 到 30 分钟内逐步缩减。在流量均匀重新分布之前,不要移除容量。
如果跨可用区负载均衡已禁用,请验证 target_group_health.dns_failover.minimum_healthy_targets.count 已配置。这允许 Route 53 仅在某个可用区注册了足够多的健康目标后才将流量路由到该可用区,防止已恢复的可用区在准备好处理流量之前就接收流量。
恢复后监控各可用区指标 30 分钟,确认分布均匀且无错误激增。
ARC Zonal Shift 不会创建产生持续费用的额外 AWS 资源。zonal shift 本身不收取额外费用。
结论
在本文中,您了解了如何使用 ARC Zonal Shift 在 Amazon Elastic Container Service (Amazon ECS)、Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon RDS for PostgreSQL 和 Amazon Aurora 上执行持续可用区疏散演练。通过在 N-1 个可用区上运行 48–72 小时,而非短暂的故障转移测试,您可以获得证据,证明您的多可用区架构能够提供真正的持续韧性。这对于面临监管要求、需要证明恢复能力的金融服务组织尤其有价值。
要开始使用,请参考本文中的先决条件清单和分步操作流程。从非生产环境开始,在低流量窗口期推进到生产环境,并逐步实现 shift 下的持续运行。随着信心增强,启用 zonal autoshift,以便 AWS 在内部遥测检测到故障时自动转移流量。
您还可以使用 AWS Resilience Hub 在演练前后评估应用程序的韧性状况。它会验证您的架构是否满足您定义的恢复时间目标(RTO)和恢复点目标(RPO)指标。
Amazon Application Recovery Controller – Zonal Shift
ARC 中 zonal shift 的最佳实践
将跨可用区负载均衡与 zonal shift 结合使用
AWS Fault Injection Service 针对 zonal autoshift 的新恢复操作
使用 EKS Zonal Shift 和 Istio 从 Amazon EKS 中的可用区故障中实现端到端恢复
Amazon EKS 现已支持 Amazon Application Recovery Controller
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Antoine Boucherie;如有侵权,请联系管理员删除。

