如果你正在将数据集划分为训练数据和测试数据,有一些事项需要牢记。本文讨论了 3 个最佳实践,并演示了如何在 Python 中实现这些特定的注意事项。
假设你有一个庞大的数据集,需要将其划分为训练数据和测试数据。也许你正在为监督式机器学习做这件事,也许你正在使用 Python 来完成。
本文讨论了划分数据集时需要考虑的三个特定事项、处理这些注意事项的方式,以及如何使用 Python 实际实现这些注意事项。
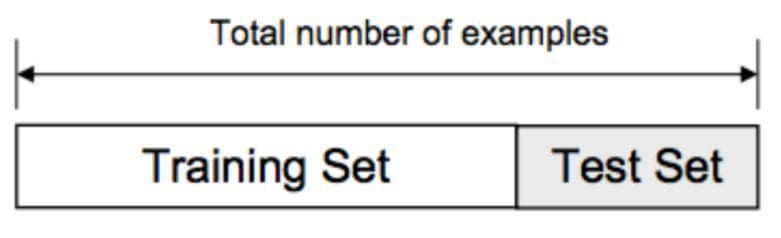
在我们的示例中,我们将使用 Scikit-learn 的 train_test_split 模块,无论你是否使用 Scikit-learn 来执行机器学习任务,它都适用于划分数据集。你可以通过其他方式手动执行这些划分(例如仅使用 Numpy),但 Scikit-learn 模块包含一些有用的功能,使这件事更容易一些。但要注意;也许你过去一直在使用这个模块来执行数据划分,但在这样做时没有考虑到其中的某些注意事项。
1. 随机打乱实例
第一个注意事项是:你的实例被打乱了吗?只要没有理由不打乱我们的数据(例如你的数据是时间序列),我们就希望确保实例不仅仅是按照它们在数据集中出现的顺序进行划分,因为我们的实例可能是以某种方式添加的,这会给我们的模型引入一些不希望的偏差。
例如,看看 Scikit-learn 附带的 iris 数据集在加载时其实例是如何排列的:
from
sklearn.datasets
import
load_iris

iris
=
load_iris()
X, y
=
iris
.
data, iris
.
target
print
(f
"Dataset labels: {iris.target}"
)
Dataset labels: [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2]
如果你将数据集划分为 3 个类别且每个类别的实例数量相等,其中 2/3 用于训练,1/3 用于测试,那么你新划分的数据集将没有任何标签交叉。在尝试学习特征来预测类别标签时,这显然是一个问题。幸运的是,train_test_split 模块默认会自动先打乱数据(你可以通过将 shuffle 参数设置为 False 来覆盖此行为)。
为此,必须将特征向量和目标向量( X 和 y )都传递给该模块。你应该设置 random_state 以确保可复现性。需要设置 train_size 或 test_size 中的一个,但两者都不是必须的。如果你确实同时设置了两者,它们必须加起来等于 1。
from
sklearn.model_selection
import
train_test_split

X_train, X_test, y_train, y_test
=
train_test_split(X, y,
                                                    train_size
=0.67
,
                                                    random_state
=42
)
print
(f
"Train labels:
\n
{y_train}"
)
print
(f
"Test labels:
\n
{y_test}"
)
Train labels: [1 2 1 0 2 1 0 0 0 1 2 0 0 0 1 0 1 2 0 1 2 0 2 2 1 1 2 1 0 1 2 0 0 1 1 0 2 0 0 1 1 2 1 2 2 1 0 0 2 2 0 0 0 1 2 0 2 2 0 1 1 2 1 2 0 2 1 2 1 1 1 0 1 1 0 1 2 2 0 1 2 2 0 2 0 1 2 2 1 2 1 1 2 2 0 1 2 0 1 2] Test labels: [1 0 2 1 1 0 1 2 1 1 2 0 0 0 0 1 2 1 1 2 0 2 0 2 2 2 2 2 0 0 0 0 1 0 0 2 1 0 0 0 2 1 1 0 0 1 2 2 1 2]
你可以看到,现在我们的实例已经被打乱了。
2. 分层抽样
下一个考虑因素是:我们新划分的训练数据集和测试数据集的类别计数是否均匀分布?
import
numpy
as
np
print
(f
"Numbers of train instances by class: {np.bincount(y_train)}"
)
print
(f
"Numbers of test instances by class: {np.bincount(y_test)}"
)
Numbers of train instances by class: [31 35 34] Numbers of test instances by class: [19 15 16]
这不是均匀划分。这涉及到我们的算法是否有平等的机会学习数据集中每个类别的特征,并在随后用相同数量的每个类别实例来测试它所学到的内容。这在较小的数据集中尤其值得关注,但应该始终是一个需要留意的问题。
我们可以通过 train_test_split 的 stratify 选项来强制训练集和测试集之间的类别比例,注意我们将根据 y 中的类别分布进行分层。
X_train, X_test, y_train, y_test
=
train_test_split(X, y,
                                                    train_size
=0.67
,
                                                    random_state
=42
,
                                                    stratify
=
y)
print
(f
"Train labels:
\n
{y_train}"
)
print
(f
"Test labels:
\n
{y_test}"
)
Train labels: [2 0 2 1 0 0 0 2 0 0 1 0 1 1 2 2 0 0 2 0 2 0 0 2 0 1 2 1 0 1 0 2 1 2 1 0 2 0 2 0 1 1 0 2 1 1 0 2 1 2 0 1 0 2 1 1 1 1 1 1 2 1 2 2 0 2 1 1 2 0 2 2 2 0 2 0 0 2 2 2 0 1 2 2 0 1 1 1 1 1 0 2 1 2 0 0 1 0 1 0] Test labels: [2 1 0 1 2 1 1 0 1 1 0 0 0 0 0 2 2 1 2 1 2 1 0 2 0 2 2 0 0 2 2 2 0 1 0 0 2 1 1 1 1 1 0 0 2 1 2 2 1 2]
print
(f
"Numbers of train instances by class: {np.bincount(y_train)}"
)
print
(f
"Numbers of test instances by class: {np.bincount(y_test)}"
)
Numbers of train instances by class: [34 33 33] Numbers of test instances by class: [16 17 17]
现在看起来好多了,原始数字告诉我们这是可能的最优分层划分。
3. 划分的再划分
第三个考虑因素与我们的测试数据有关:我们的建模任务内容是否只有一个由先前未见过的数据组成的测试数据集,还是应该使用两个这样的集合——一个用于在微调期间验证我们的模型(可能涉及多个模型),另一个作为最终留出集用于模型比较和选择。
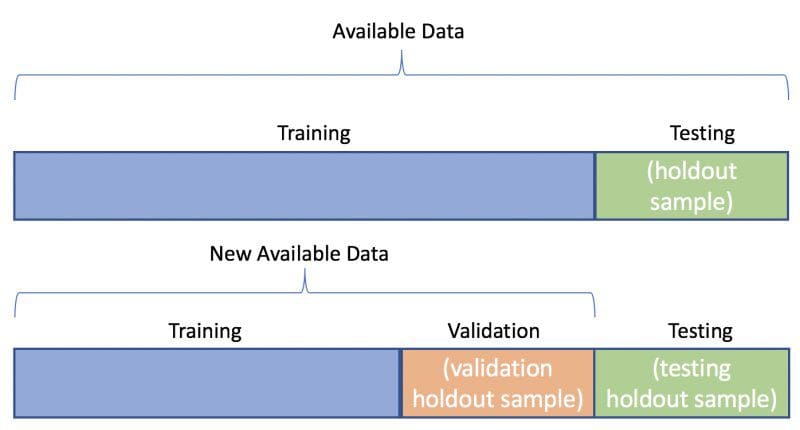
如果我们选择两个这样的集合,这意味着将有一组数据被保留,直到所有假设都被测试、所有超参数都被调优、所有模型都被训练到最佳性能,然后这组数据只在实验的最后一步被模型看到一次。有大量关于测试集与验证集的研究可供参考;我不会在这里进一步深入探讨其推理和论据。
然而,假设你得出结论确实想要使用测试集和验证集(你应该得出这个结论),使用 train_test_split 来构建它们很容易;我们先将整个数据集划分一次,将训练数据与剩余数据分开,然后再将剩余数据划分为测试集和验证集。
下面,使用 digits 数据集,我们将 70% 划分为训练数据集,并暂时将剩余部分分配给测试集。我们继续执行上述最佳实践。
from
sklearn.datasets
import
load_digits

digits
=
load_digits()
X, y
=
digits
.
data, digits
.
target

X_train, X_test, y_train, y_test
=
train_test_split(X, y,
                                                    train_size
=0.7
,
                                                    random_state
=42
,
                                                    stratify
=
y)
print
(f
"Numbers of train instances by class: {np.bincount(y_train)}"
)
print
(f
"Numbers of test instances by class: {np.bincount(y_test)}"
)
Numbers of train instances by class: [124 127 124 128 127 127 127 125 122 126] Numbers of test instances by class: [54 55 53 55 54 55 54 54 52 54]
注意训练集和临时测试集中的分层类别。
然后我们以相同的方式重新划分测试集——这次修改输出变量名、输入变量名,并注意更改 stratify 类别向量引用——使用 50/50 的划分用于测试集和验证集。
X_test, X_val, y_test, y_val
=
train_test_split(X_test, y_test,
                                                    train_size
=0.5
,
                                                    random_state
=42
,
                                                    stratify
=
y_test)
print
(f
"Numbers of test instances by class: {np.bincount(y_test)}"
)
print
(f
"Numbers of validation instances by class: {np.bincount(y_val)}"
)
Numbers of test instances by class: [27 27 27 27 27 28 27 27 26 27] Numbers of validation instances by class: [27 28 26 28 27 27 27 27 26 27]
再次注意所有数据集中的类别分层,这是最优且理想的。
现在,你可以根据自己的数据,训练、验证和测试任意数量的机器学习模型了。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/2020/05/dataset-splitting-best-practices-python.html#comment-184644
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

