精选项目
本文探讨了用于 Table Batched Embedding (TBE) 前向和后向传播的 FBTriton 内核设计。这些核心算子负责在推荐系统中跨数千个分片 GPU(图形处理器) 处理嵌入查找。我们的 Triton 实现在这些工作负载上成功超越了传统的 CUDA(NVIDIA 并行计算平台和编程模型) 内核。在此,我们阐述架构设计、详述实测性能提升,并重点介绍未来的优化机会。
1. 什么是 TBE
TBE(Table-Batched Embedding)内核在一次 GPU 操作中高效地对多张表执行嵌入查找和池化。TBE 在单次 GPU 启动中为多张表结合了嵌入查找和池化,减少了启动开销并提高了内存效率。您可以在此处阅读更多一般信息
2. Triton TBE 前向传播的实现
对于每张表和每个 bag,前向传播收集索引行,可选地将其乘以每样本权重,在 FP32(FP32 权重时为 FP64)中累加,并写出一个 D 宽的池化输出。我们构建了两种实现:通用收集实现和带有小表直方图的快速路径实现。
通用收集路径
- Grid。通用启动使用 ceil(B / BAGS_PER_PROGRAM) 个程序。每个程序循环遍历 T 个特征,而不是启动 B×T 的 grid。
- 收集宽度。内层循环发出四个独立的行加载。调优后的双 bag 路径发出八个
- 每程序 bag 数。大型非 VBE、非 FP32 工作负载使用每程序两个 bag。当直方图特征被拆分出来时,剩余的通用特征范围使用四个。其他形状使用一个
- 索引和偏移宽度。当线性化范围适合低于 2^31 时,TorchRec 接受配置驱动的 int32 索引和偏移。这将索引/偏移存储和 CUB 基数排序键宽度减半,同时保持 int64 为默认值
- 累加。FP16/BF16 权重在 FP32 中累加。FP32 权重在 FP64 中累加,以在大 D 下保持精度
小表直方图和张量核心路径
专用路径被选择用于满足以下条件的一个特征:E≤64、64≤D≤128、L≥64、FP16 权重、FP32 输出、无每样本权重且无 VBE。一个程序处理 16 个 bag。它对前 256 个索引构建直方图,并使用 tl.dot 计算 counts × table;标量路径处理剩余索引。其他形状使用通用内核。
边界检查
独立路径在 Triton 前向传播之前使用更新的 CUDA 验证步骤。在 B200 上,这在各工作负载的边界检查组件上实现了高达 1.24 倍的加速。当启用 fused_bounds_check 时,符合条件的内核会验证并修复无效的输入张量。偏移验证和修复仍是一个单独的小内核。其他配置,例如加权、可变批处理、AMD 和转置提升情况,则回退到标准验证。该选项通过 TorchRec 暴露,默认关闭。
前向状态复用与预处理
精确的逐行 Adagrad 可以保存前向直方图。反向传播使用这些计数进行补偿 FP16 高/低 GEMM 到 FP32 的计算,然后应用优化器。前向和反向传播保持独立启动;仅复用直方图计数。
另一个可选的核心模块路径将索引转置、排序和游程编码移入前向传播,并通过 autograd 返回元数据。该路径默认关闭,当前 TorchRec 封装未暴露此功能。在大型 B200 配置上,前向传播从 22.844 ms 降至 33.252 ms,反向传播从 56.693 ms 降至 32.931 ms,总延迟从 79.537 ms 降至 66.183 ms(−16.8%)。

3. Triton TBE 反向传播内核的实现
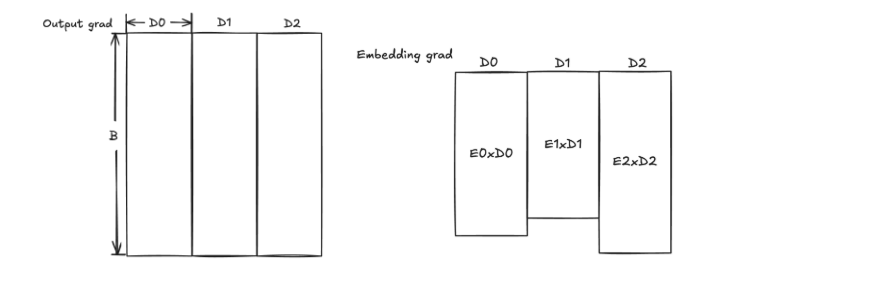
TBE 反向传播的核心逻辑:对于批次中触及的每个唯一 (table, row) 对,对该批次中触及它的每个批次位置的上游梯度行求和,然后对该行应用恰好一次优化器更新。
注释:T 是表数量;E 是嵌入大小(即行数);D 是嵌入维度(即列数);L 是池化因子(即嵌入包大小);B 是批次大小(即每个请求的嵌入包数量)
前向传播。嵌入表 T 是位于 GPU 中的二维张量 (ExD)。
- 给定:稀疏特征(id 列表或 id-score 列表),例如 [id1, id2, id3, id4](此处 L=4 且 B=1)或多个稀疏特征(B>1)。
- 目标:通过计算 T[id1%E]+T[id2%E]+T[id3%E]+T[id4%E] 的和,我们得到其前向输出。如果 B=100,我们将有 100 个前向输出。
- 给定:前向输出和输出梯度(output.backward(grads))
- 目标:计算 weights.grad 并更新权重。计算梯度:对于每个索引“id”,计算包含“id”的所有嵌入包中输出梯度的总和。(当 TxB=4.2M,B=128K 时,索引统计量可以是 total/dedup/highest_freq = 83M/3M/125K)更新权重:简单如 weight = weight – grad * LR
- TBE 反向传播没有张量核心操作,但需要大量数据移动/归约,并面临负载不均衡问题。
transpose_embedding_input 将批次反转成游程:一个唯一行与触及它的样本配对。此操作被提升到前向传播中,脱离反向传播关键路径。
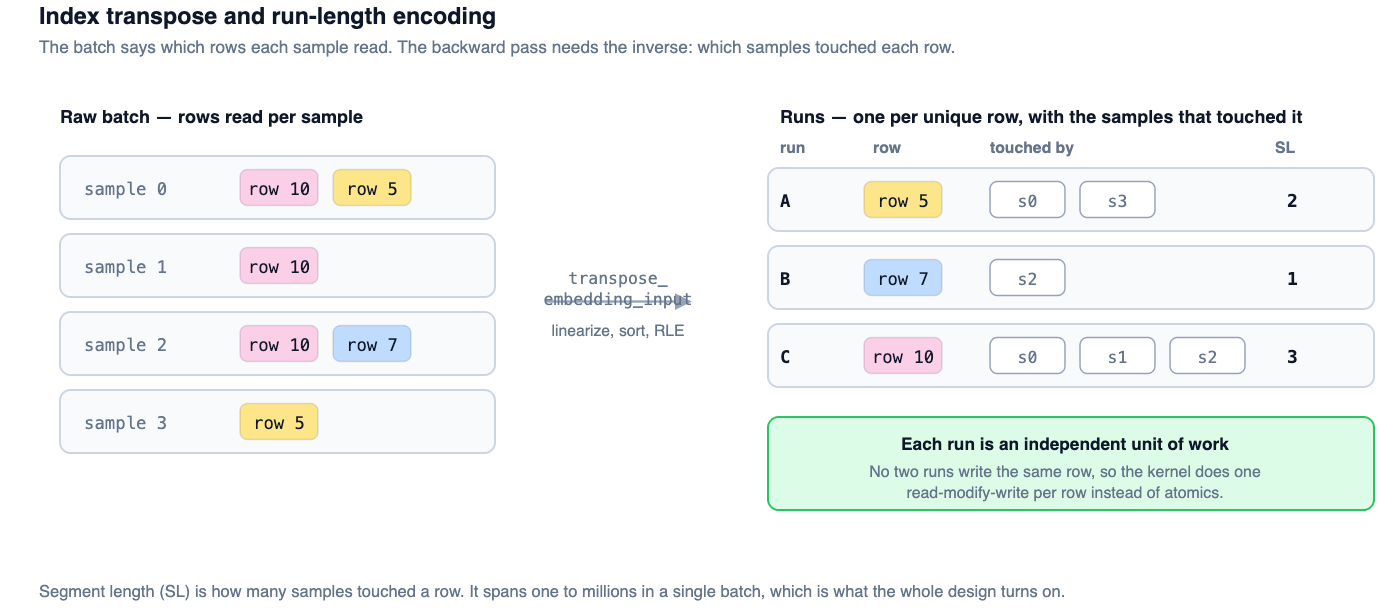
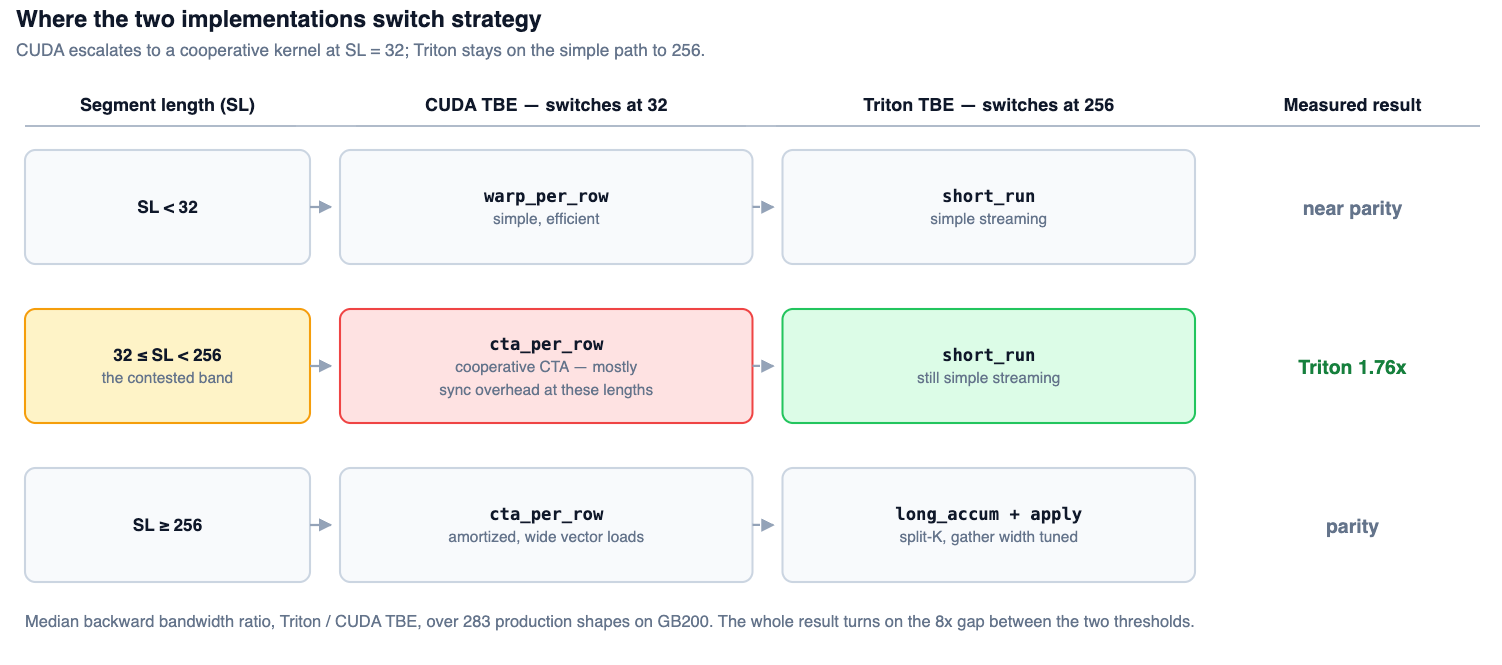
段长度(SL),即触及某一行的样本数量,是所有操作依赖的变量,在单个批次内范围从一到数百万。游程根据 SL 路由到三个内核之一。
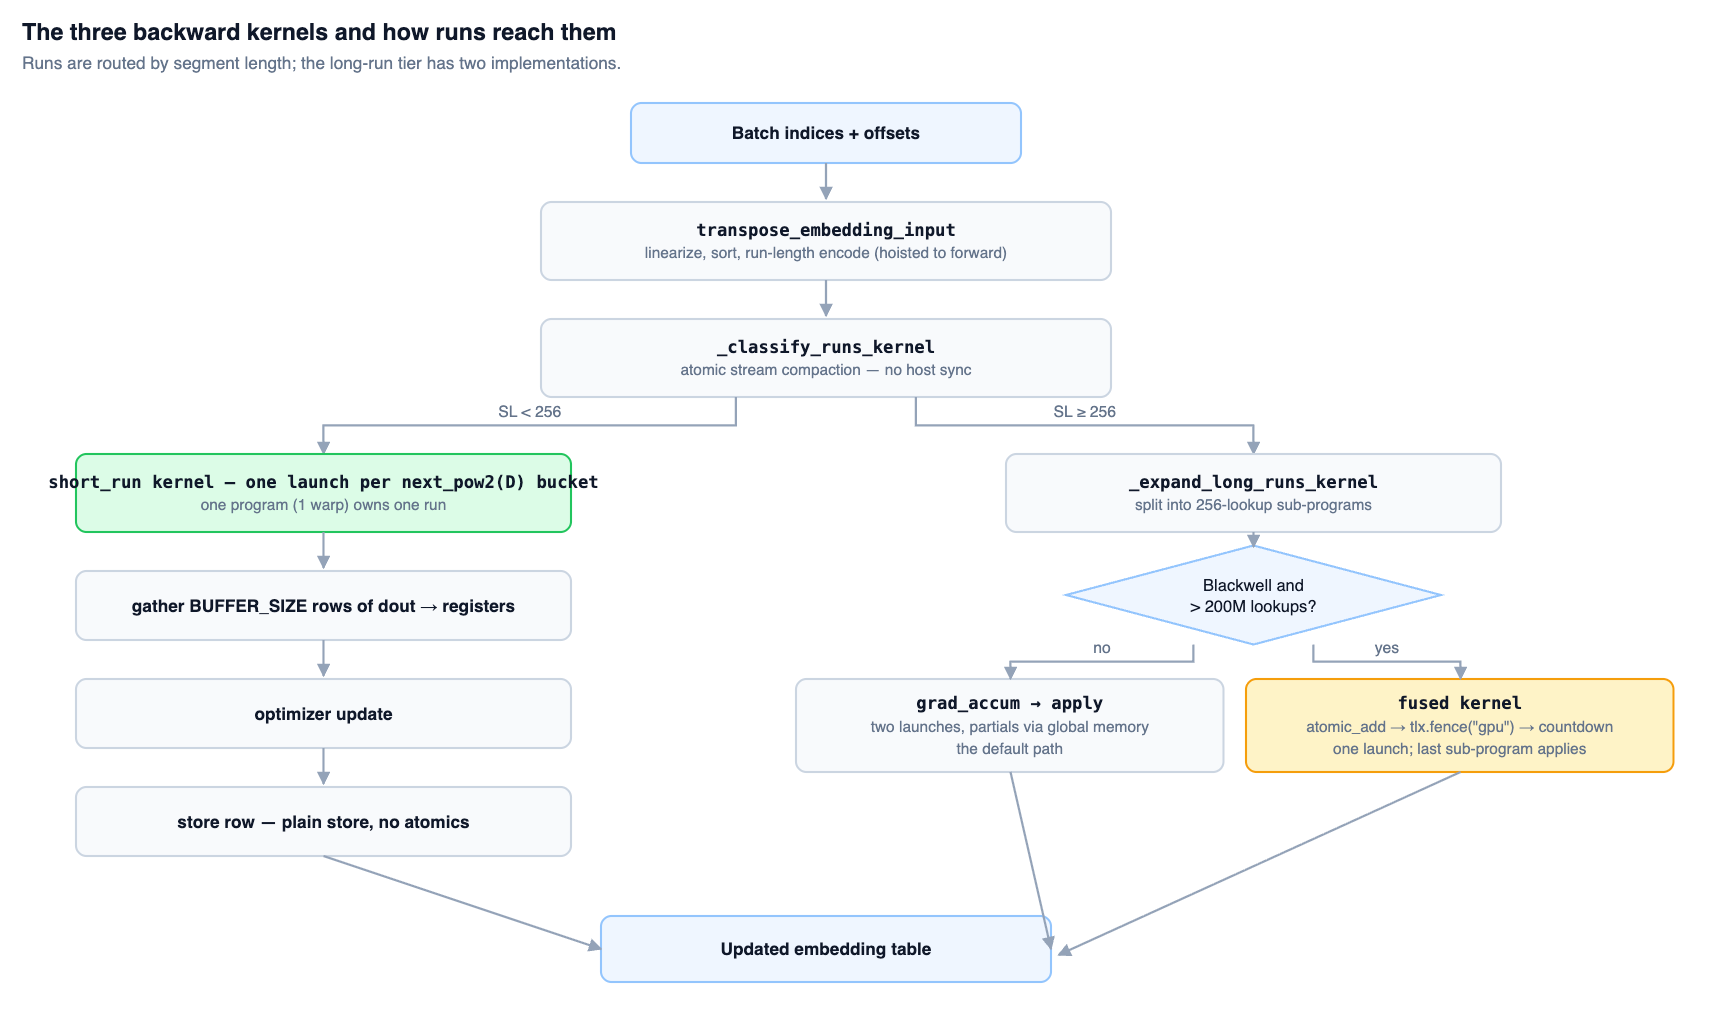
- short_run ( SL < 256 ):一个程序从头到尾拥有整个游程:收集、在寄存器中累加、优化器、存储。独占所有权意味着普通存储,无需原子操作。
- grad_accum + apply ( SL >= 256 ,默认):游程被分割成 256 次查找的块,部分结果落入工作区,第二个内核应用优化器。
- fused ( SL >= 256 ,Blackwell,非常大的批次):相同的分割,但设备作用域栅栏允许最后一个子程序在一次启动中应用更新。
加权表的不同之处仅在于,在累加之前,每个梯度行会按其对应的每样本权重进行缩放。
## 4. 边界情况与性能改进
### 问题 1. 不均衡的程序
单个程序执行两百万次查找会让 GPU 处于空闲状态,而大量仅执行一次查找的运行却要为几乎不产生工作量的任务支付完整的每次运行开销。
解决方案 1.1:拆分长运行。达到或超过阈值的运行会被拆分为固定的 256 次查找块,采用 split-K 风格。一次两百万次查找的运行会变成大约八千个子程序,足以用单行的任务填满整台机器。
解决方案 1.2:CLC(TLX Blackwell)。内核在最初启动后会持续存在,并在完成当前 ‘run_id’ 后继续窃取“空闲”的 ‘run_id’。如果内核成功窃取到一个工作负载,它会在同一个块中处理该工作负载。否则,内核退出。为了解决负载不均衡问题,我们不再需要像按频率拆分 run_id 处理这样的基于软件的解决方案。相反,CLC 提供了一种基于硬件的解决方案。
### 问题 2. gather 宽度是寄存器悬崖
每个缓冲行都会保持 BLOCK_SIZE 个 64 位地址处于活跃状态,因为 dout_row_start_ptr[:, None] + col_offsets[None, :] 会物化出一个完整的指针 tile。成本为 width × BLOCK_SIZE,因此针对某一行宽度调优得到的 width 在另一行宽度下并不适用。
解决方案:在每个层级中按目标配置 width。在 B200 上测得:
| 层级 | width | 寄存器 | 占用率 | 效果 |
| --- | --- | --- | --- | --- |
| 短运行,未加权 | 8 → 2 | 184 → 64 | 12.5% → 49.9% | 0.41 → 1.05 |
| 长运行,累加 | 8 → 2 | 158 → 62 | 17.6% → 44.7% | 集群持平 82% → 87% |
| 短运行,加权 | 4 → 2 | 125 → 64 | 24.8% → 49.3% | 加权持平 51% → 69% |
### 问题 3. BLOCK_SIZE 是 constexpr
一次启动必须根据所有表中的 next_pow2(max_D) 来确定 BLOCK_SIZE,因此当以查找为主的表比最宽的表窄得多时,每个 gather 行的大部分都是被掩码屏蔽的 lane。
为了解决这个问题,我们按维度进行分桶。短运行在分类期间按 next_pow2(D) 路由到每个桶,每个桶以自己的 BLOCK_SIZE 启动。它融入分类内核,因此不产生额外遍历;性能分析确认它减少的是 lane 浪费,而非占用率。
哪些运行是长运行取决于数据,且仅在 GPU 上已知,而用 .item() 读回这些计数意味着每次反向传播都会执行一次 cudaStreamSynchronize。
解决方案:将形状保留在 GPU 上。工作区预分配为根据索引计数计算出的上界,分类在内核中运行,使用原子计数器进行流压缩:
is_long        = (run_len >= threshold) & mask
num_long_block = tl.sum(is_long.to(tl.int32))
long_base      = tl.atomic_add(num_long_ptr, num_long_block)
long_local     = tl.cumsum(is_long.to(tl.int32), axis=0) - 1
tl.store(long_run_ids_ptr + (long_base + long_local).to(tl.int64),
         offsets.to(tl.int32), mask=is_long)
每个块一次原子操作,而非每个元素一次,块内偏移来自前缀和。内核随后将计数作为设备指针使用,并通过 while 循环自行分配。
问题 5. 拆分运行需要跨程序屏障
一旦运行被拆分,优化器更新只能在每个子程序的 partial 落地后运行。Triton 没有设备作用域栅栏,因此这需要第二个内核和一次全局内存往返。
解决方案:栅栏,然后倒计数(TLX Blackwell)。TLX 暴露了栅栏,让最后一个子程序在同一次启动中应用更新:
tl.atomic_add(temp_grad_buffer_ptr + temp_grad_offset + col_offsets, grad, mask=mask)
tlx.fence("gpu")
remaining = tl.atomic_add(grad_accum_counter_ptr + grad_buffer_id, -1)
if remaining == 1:
    ...  # last sub-program applies the optimizer and stores
顺序就是正确性论证:栅栏使每个 partial 在倒计数递减之前设备范围内可见,因此看到 remaining == 1 的程序读取到的是完整的和。没有它,一个程序可能在另一个程序的 atomic_add 仍在进行时赢得倒计数,导致静默的数值错误。
问题 6. 合并 partial 是行级原子操作
每个子程序原子地将整个 BLOCK_SIZE 行添加到运行的 workspace 槽中。一个运行被拆分为八千个块意味着八千个程序在同一行上竞争,而 tl.atomic_add 一次一个元素地发出该合并操作。
解决方案:通过 TMA 进行归约(TLX Blackwell)。Blackwell 有一条比 tl.atomic_add 更适合合并 partial 的指令 cp.reduce.async.bulk.tensor,暴露为 tlx.async_descriptor_store(..., store_reduce="add")。
5. 结果与分析
结果
在 GB200 上的 307 个分片配置(283 种不同形状),精确的逐行 Adagrad,FP16 权重。指标:Triton 性能除以 CUDA TBE。前向加速中位数为 1.28×。
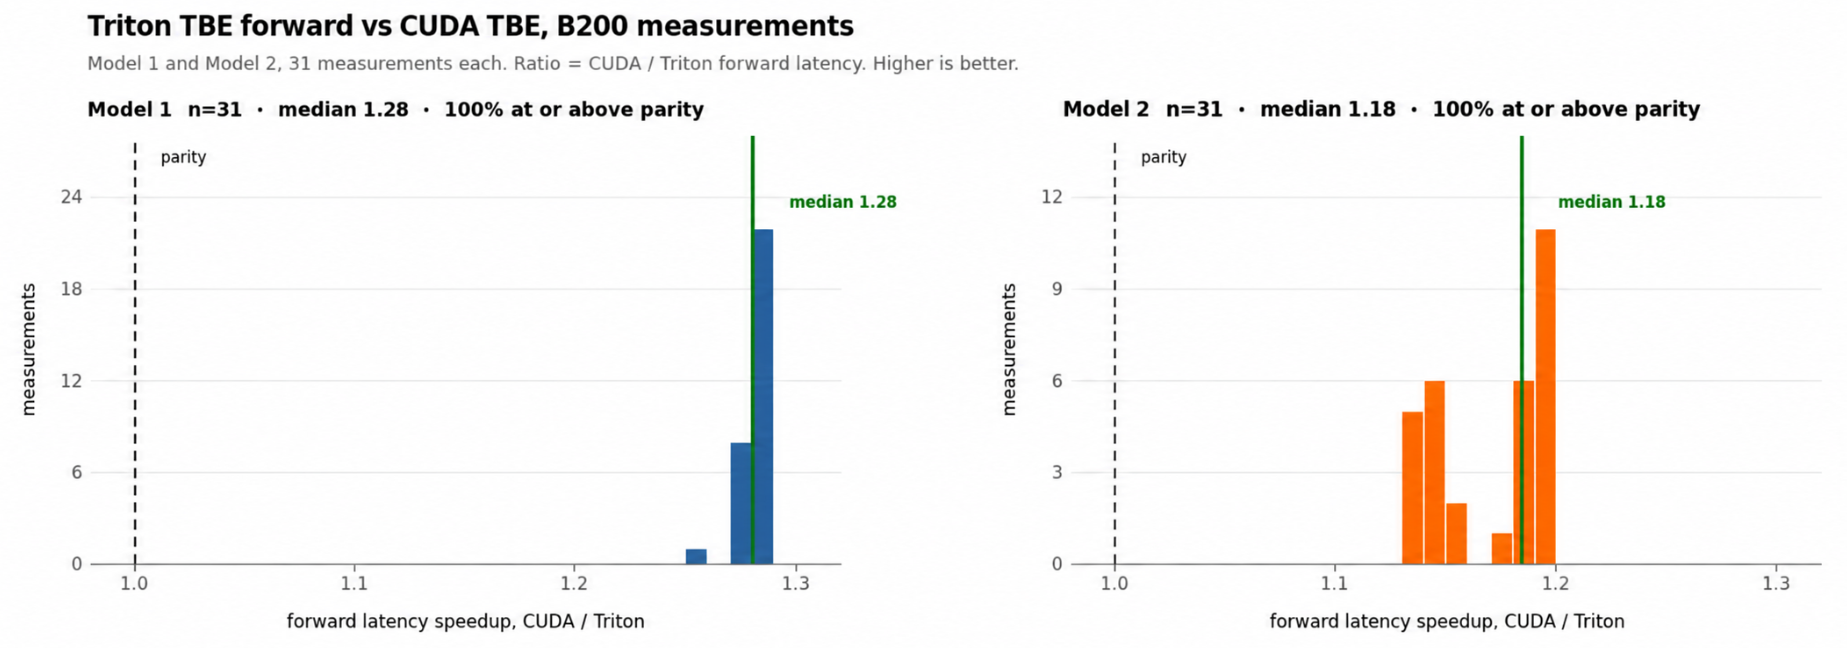
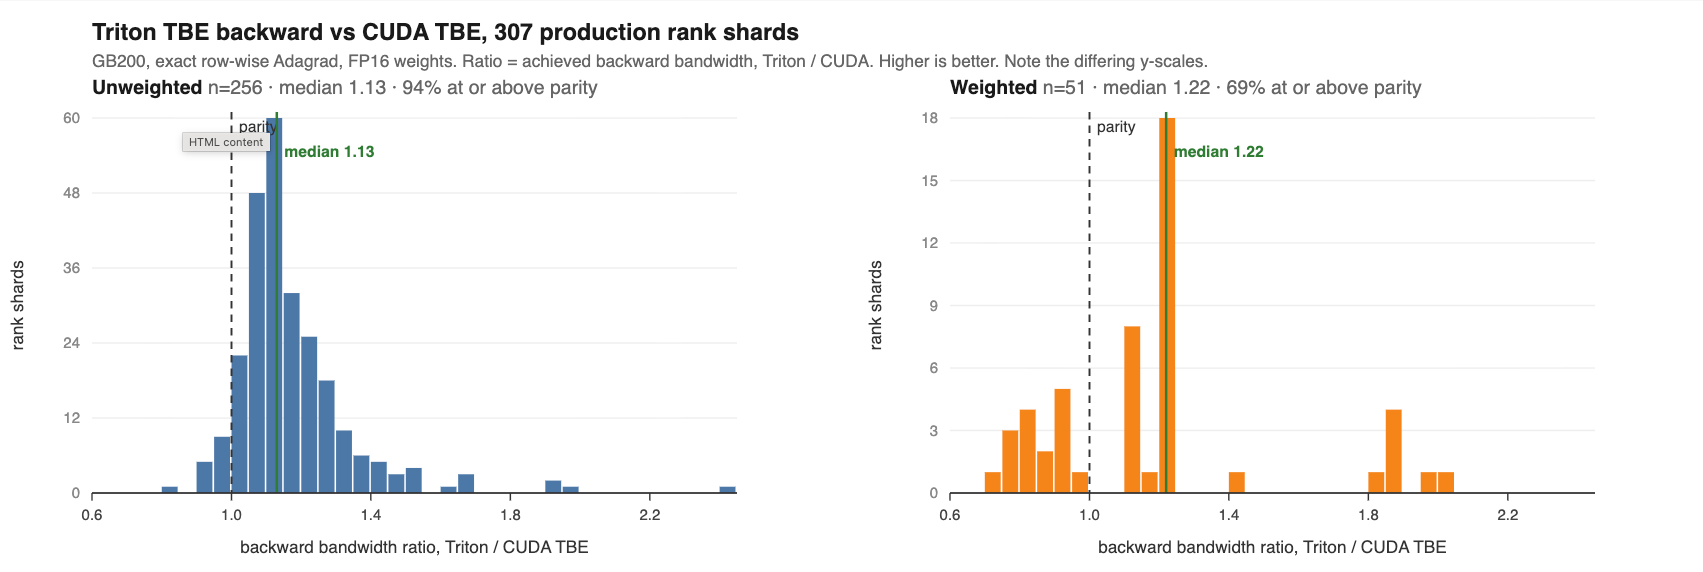
分析:为什么 Triton 在这里胜过 CUDA?
我们的大部分优势来自于改变运行长度。CUDA 在 SL = 32 时升级为每行一个协作 CTA(Cooperative Thread Array)的内核;Triton 则保持简单流式处理直到 SL = 256。
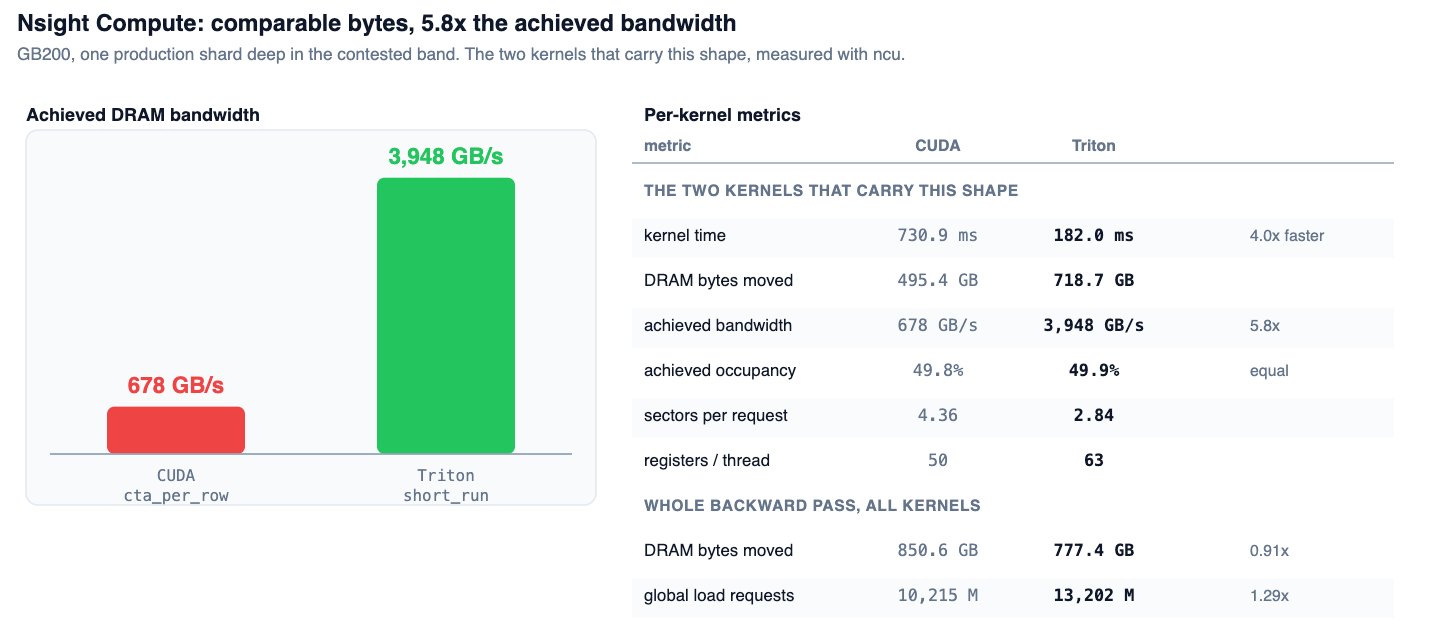
加速来自于更好的内存吞吐量。在该区间深处,Triton 运行速度快 4.3 倍,同时在整个过程中移动相同的 DRAM 字节数(0.91x)并发出多 29% 的加载请求。Nsight Compute 显示了差异所在:承载此形状的 CUDA 内核达到 678 GB/s,而 Triton 内核在相同占用率下达到 3,948 GB/s(5.8x)。刚好高于 SL = 32 时,没有任何东西可以摊销 CTA 范围的同步开销,而 Triton 的路径完全没有协作。
这些优势来自配置值。第 2 节中的每个修复都作为配置更改暴露出来。在模板生成的 CUDA 中移动升级点或收集宽度意味着重构哪个内核处理什么。
Triton 仍然落后的地方。工作完全在短于 4 的运行中的形状低于持平水平,因为纯粹的依赖加载延迟;CUDA 的每行一个 warp 更好地摊销了每次运行的元数据。这是 307 个分片中的 11 个,每个不到约一毫秒。高于 SL = 256 的形状处于持平而非领先。如果它们在工作负载上成为瓶颈,我们将投入更多。
6. 超越性能:FBTriton 解锁了什么
FBTriton 最持久的成果是整个稀疏路径(前向和后向)现在都用普通 Python 编写,并且比原始 CUDA 模板本身还小。因此,我们可以在未来应用更多可能的融合,如前向所示,并解锁这些好处:
- 快速开发者速度:FBTriton 同时提供高机器效率和开发者效率。与 CUDA Jinja 模板相比,Triton TBE 使 rank/infra 工程师更容易快速实现 SOTA 嵌入算法以获得更好的模型性能。
- 同时具备可移植性和敏捷性:FBTriton 在 Blackwell、Hopper 或 AMD 架构上运行时保持相同的内核主体。无需为不同硬件创建单独的代码分支,特定功能(如 CLC、TMA 批量原子归约或设备范围栅栏)作为附加标志集成。
- 通往“超级稀疏内核”的路径:在 Triton 中重写 CUDA 内核解锁了大量 [前向, 后向] 和 [序言, 尾声] 融合机会。通过将优化器视为后向尾声,FBTriton 消除了额外的内存传递。这种融合将整个稀疏序列折叠为一个内核,将 FP8 动量缩放等复杂功能减少到几行累加。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PyTorch Blog
原创地址:https://pytorch.org/blog/modernizing-table-batched-embeddings-with-fbtriton/
原文作者:bsterling;如有侵权,请联系管理员删除。

