现代 AI 加速器每秒可以执行数量惊人的浮点运算。但单一的 FLOPs 数值很少能完整呈现性能全貌。在本系列的前两篇博客中,我们讨论了 AMD Instinct™ GPU 的 Peak FLOPs 和 Max-Achievable FLOPs(MAF)。Peak FLOPs 描述硬件的理论计算能力。MAF 则更进一步,通过测试一系列 GEMM 尺寸来测量 GPU 能够达到的最高持续吞吐量。本篇博客介绍第三个指标:Typical Attained FLOPs(TAF)。TAF 衡量的是在测试前选定的固定代表性 GEMM 集合上,以 FLOP 加权的持续吞吐量。其目标并非取代 Peak FLOPs 或 MAF。每个指标回答不同的问题,三者结合可以更完整地呈现 GPU 计算性能。
要点 #
了解 TAF 与 Peak FLOPs 和 MAF 之间的关系。
了解固定的代表性 GEMM 集合如何提供可重复的持续计算吞吐量度量。
查看单块 AMD Instinct™ MI325X GPU 的 FP16、BF16 和非缩放 FP8 TAF 结果。
三个指标,三个不同的问题 #
Peak FLOPs、MAF 和 TAF 各有不同的用途:
| 指标 | 它回答的问题 |
| --- | --- |
| Peak FLOPs | GPU 的理论计算上限是多少? |
| MAF | 在所测试的 GEMM 尺寸范围内,GPU 能够达到的最高持续吞吐量是多少? |
| TAF | 在各种 GEMM 尺寸上,GEMM 性能的合理目标是多少? |
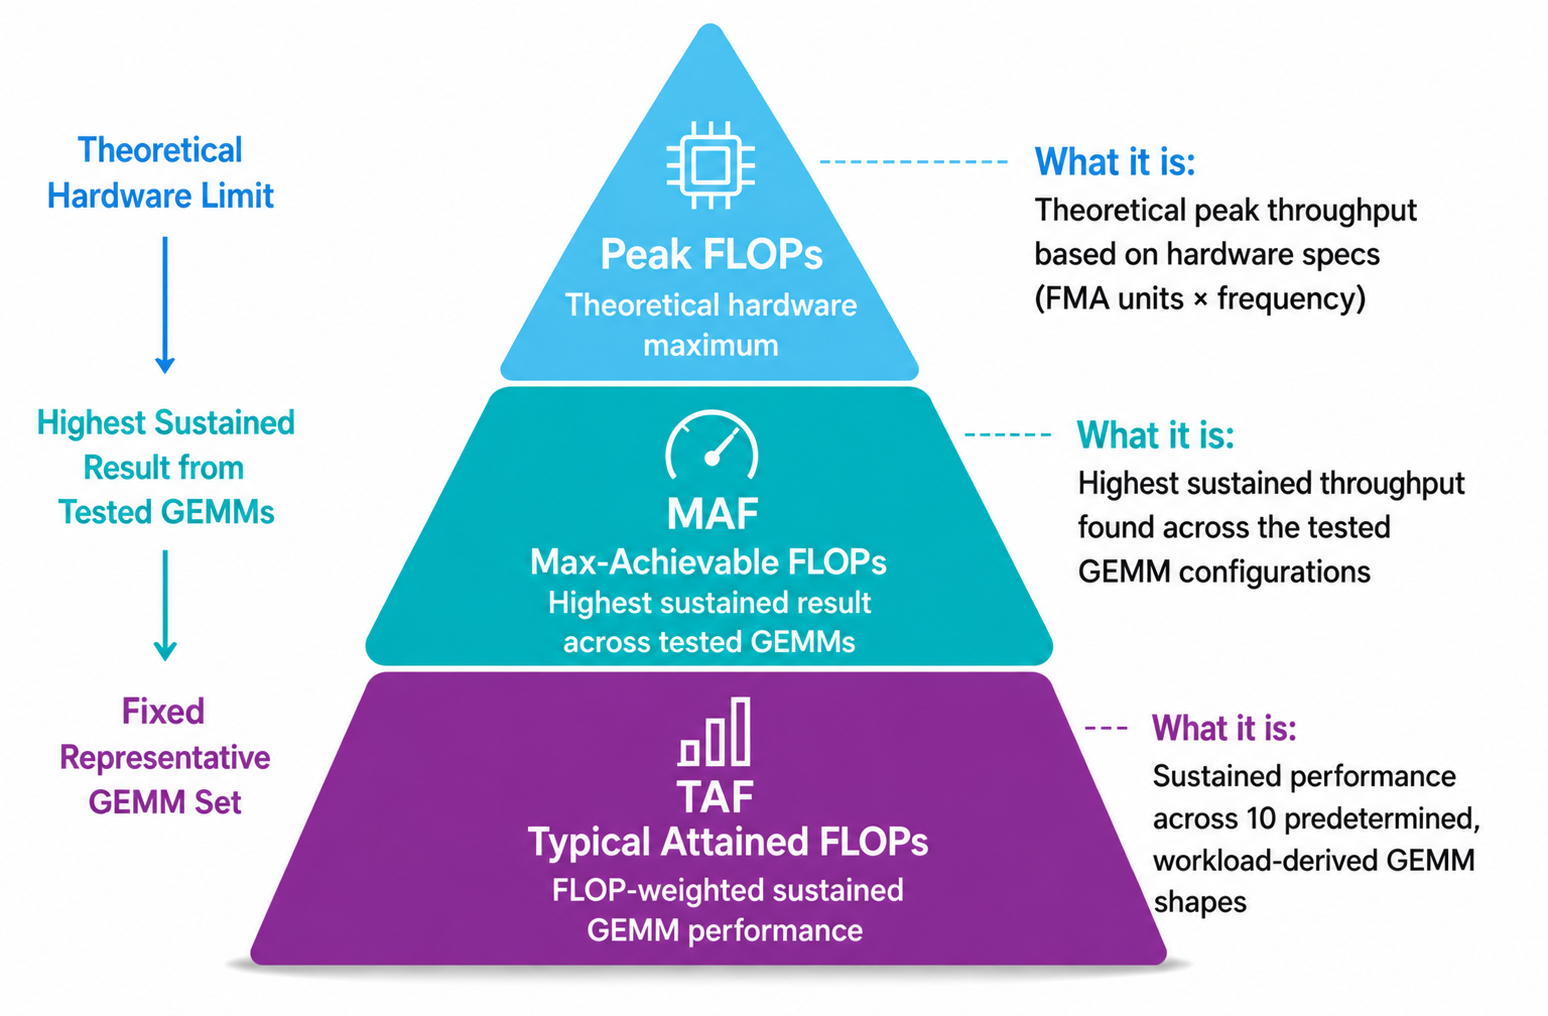
Peak FLOPs 根据 GPU 架构计算得出,包括计算单元数量、每周期执行的操作数以及最大时钟频率。它们提供了一个重要的上限,但并不能预测持续的应用性能。MAF 衡量的是持续性能而非理论最大值。测试多个 GEMM 尺寸,并报告性能最高的结果。这表示 GPU 经过优化后的持续计算上限。然而,产生最高 MAF 结果的 GEMM 形状可能特别适合该 GPU,未必能反映给定应用所使用的形状。TAF 采用不同的测量方式。在测试之前,从实际工作负载——在本例中为 DeepSeek V3——中直接提取一组具有代表性的 GEMM 形状并固定下来。集合中的每个形状都通过 FLOP 加权调和平均数对最终结果做出贡献。这减少了最佳情况下的形状选择偏差,并为使用相同工作负载衍生 GEMM 集合比较 GPU 提供了一致的基础。如下图所示,Peak FLOPs、MAF 和 TAF 各自回答不同的性能问题,三者结合可以更完整地呈现 GPU 的持续计算性能。
引入 Typical Attained FLOPs #
在之前的博客中,我们讨论了 Peak FLOPs 和 MAF。TAF 在标准化测试条件下,测量预定的 GEMM 工作负载上的持续浮点吞吐量。与 MAF 报告所测试 GEMM 配置中找到的最高结果不同,TAF 在计算中纳入全部 10 个预定的代表性形状。因此,所报告的值代表整个 GEMM 集合上以 FLOP 加权的持续性能,而非某个特别有利形状的性能。
TAF(Typical Attained FLOPs)提供的是持续 GEMM 计算性能的标准化度量,而非端到端应用性能的直接度量。TAF 是推理中 GEMM 部分的一个有用的计算侧指标,在影响端到端推理性能的其他因素之外,提供了可达到的 GEMM 吞吐量的现实度量。现代推理工作负载,特别是大语言模型的解码和 token 生成阶段,可能受限于内存带宽、KV 缓存访问、通信开销、延迟和顺序 token 依赖,而非原始计算吞吐量。因此,当流水线的另一部分是瓶颈时,TAF 的差异可能只会带来端到端吞吐量或延迟方面较小的改善。TAF 刻画的是标准化条件下持续的 GEMM 计算性能,而整体应用性能取决于计算、内存、通信和软件栈的综合效率。
TAF 方法论 #
本博客中的 AMD Instinct™ MI325X GPU 结果使用了一组固定的 10 个代表性 GEMM 形状,这些形状源自 DeepSeek V3。五个预定的 \((N,K)\) 对分别在两个 \(M\) 值下进行评估,即 \(M = 32\) 和 \(M = 32,768\),从而产生以下 10 个 \((M,N,K)\) 形状:
| 形状 | M | N | K |
| --- | --- | --- | --- |
| 1 | 32 | 2,112 | 7,168 |
| 2 | 32 | 3,072 | 1,536 |
| 3 | 32 | 7,168 | 2,048 |
| 4 | 32 | 4,608 | 7,168 |
| 5 | 32 | 7,168 | 256 |
| 6 | 32,768 | 2,112 | 7,168 |
| 7 | 32,768 | 3,072 | 1,536 |
| 8 | 32,768 | 7,168 | 2,048 |
| 9 | 32,768 | 4,608 | 7,168 |
| 10 | 32,768 | 7,168 | 256 |
每个形状使用 mblas-bench 运行 30 秒,以获得其测得的持续性能 \(P_i\)。该测试针对每种报告的数据格式分别执行,从而为 FP16、BF16 和非缩放 FP8 生成各自的 TAF 结果。
对于每个 GEMM \(i\),浮点运算次数为
其等效执行时间计算如下:
最终的 TAF 结果使用 FLOP 加权的调和平均数将所有 10 个形状合并:
30 秒的测量周期用于为每个形状建立稳定的持续性能值;它们不会在 TAF 计算中相加。由于计算按数学工作量加权,FLOPs 更多的 GEMM 对最终结果的贡献成比例地更大。在此方法论下评估的每个 GPU 都使用相同的预定 10 形状集,为比较提供了一致的基础。
受控初始化与测试条件 #
矩阵大小并不是影响 GEMM 性能的唯一因素。输入矩阵中的值也很重要。不同的数据模式会改变开关活动、功耗和持续 GPU 频率,从而影响测得的吞吐量。
为保持一致,当前的 MAF 和 TAF 测试使用正态分布初始化输入矩阵。值直接以每种目标数据格式生成。对于非缩放 FP8,缩放因子设置为 1。
早期发布的 MAF 结果使用了 trig_float 初始化。这种结构化输入模式在某些数据格式下可能导致更低的开关活动和功耗,使 GPU 能够维持比使用更具代表性的输入数据时更高的频率。当前测试使用正态分布初始化,以更好地反映 AI 工作负载中通常出现的值范围。
由于初始化方法不同,这些结果无法与当前的 MAF 和 TAF 结果直接比较。当前结果使用相同的正态分布初始化,因此更容易看出两个指标之间的差异:MAF 和 TAF。
使用相同的初始化、测试时长、系统配置和运行条件可使结果具有可重复性。然而,MAF 和 TAF 仍然是 GPU 级别的测量值,不能直接预测端到端应用性能。
AMD Instinct MI325X GPU 的 TAF 结果 #
TAF 是在标准化条件下评估持续 GEMM 计算性能的重要指标。表 1 报告了在一个 AMD Instinct™ MI325X GPU 上,针对所测试的 FP16、BF16 和非缩放 FP8 数据格式所测得的吞吐量。
结果显示了 AMD Instinct™ MI325X GPU 在规定的代表性 GEMM 集合和运行条件下,针对每种测试精度所达到的持续 GEMM 吞吐量。它们提供了除 Peak FLOPs 和 MAF 之外的另一种视角,用于了解 GPU 实际交付的计算性能。这些测量值不应被解读为竞争排名,也不应被解读为对端到端训练或推理性能的直接预测。
一个 AMD Instinct™ MI325X GPU 的典型达成 FLOPs(TAF)结果:
| 产品 | TAF FP16 | TAF BF16 | TAF FP8(非缩放) |
| --- | --- | --- | --- |
| AMD Instinct™ MI325X | 606 TFLOPs | 616 TFLOPs | 1,143 TFLOPs |
表 1:一个 AMD Instinct™ MI325X GPU 的典型达成 FLOPs(TAF)。
如何解读 TAF #
TAF 是衡量和比较 GPU 在源自真实工作负载的 GEMM 形状上持续性能的有用代理指标。TAF 是对 MAF 的补充,而不是替代。MAF 显示 GPU 在所测试的 GEMM 配置中能够达到的最高持续吞吐量,而 TAF 显示在固定代表性 GEMM 集合上的持续性能。这两项测量都很有用,因为它们回答了不同的问题。
TAF 的目的不是产生另一个更接近 Peak FLOPs 的数字。Peak FLOPs 定义了理论计算上限,MAF 衡量优化后的持续计算上限,而 TAF 衡量在完整代表性 GEMM 集合上的持续吞吐量。
TAF 仍然是一个计算指标,而不是端到端应用基准。它不能直接预测训练时间、推理延迟或每秒 token 数。要衡量完整硬件和软件系统的性能,仍然需要应用级基准测试。
在 AMD Instinct MI325X GPU 上比较三项指标 [ 1 ] #
| 数据格式 | 峰值 FLOPs | MAF | TAF | TAF 占 MAF 的百分比 |
| --- | --- | --- | --- | --- |
| FP16 | 1,300 TFLOPs | 787 TFLOPs | 606 TFLOPs | 77% |
| BF16 | 1,300 TFLOPs | 831 TFLOPs | 616 TFLOPs | 74% |
| FP8 | 2,610 TFLOPs | 1,409 TFLOPs | 1,143 TFLOPs | 81% |
峰值 FLOPs 数值为 AMD Instinct MI325X 规格说明中公布的稠密、非稀疏数值。
这些数值差异表明这三项指标回答了不同的问题。峰值 FLOPs 代表 MI325X GPU 在理想利用率和最大指定运行条件下的理论计算上限。MAF 使用不同矩阵维度 \((M,N,K)\) 运行多个 GEMM 测试。每个测试产生一个吞吐量结果,MAF 仅报告最高结果。TAF 低于 MAF,因为它包含所有 10 个预先确定的、源自工作负载的 GEMM 形状的性能,而不是仅选择性能最高的结果。报告的 MI325X TAF 值约为对应已发布 MAF 值的 74–81%。
较低的 TAF 值并不表示 GPU 性能损失——TAF 是一种测量方法,而非运行模式。相反,这一差异表明,在某个有利的 GEMM 形状上实现的最高持续吞吐量,可能无法代表在更广泛的源自工作负载的形状集合上的相同性能。
峰值到 MAF 展示了理论性能与最大持续性能之间的差异。MAF 到 TAF 展示了性能最佳的 GEMM 形状与在完整代表性 GEMM 集合上的持续性能之间的差异。
总结 #
在本博客中,我们介绍了典型达成 FLOPs(TAF)如何补充峰值 FLOPs 和最大可达成 FLOPs(MAF),解释了该指标背后的方法论,并回顾了 AMD Instinct™ MI325X GPU 的 TAF 结果。峰值 FLOPs、MAF 和 TAF 提供了 GPU 计算性能的不同但互补的视角。峰值 FLOPs 定义了理论上限,MAF 衡量最高优化持续吞吐量,而 TAF 衡量在测试前固定的工作负载上的持续性能。理解这三者有助于读者恰当地解读基准测试结果,并选择最能回答其性能问题的指标。端到端应用基准测试对于评估完整的训练或推理性能仍然是必要的。
免责声明 #
本文所含信息仅供参考,如有变更,恕不另行通知。尽管在编写本文档时已采取一切预防措施,但本文档可能包含技术不准确、遗漏和/或排版错误,AMD 无义务更新或以其他方式更正此信息。Advanced Micro Devices, Inc. 对本文档内容的准确性或完整性不作任何陈述或保证,并且对本文所述 AMD 硬件、软件或其他产品的操作或使用不承担任何形式的责任,包括对不侵权、适销性或特定用途适用性的默示保证。本文档不授予任何知识产权许可,包括默示许可或因禁止反言而产生的许可。适用于 AMD 产品购买或使用的条款和限制在双方签署的协议或 AMD 的标准销售条款和条件中规定。GD-18u。
© 2026 Advanced Micro Devices, Inc. 保留所有权利。AMD、AMD 箭头标识、Instinct 及其组合是 Advanced Micro Devices, Inc. 的商标。本文包含的其他产品名称仅用于识别目的,可能是其各自所有者的商标。某些 AMD 技术可能需要第三方启用或激活。支持的功能可能因操作系统而异。请与系统制造商确认具体功能。没有任何技术或产品可以完全安全。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:AMD ROCm Blog
原创地址:https://rocm.blogs.amd.com/artificial-intelligence/taf-blog/README.html
原文作者:Ben Sander, Travis Schluessler, Anshul Gupta, Evan;如有侵权,请联系管理员删除。

