EBS 的真实故障率 — PlanetScale
PlanetScale 已在全球范围内部署了数百万个 Amazon Elastic Block Store (EBS) 卷。我们每天创建和销毁数万个卷,为客户搭建数据库、进行备份以及端到端测试我们的系统。通过这些经验,我们对 EBS 的故障率和故障机制有着独特的视角,并花费了大量时间研究如何缓解这些问题。
在复杂系统中,故障并非二元结果。云原生系统的构建不存在单点故障路径,但部分故障仍可能导致性能下降、面向用户的可用性丧失以及未定义行为。通常,堆栈中某一环节的轻微故障会在其他环节表现为完全故障。
例如,如果多节点分布式缓存系统中的某个实例耗尽了网络资源,下游应用程序会将错误情况解释为缓存未命中,以避免请求失败。当应用程序像数据缺失一样涌入大量查询来获取数据时,这会使数据库不堪重负。在这种情况下,某一层面的部分故障会导致数据库层的完全故障,从而造成停机。
定义故障
虽然 EBS 的完全故障和数据丢失非常罕见,但“慢”往往和“故障”一样糟糕,而且这种情况发生得频繁得多。
AWS 控制台中“慢”的表现:
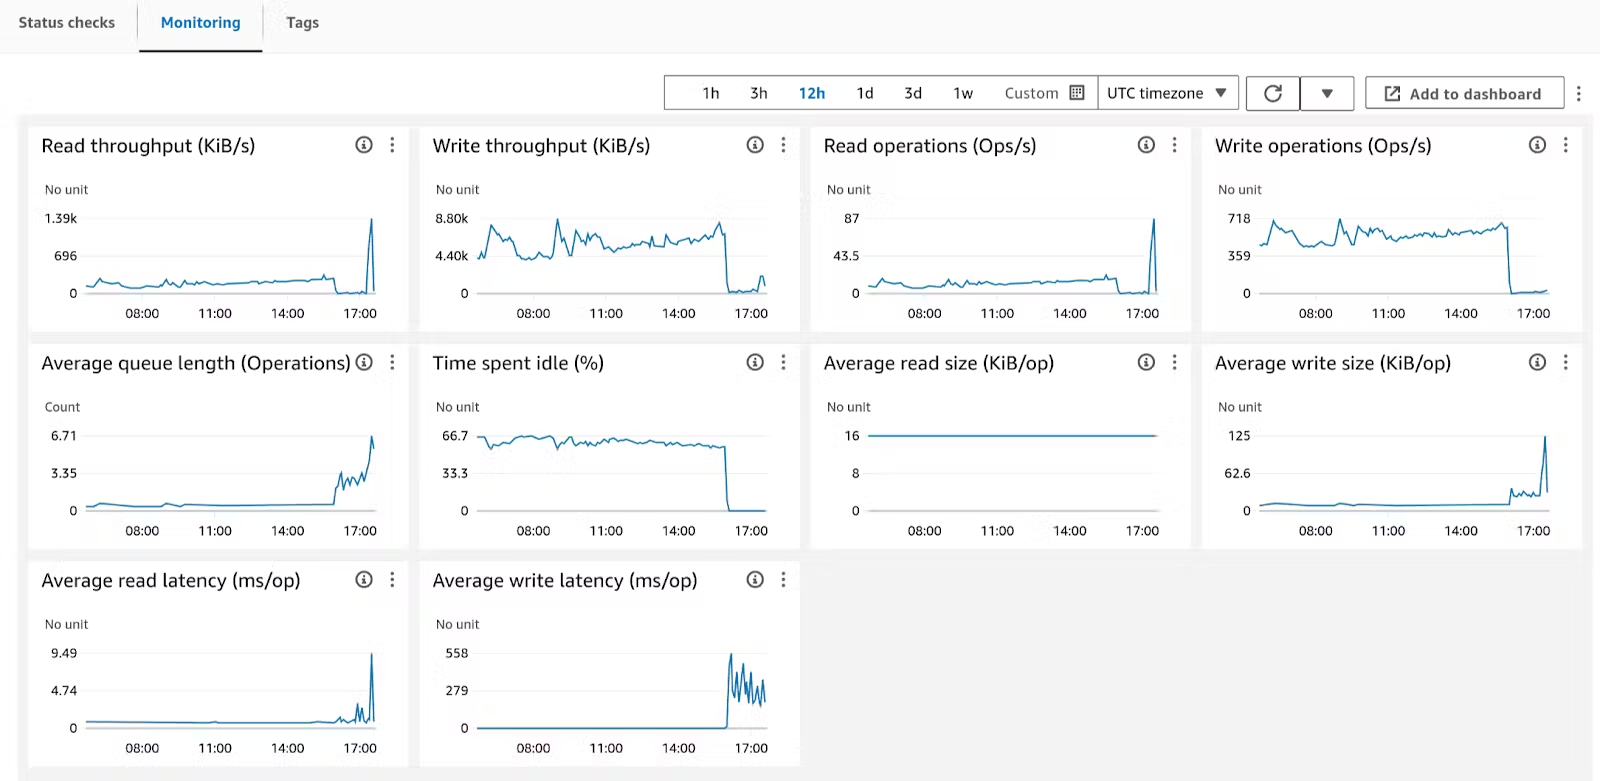
该卷已稳定运行至少 10 小时。AWS 报告其空闲率为 67%,写入延迟为个位数毫秒/操作。完全在预期范围内。突然,在大约 16:00 时,写入延迟飙升至 200ms-500ms/操作,空闲时间骤降至零,该卷实际上被阻止了读写数据。
对于运行在此数据库之上的应用程序来说:这就是故障。对于用户来说:这是等待 10 秒后网页返回的 500 响应。对于你来说:这是一次事故。在 PlanetScale,我们认为这就是完全故障,因为我们的客户也这么认为。
EBS 文档有助于我们理解 AWS gp3 能够做出哪些承诺:
当挂载到 EBS 优化实例时,通用型 SSD(gp2 和 gp3)卷的设计目标是在给定年份中 99% 的时间内至少提供其预置 IOPS 性能的 90%
这意味着一个卷预计有 1% 的时间会经历低于其预置性能 90% 的情况。这相当于每天 14 分钟,或每年 86 小时的潜在影响。这种性能下降率远超单个磁盘驱动器或 SSD。这就是存储与计算分离的代价,以及客户端与卷后端磁盘之间软件和网络组件的巨大复杂性所带来的成本。
根据我们的经验,文档是准确的:有时卷会在很短的时间窗口内进出其预置性能状态:

然而,这些短暂的窗口足以对实时工作负载产生影响:
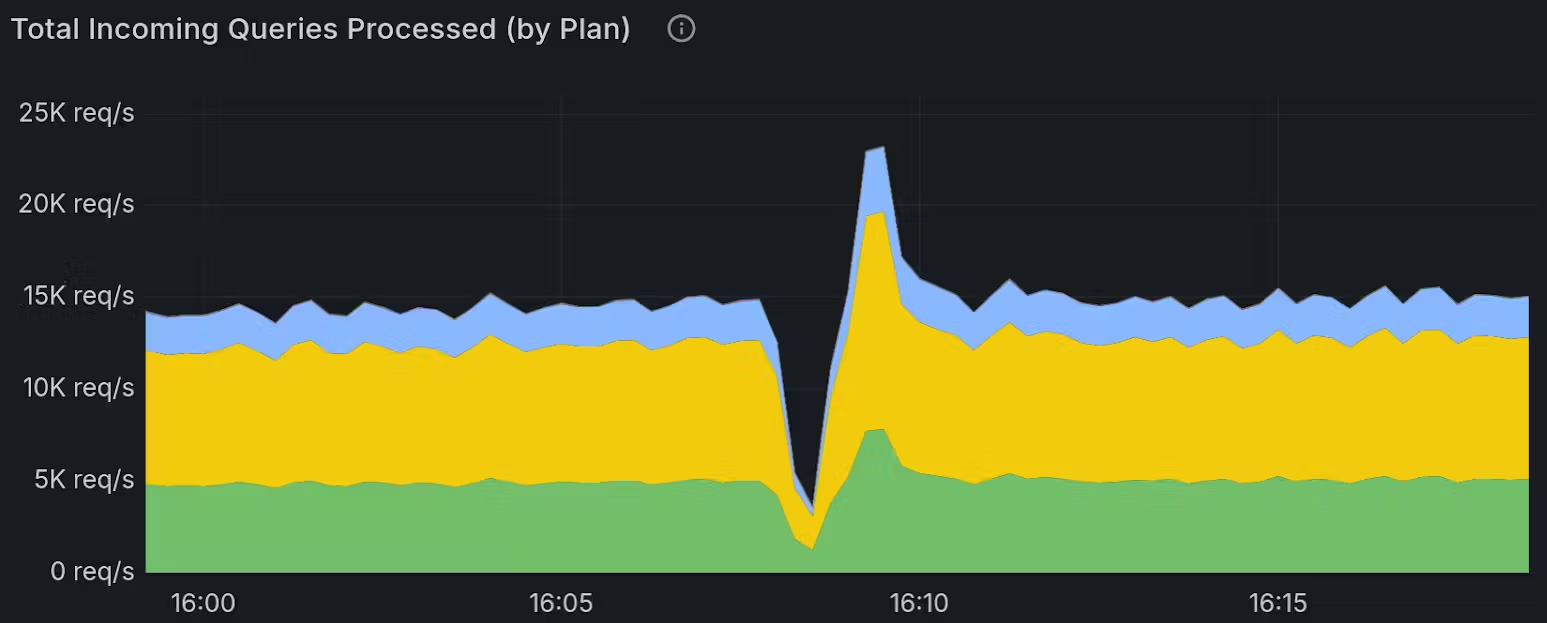
生产系统并非为应对这种程度的突发波动而构建。当没有任何保证时,即使过度配置也无法解决问题。如果这是百万分之一的概率,那情况会有所不同,但正如我们将在下文讨论的,事实远非如此。
真实的故障率
在 PlanetScale,我们每天都会看到这样的故障——故障率足够频繁,以至于我们构建了直接监控 EBS 卷的系统来将影响降到最低。
这不是什么秘密,它就写在文档里。AWS 没有描述 gp3 卷的故障是如何分布的,但根据我们的经验,它往往每次持续 1-10 分钟。这很可能是网络或计算组件进行故障转移所需的时间。
让我们假设以下情况:每次性能下降事件是随机的,意味着性能降低的程度在预置性能的 1% 到 89% 之间,并且你的应用程序设计为在损失 50% 的预期吞吐量之前不会报错。如果每次单独的故障事件持续 10 分钟,每个卷每月将经历约 43 次事件,其中至少有 21 次会导致停机!
在由许多分片组成的大型数据库中,这种故障会叠加。假设一个 256 分片的数据库,每个分片有一个主节点和两个副本:总共预置了 768 个 gp3 EBS 卷。如果我们采用上述 50% 的阈值,那么在任何给定时间,你有 99.65% 的概率至少有一个节点正在经历影响生产的事件。
即使你使用 io2——AWS 以 4 到 10 倍的价格出售——仅那一个数据库,在任何给定年份中,你仍然预计大约有三分之一的时间处于故障状态!
更糟糕的是,我们还经常看到这些故障在单个可用区内呈现相关性,即使使用 io2 卷也是如此:
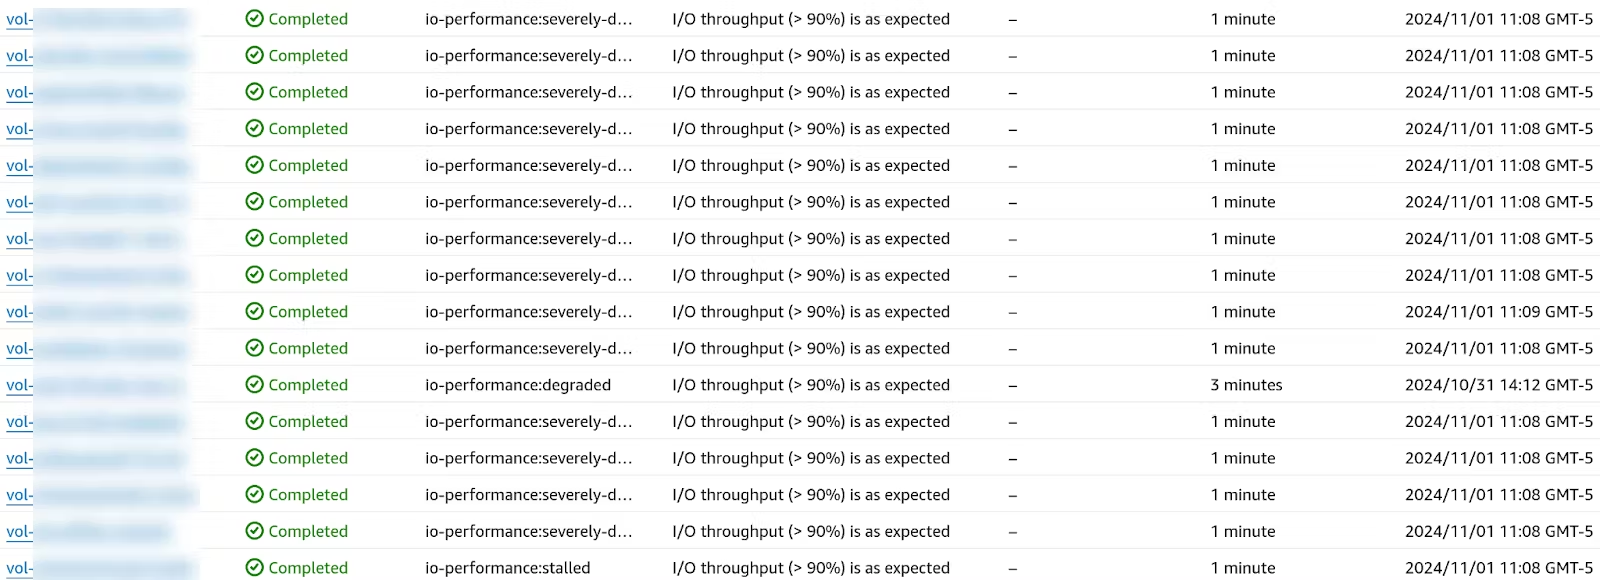
当卷的数量足够多时,经历 EBS 故障的概率就是 100%:我们的自动化缓解措施持续回收性能不佳的 EBS 卷以减少对客户的影响,我们预计每天都会看到多起此类事件。
这就是 EBS 真正的故障率:它是恒定的、可变的,而且完全是设计使然。因为当卷未按其规格运行时,没有任何性能保证,所以对于需要一致性能的工作负载来说,围绕它进行规划极其困难。你可以为额外的“几个九”付费,但在足够长的时间跨度内,只要有足够多的驱动器,故障就是必然的。
处理故障
在 PlanetScale,我们的缓解措施已经将影响窗口的预期最大时间压缩下来。我们密切监控读写延迟和空闲百分比等指标,甚至开发了一些基础测试,比如确保我们能够写入文件。这使我们能够快速响应性能问题,并确保 EBS 卷不会“卡住”。
当我们使用这些启发式方法检测到某个 EBS 卷处于降级状态时,我们可以在几秒钟内执行零停机时间的重新父级化(reparent),将其切换到集群中的另一个节点,并自动启动一个替换卷。这并不能将影响降至零,因为不可能在故障发生前检测到它,但它确实确保了大多数情况不需要人工修复,并且在用户察觉之前就已经结束。
这就是我们构建 PlanetScale Metal 的原因。借助采用本地存储而非 EBS 等网络附加存储的 shared-nothing 架构,数据库中的其余分片和节点能够继续正常运行,不受影响。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

