由于 PlanetScale Metal 现已正式可用,我想分享一篇博文,介绍我们将支撑 Query Insights 功能的 PlanetScale 数据库迁移到 Metal 的经验。
Query Insights 中的数据收集
首先,简要介绍我们如何为 Query Insights 收集数据。基本步骤如下:
从 PlanetScale 数据库的 Vitess 层收集查询模式遥测数据
将数据发布到 Kafka
从 Kafka 消费数据并写入多个 MySQL 表,按时间聚合。
Query Insights 管道中首要的可扩展性关注点是确保我们能够足够快地处理和写入数据到数据库,以跟上入站数据量。为实现这一点,我们批量读取 Kafka 消息,在内存中合并数据以避免不必要的写入,并将写入操作交给每个 Kafka 消费者中的线程池处理。
迁移到 Metal 之前:写入密集型,使用预置 IOPS
结果是 Query Insights 数据库的写入量非常大。截至本文撰写时,我们每秒执行约 10k 条 UPDATE / INSERT 语句。这些写入来自 32 个消费者进程,每个进程有 25 个写入线程,总最大并发为 800 个线程。
Query Insights 的 PlanetScale 数据库有 8 个分片,在升级到 Metal 之前,我们不得不为分片键空间中支撑 MySQL 的 EBS 卷预置更多 IOPS,以跟上遥测数据量。由于此工作负载已表现出对 I/O 延迟的敏感性,我们认为它是升级到 Metal 的良好候选。
迁移到 Metal 后的性能改进
为此,我们从 8 个 MySQL 分片中选择了 1 个最繁忙的分片先行升级。
以下图表展示了不同百分位下的查询延迟。这些线表示 Insights 数据库 8 个主库的延迟。紫色线对应我们最繁忙的分片,该分片在大约 19:35 升级到了 Metal。
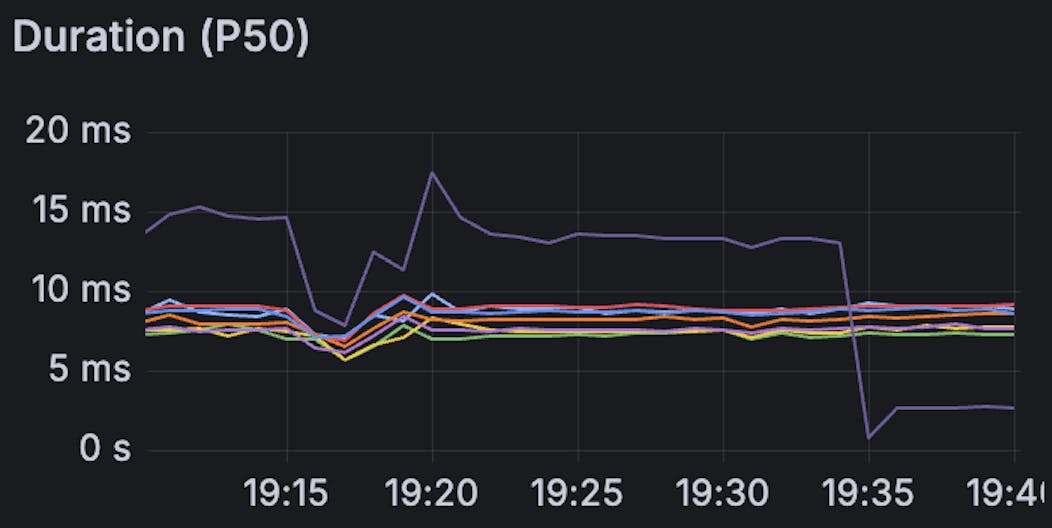
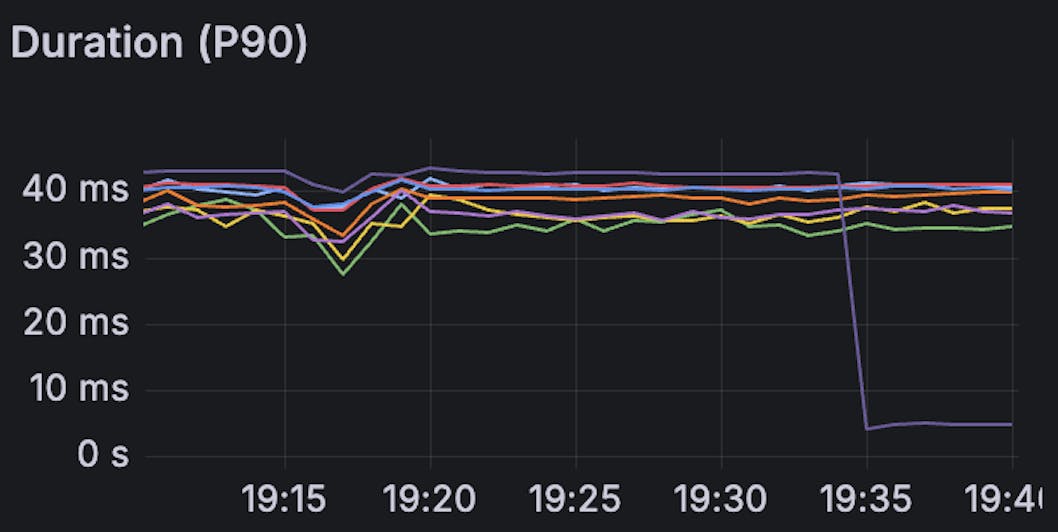
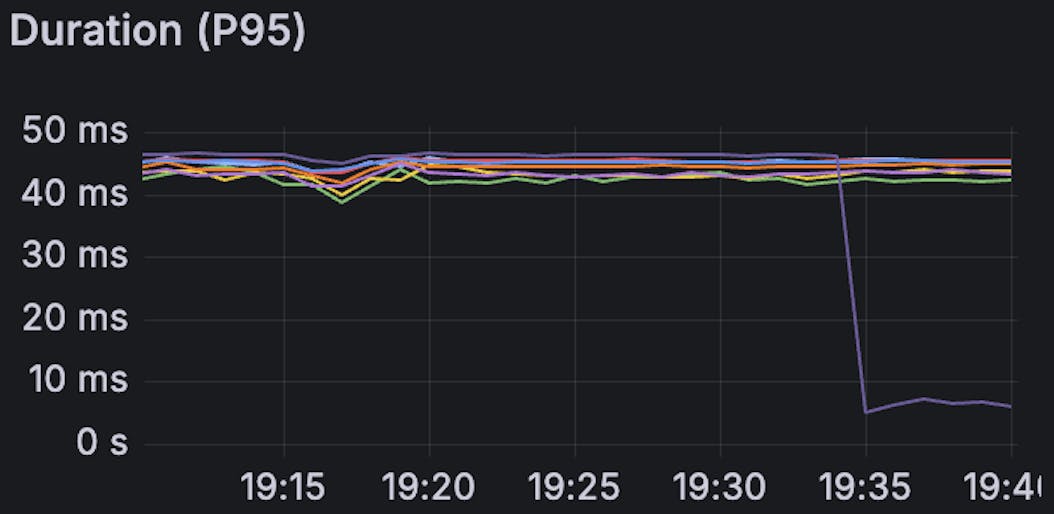
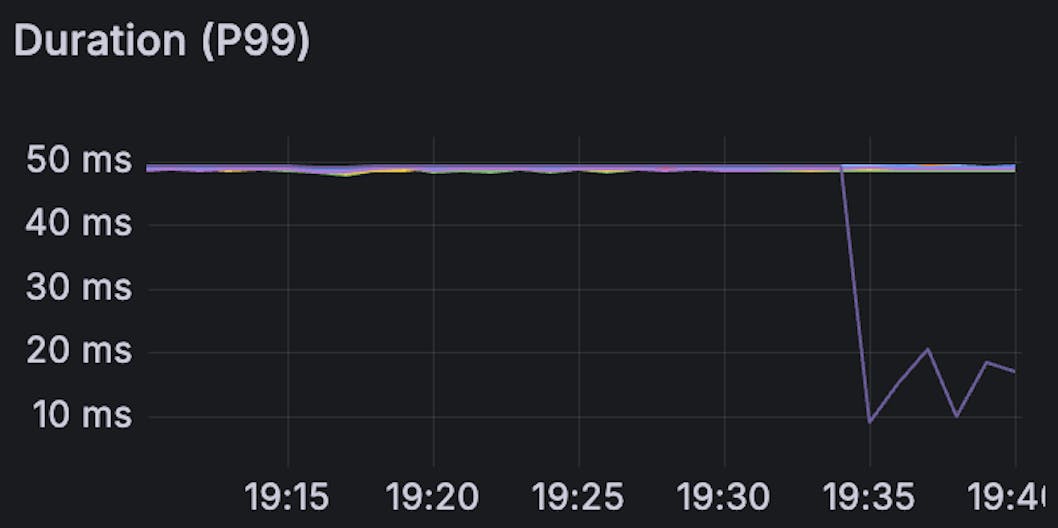
将测试分片升级到 Metal 后,所有测量百分位下的延迟都显著降低。Metal 升级后,我们最繁忙、延迟最高的分片开始执行查询的速度明显快于其他分片。
在让第一次升级观察运行几天后,我们升级了其余分片,并看到性能提升几乎完全相同。
在未对我们的应用程序、架构或分片配置做任何更改的情况下,我们通过升级到 PlanetScale Metal 实现了显著的性能提升。这降低了我们 Kafka 消费者的平均积压,并为我们提供了额外容量,以应对未来不断增长的消息量。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/upgrading-query-insights-to-metal
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

