当你的数据库服务器性能因日常使用而开始下降时,你有多种优化选项可供选择。
优化 MySQL 数据库的一种常见方法是通过分区。在本文中,我们将介绍 MySQL 分区的基础知识、如何对数据库应用分区,并讨论它与分片(sharding)的关系。
MySQL 分区基础
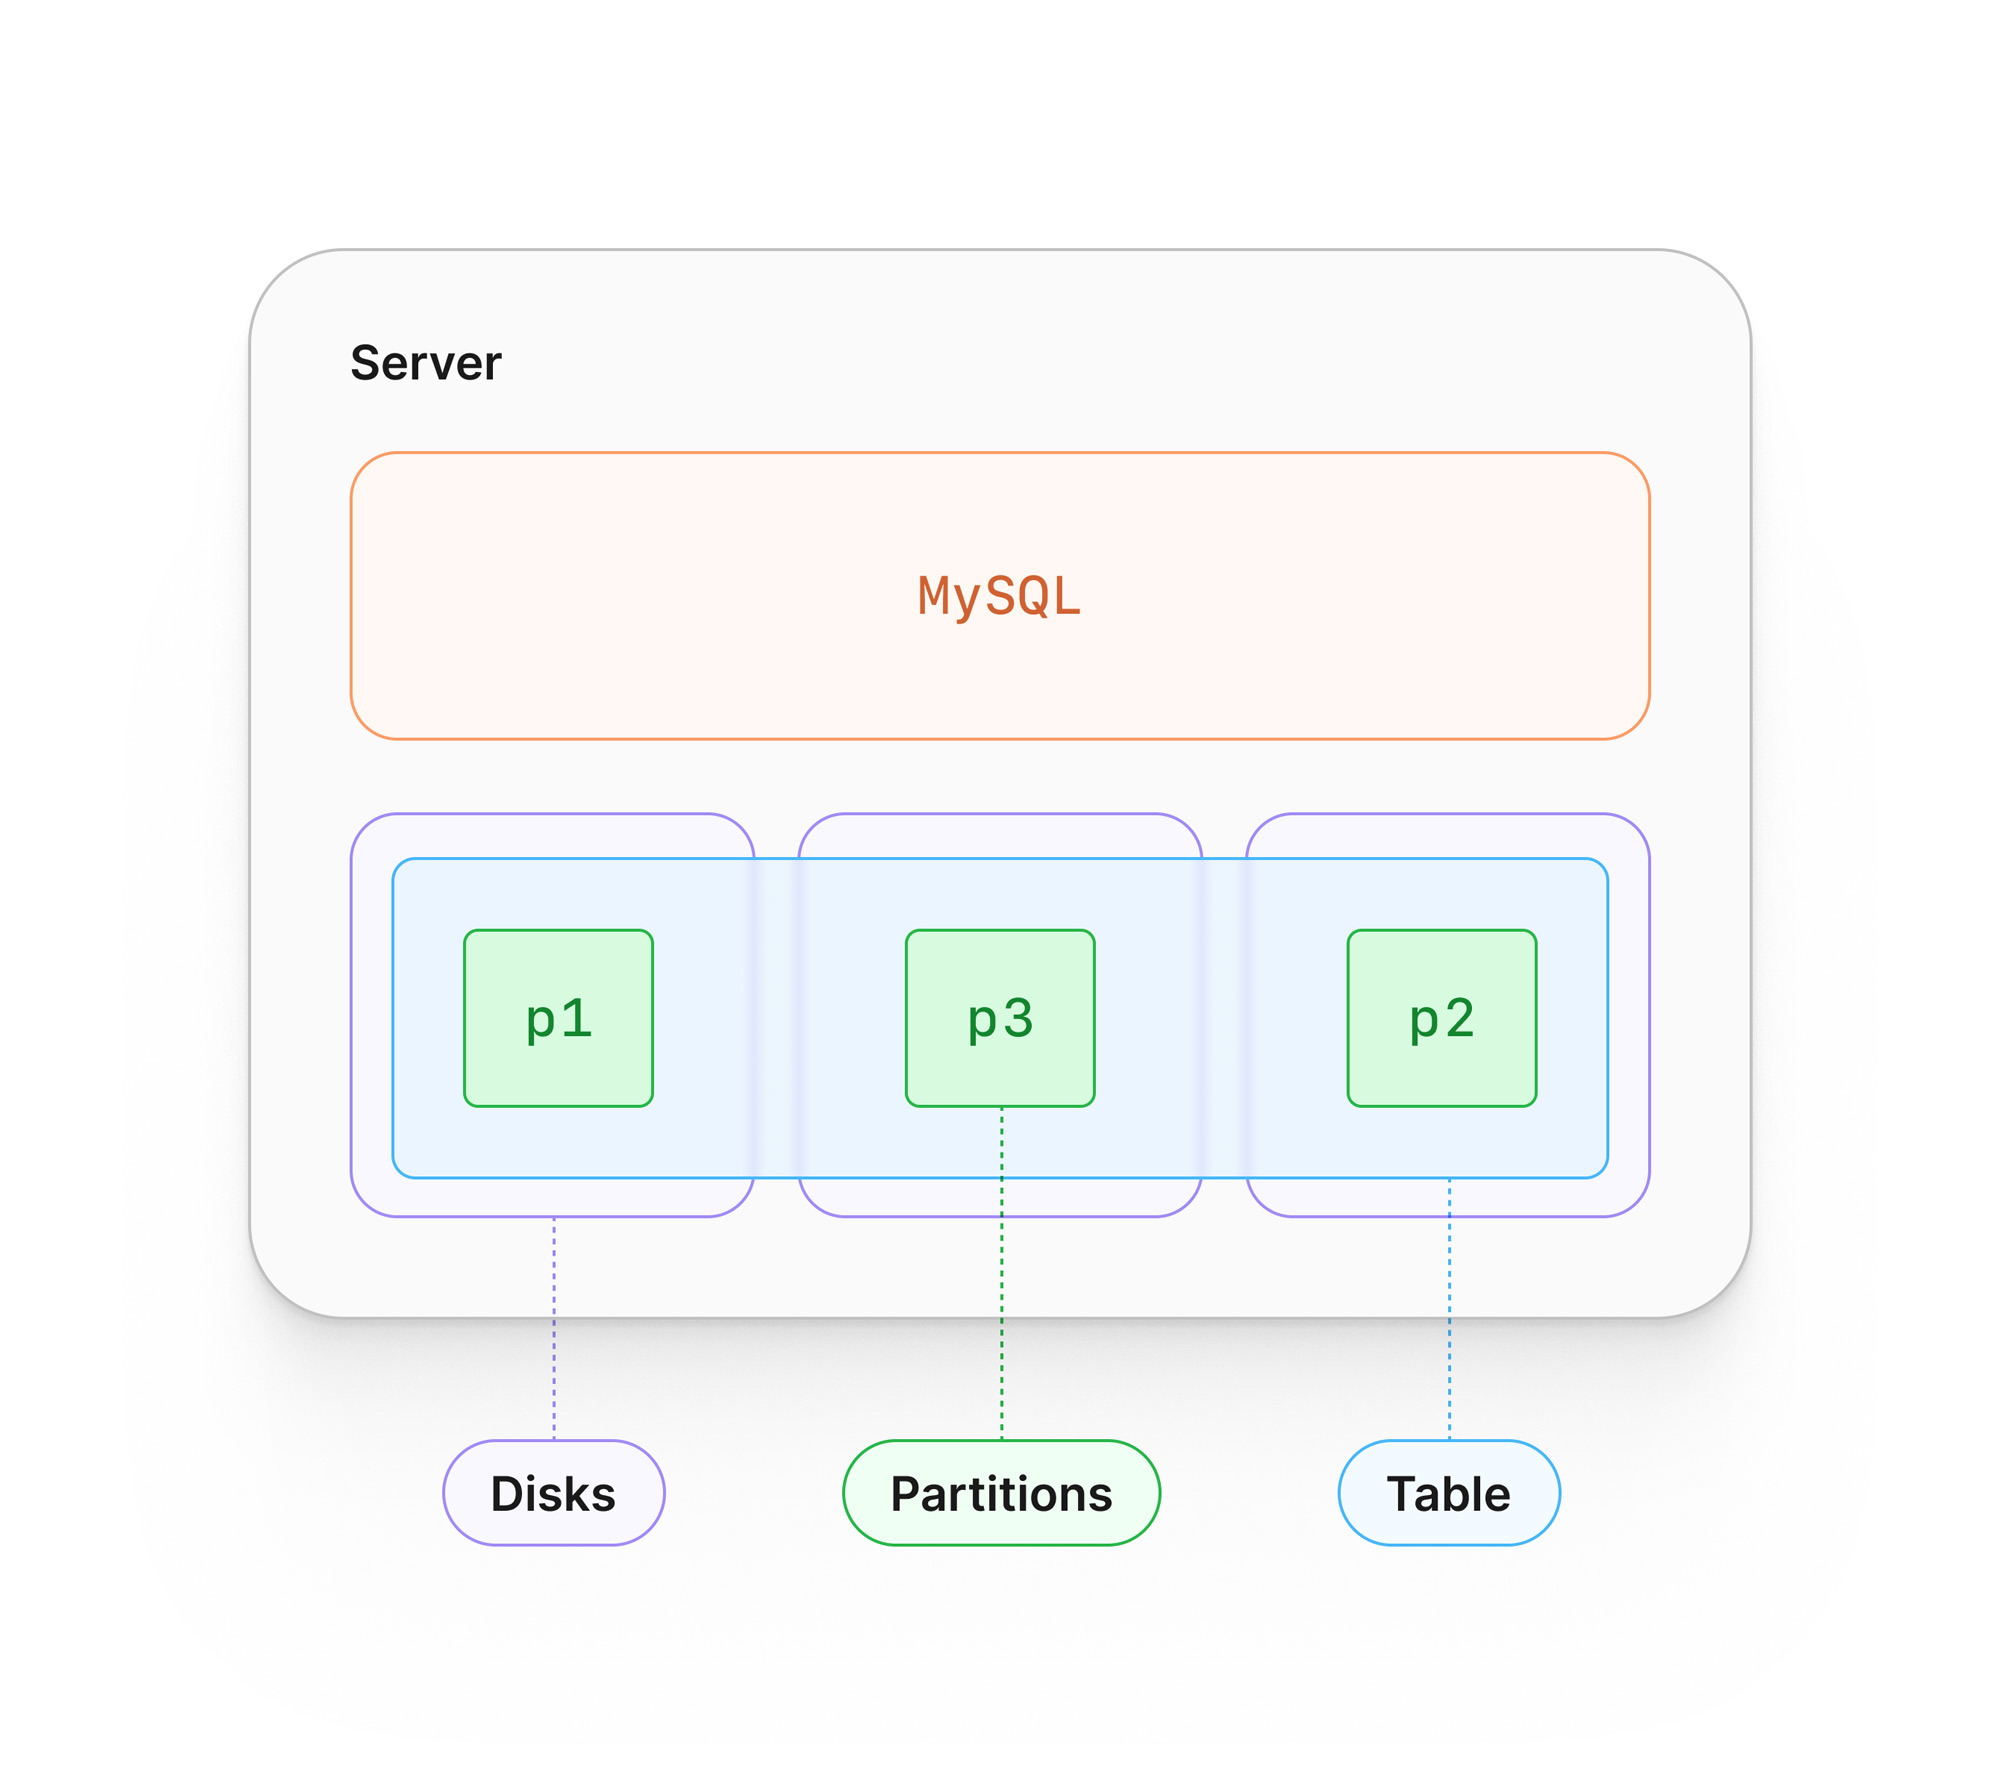
分区(Partitioning)的核心思想是将一个大块拆分成更小的块。在 MySQL 中,“分区”一词指的是将数据库中的单个表进行拆分。
当你在 MySQL 中对一个表进行分区时,该表会被拆分为多个逻辑单元,称为分区(partitions),它们分别存储在磁盘上。当数据写入表时,MySQL 会使用分区函数来决定将数据存储在哪个分区中。给定行中一个或多个列的值将用于这个排序过程。
MySQL 开箱即用地提供了多种分区函数,我们将在下一节中探讨其中几种。
如何在 MySQL 中对表进行分区
数据库开发者可以根据应用需求,使用多种方法对数据进行分区。
使用 RANGE 进行分区
最简单的示例之一是 RANGE 分区策略。通过使用 RANGE,你提供一组数值范围,MySQL 将使用这些范围来放置数据。这将用于你希望创建的每个分区,不过 MINVALUE 和 MAXVALUE 可用于设置范围的最外两端。
以下 CREATE TABLE 示例使用了图书馆的概念,其中书籍根据其 publication_year 被分类到不同的分区中:
CREATE
TABLE
library_books
(
book_id
INT
AUTO_INCREMENT
PRIMARY KEY
,
title
VARCHAR
(
255
)
NOT NULL
,
author
VARCHAR
(
255
),
publication_year
INT
,
isbn
VARCHAR
(
13
),
genre
VARCHAR
(
50
),
checked_out
BOOLEAN
DEFAULT
FALSE,
checked_out_date
DATE
,
due_date
DATE
,
shelf_location
VARCHAR
(
50
)
)
PARTITION
BY
RANGE
(publication_year) (
PARTITION
p0
VALUES
LESS THAN (
2001
),
PARTITION
p1
VALUES
LESS THAN (
2011
),
PARTITION
p2
VALUES
LESS THAN (
2021
),
PARTITION
p3
VALUES
LESS THAN MAXVALUE
);
使用 LIST 进行分区
另一个相对简单的示例是 LIST 策略。
使用 LIST 时,你需要为每个分区提供一组固定的值,以告知 MySQL 如何存储数据。这种策略适用于你确切知道列应包含哪些值的情况。然而,缺点之一是尝试插入包含无效值的行会导致错误。
以下语句展示了与上面相同的示例,但基于一组已知的 author 值进行分区。
CREATE
TABLE
library_books
(
book_id
INT
AUTO_INCREMENT
PRIMARY KEY
,
title
VARCHAR
(
255
)
NOT NULL
,
author
VARCHAR
(
255
),
publication_year
INT
,
isbn
VARCHAR
(
13
),
genre
VARCHAR
(
50
),
checked_out
BOOLEAN
DEFAULT
FALSE,
checked_out_date
DATE
,
due_date
DATE
,
shelf_location
VARCHAR
(
50
)
)
PARTITION
BY
LIST (author) (
PARTITION
p0
VALUES
IN
(
'William Shakespeare'
,
'Jane Austen'
,
'George Orwell'
),
PARTITION
p1
VALUES
IN
(
'J.K. Rowling'
,
'Agatha Christie'
,
'Stephen King'
),
PARTITION
p2
VALUES
IN
(
'J.R.R. Tolkien'
,
'Gabriel García Márquez'
,
'Toni Morrison'
),
PARTITION
p3
VALUES
IN
(
'Haruki Murakami'
,
'Neil Gaiman'
,
'Chimamanda Ngozi Adichie'
)
);
使用 KEY 进行分区
那么,如果你想利用分区功能,但只想让 MySQL 自行处理,该怎么办?
这正是 KEY 分区策略发挥作用的地方。通过使用 KEY,你让 MySQL 使用表的主键(或唯一键)来决定如何排序数据。将使用内部算法来确定如何在指定数量的分区之间最佳地均匀排序数据。
以下示例在前述示例中的同一个 library_books 表上使用 KEY:
CREATE
TABLE
library_books
(
book_id
INT
AUTO_INCREMENT
PRIMARY KEY
,
title
VARCHAR
(
255
)
NOT NULL
,
author
VARCHAR
(
255
),
publication_year
INT
,
isbn
VARCHAR
(
13
),
genre
VARCHAR
(
50
),
checked_out
BOOLEAN
DEFAULT
FALSE,
checked_out_date
DATE
,
due_date
DATE
,
shelf_location
VARCHAR
(
50
)
)
PARTITION
BY
KEY
()
PARTITIONS
4
;
这些只是可用于分区的几种选择类型。要探索所有可能的策略,请参阅 MySQL 文档。
MySQL 分区的优点和缺点
正确应用分区可带来多项好处。
这些好处之一是帮助 MySQL 在大表中查询数据。使用上面的 RANGE 示例,如果你想查询 2007 年出版的所有书籍,MySQL 只需要扫描 p1,而不需要扫描整个表来找到请求的数据。如果你需要跨分区查询,这些操作可以并行执行,如果分区存储在多个存储设备上,速度会更快。
MySQL 分区的另一个潜在好处体现在选择维护操作上。
例如,截断分区中的所有数据比在同一数据上执行 DELETE ... WHERE 语句更快。备份操作也可以在单个分区上执行,这可以减少整个服务器的负载。重建索引或回收未使用空间也可以按分区进行,而不是在整个表上进行。
在提高性能方面,分区并非万能药,因为它有几个缺点。
根据你想使用的分区策略,你可能受限于要分区列的可用的数据类型。例如,大多数策略不允许使用 ENUM。此外,你需要正确理解你的访问模式,因为不平衡的分区可能会限制你从分区中获得的性能提升。
如果你正在决定是否在 MySQL 中对数据进行分区,那么在测试系统上进行工作以确保它能为你的环境带来切实的好处是值得的。
注册我们的免费数据库扩展课程,了解更多关于分区、复制、分片等扩展策略!
分区 vs. 分片
PlanetScale 专注于数据库分片的能力已不是秘密,但这与分区有何不同?
分区和分片背后的概念非常相似。关键区别在于,分区发生在同一台服务器上,并且由 MySQL 原生支持,而分片数据库将表拆分到不同的服务器上,需要外部机制来实现。由于分区涉及一台服务器,它被认为是垂直扩展,而分片是水平扩展。
PlanetScale 提供完全托管的 Vitess 集群,具有显式的水平分片。
每个生产数据库分支至少有一个主 MySQL 节点以及一个故障转移节点。虽然分片不是开箱即用的配置,但 Vitess 通过结合无状态代理(将查询路由到正确的 MySQL 节点)和拓扑服务器(使整个系统了解各个节点的任何变化)来处理得非常好。
由于我们的构建重点在于分片和水平可扩展性,PlanetScale 不支持分区。
实际上,分区是通往更高性能的垫脚石。由于重点放在单个服务器上,如果您的 MySQL 服务器发生灾难性故障,它仍然会造成单点故障。由于我们在分片方面的专业知识,分区对我们已经做的事情几乎没有增加价值。
结合基于资源的定价,您可以在 PlanetScale 数据库中获得水平扩展和垂直扩展的最佳效果。
要探索另一种称为分片的可扩展性方法,请阅读我们博客上的“数据库分片如何工作”。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/what-is-mysql-partitioning
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

