随着应用使用量的增长,性能可能会逐渐下降。
这句话本身并不令人意外,但令人意外的是可能出现的瓶颈数量以及可供你选择的解决方案。其中一个瓶颈可能直接与数据库读写所需的时间有关。毕竟,在关系型数据库的复杂性背后,你仍然在使用具有固有 IO 延迟的存储系统。
这正是架构良好的缓存系统可以发挥作用的地方。
一个好的缓存系统可以减少数据库的负载,并提升应用的整体性能。更快的应用意味着更满意的用户,也可能带来更多的收入,这始终是好事!然而,缓存系统有其自身的搭建复杂性,以及一些可能意外出现的陷阱。
在本文中,我们将探讨后端缓存、如何实现它、缓存如何与 MySQL 配合工作,以及需要注意的潜在问题。
什么是缓存?
从最核心的意义上讲,缓存是一种存储数据的组件,以便可以更快地访问这些数据。
缓存可以是基于硬件的,也可以是基于软件的。通常,缓存系统将数据存储在内存中,这使得访问和操作这些数据的速度要快得多,因为它不依赖于固态硬盘或机械硬盘等传统存储系统。这些缓存系统可以在服务器上本地运行,也可以配置为在独立系统上独立工作。
独立于其他服务运行的缓存被称为分布式缓存。
Redis(内存数据结构存储系统) 和 memcache 是两种非常流行的分布式缓存系统,可以被外部系统访问。这些系统会利用其运行所在系统的内存,以键/值的方式存储数据,使开发者能够根据特定键快速取回数据。它们甚至可以配置在多台服务器上作为集群运行,进一步增强其分布式特性。
那么,缓存和 MySQL 如何协同工作,让应用程序运行得更快?
想了解 Instagram 早期是如何扩展性能的吗?来看看 Instagram 首位全职后端工程师 Rick Branson 的 Database Caching Tech talk,他在其中分享了所有细节。
在 MySQL 环境中实现缓存
虽然 MySQL 通过查询缓存提供了一些基本的缓存功能,但仍有很大的改进空间。
因此,为了正确利用缓存系统,它需要数据。MySQL 没有任何内置机制来填充(或注入)缓存,所以这项任务的责任落在应用程序代码上。最终,你需要构建一个系统:如果缓存中存在数据,则从缓存返回;如果不存在,则从数据库返回并填充缓存。
设计缓存系统时,有两种常见模式可供使用:旁路缓存(look-aside)和穿透缓存(look-through)。
示例:检索用户的关注者数量
在接下来的示例中,我们将使用以下数据库图。它模拟了一个社交媒体平台,包含两张表:users 和 followers。
每个示例将展示缓存如何缩短查看给定用户关注者数量时的加载时间。这听起来可能是一个相对简单的问题,但请考虑如果某个用户拥有特别多的关注者,数据库将承受多大的负载。每次查看该用户的个人资料时,都必须对表执行 SELECT COUNT 查询,仅仅为了返回一个数字。
查询关注者数量的语句如下:
SELECT
COUNT
(
*
)
FROM
followers
WHERE
follower_id
=
?
旁路缓存(Look-aside cache)
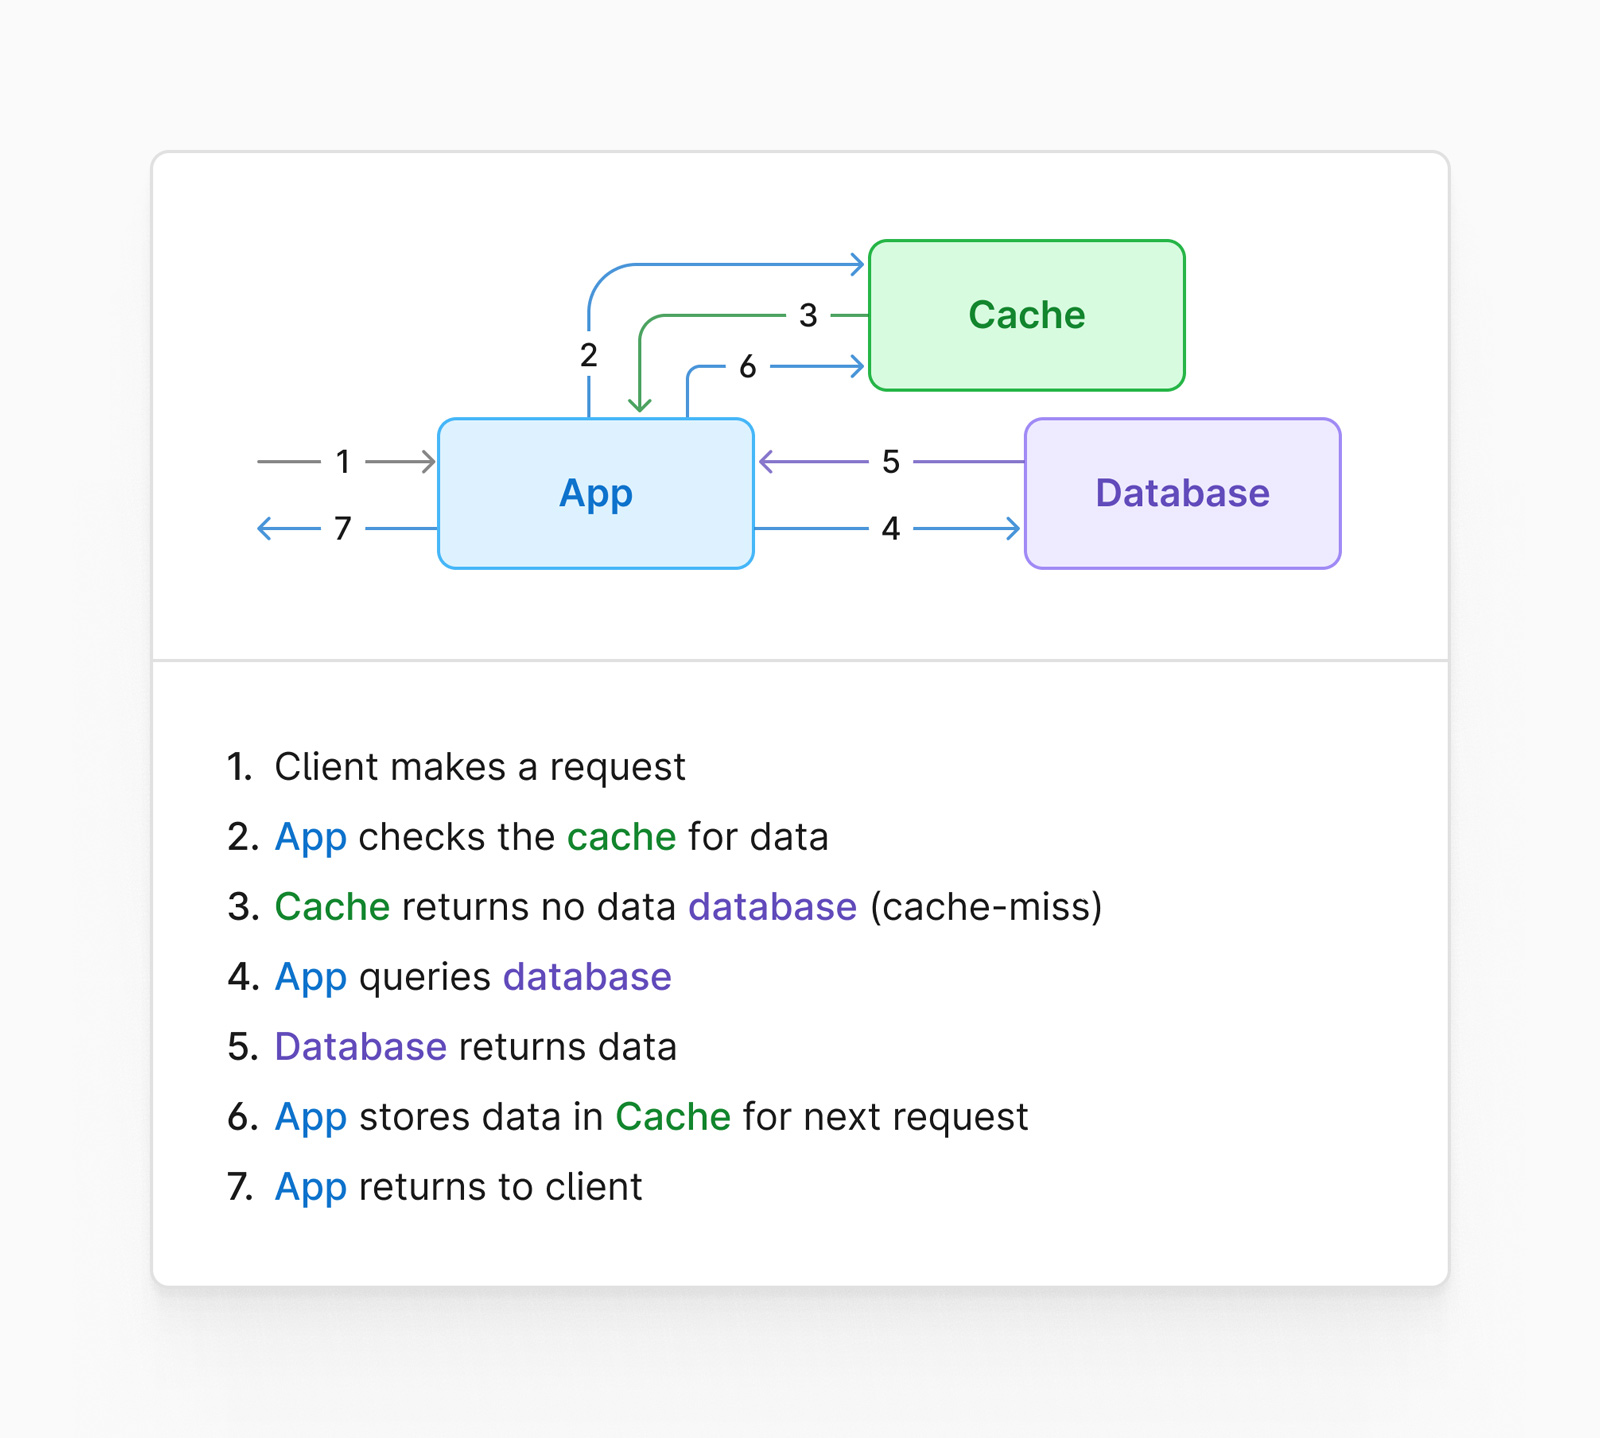
旁路缓存是一种位于数据库数据访问路径之外的系统。
通常,这种设置在其工作流程中有两个不同的步骤。以我们检索关注者数量的示例来说,应用程序首先会检查缓存中是否包含所请求用户的关注者数量。如果缓存中不包含该信息(这被称为缓存未命中),代码将直接从数据库中获取该值,为后续请求填充缓存,最后将其返回给调用方。
该流程的可视化展示:
穿透缓存
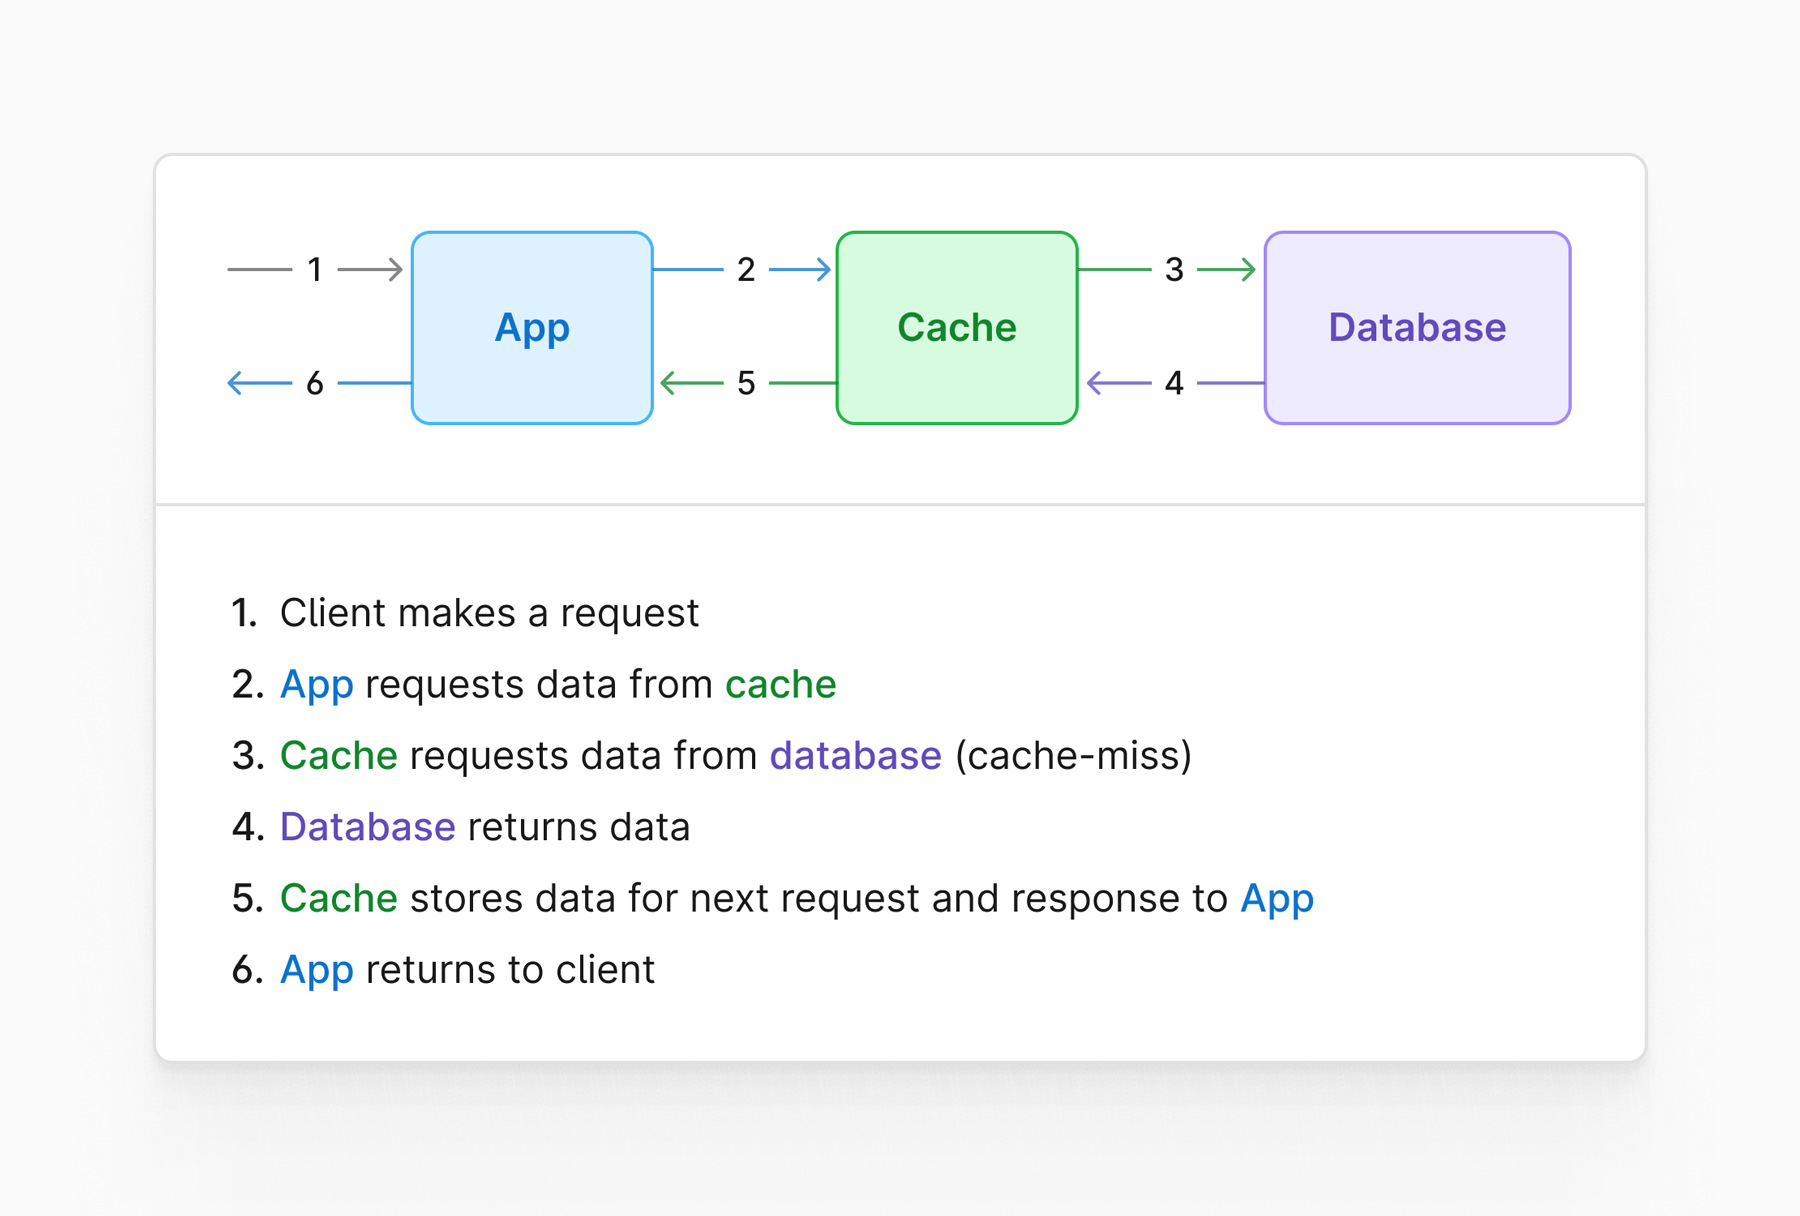
穿透缓存是一种位于数据访问路径中、数据库前方的系统。
在这种场景下,代码会直接访问缓存。如果发生缓存未命中,则由缓存软件负责从数据库请求数据并自行填充。在此期间,调用方会等待该过程完成后再返回给用户。
以下图表展示了穿透缓存设置的运作方式:
缓存的潜在问题
在以下章节中,我们将探讨缓存系统的一些潜在问题,以及缓解这些问题的方法。
数据不一致
其中一个问题是缓存中的数据不准确或不是最新的。
假设我们的调用方在上午 9:00 请求关注者数量,返回值为 1,120。然后在上午 9:15,由于一条帖子走红,该用户新增了 1,500 名关注者。你需要考虑一种更新缓存的方法。
第一个可能的解决方案是,每当有新关注者添加时就直接更新缓存。
这种方法的好处在于它相对直接。你不仅向数据库发出 UPDATE 语句,还会增加当前存储在缓存中的值。问题在于,对于这 1,500 个新关注者中的每一个,你也会更新缓存(和数据库)1,500 次。
第二种解决方案是为每个值存储一个缓存过期时间。
在这种情况下,你可以设置缓存过期时间为 20 分钟。当缓存在上午 9:00 填充时,该值将保留在缓存中直到上午 9:20。当用户的关注者数量增加 1,500 时,上午 9:15 到 9:20 之间的任何调用者将收到旧的计数,但这个窗口足够短,可能可以接受,以防止架构中出现系统性问题。
每种解决方案都有其权衡,这是在配置缓存时需要考虑的环境因素。
惊群问题
惊群问题指的是太多调用者同时尝试更新缓存,导致性能问题的情况。
使用上一节中的相同示例,假设你有 3,000 个客户端在上午 9:20 整尝试从缓存请求数据。所有 3,000 个进程都会确定缓存已过期,并尝试同时重新填充缓存。这不仅可能导致问题,而且完全没有必要。
解决此问题的一种方法是配置所谓的“缓存租约”。
本质上,每个客户端都会有一个唯一标识符。当第一个调用者尝试重新填充缓存时,系统会将其唯一 ID 记录为负责更新该特定值的进程。所有其他客户端将在缓存更新期间收到旧值。
一旦值更新,租约就会被释放,直到缓存中的值再次过期,未来的请求将收到最新的值。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/distributed-caching-systems-and-mysql
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

