原理
keepalived是集群管理中保证集群高可用的一个服务软件,用来防止单点故障。在web集群中
Keepalived的作用是检测web服务器的状态,如果有一台web服务器死机,或工作出现故障,Keepalived将检测到,并将有故障的web服务器从系统中剔除,当web服务器工作正常后Keepalived自动将web服务器加入到服务器群中,这些工作全部自动完成,不需要人工干涉,需要人工做的只是修复故障的web服务器。
和heatbeat 的区别
Keepalived使用的vrrp协议方式,虚拟路由冗余协议 (Virtual Router Redundancy Protocol,简称VRRP);Heartbeat是基于主机或网络的服务的高可用方式keepalived的目的是模拟路由器的双机heartbeat的目的是用户service的双机lvs的高可用建议用keepavlived业务的高可用用heartbeat
工作原理
keepalived是以VRRP协议为实现基础的,VRRP全称Virtual Router Redundancy Protocol,即虚拟路由冗余协议。
虚拟路由冗余协议
可以认为是实现路由器高可用的协议,即将N台提供相同功能的路由器组成一个路由器组,这个组里面有一个master和多个backup,master上面有一个对外提供服务的vip(该路由器所在局域网内其他机器的默认路由为该vip),master会发组播,当backup收不到VRRP包时就认为master宕掉了,这时就需要根据VRRP的优先级来选举一个backup当master。这样的话就可以保证路由器的高可用了。
keepalived主要有三个模块core
keepalived的核心,负责主进程的启动、维护以及全局配置文件的加载和解析check负责健康检查,包括常见的各种检查方式VRRP实现VRRP协议
安装
yum install keepalived -y
/etc/keepalived
/etc/keepalived/keepalived.conf     #keepalived服务主配置文件
/etc/rc.d/init.d/keepalived         #服务启动脚本
/etc/sysconfig/keepalived
/usr/bin/genhash
/usr/libexec/keepalived
/usr/sbin/keepalived
配置文件说明
1-13行表示全局配置
global_defs {    #全局配置
    notification_email {   定义报警邮件地址
      acassen@firewall.loc
      failover@firewall.loc
      sysadmin@firewall.loc
    }
    notification_email_from Alexandre.Cassen@firewall.loc  #定义发送邮件的地址
    smtp_server 192.168.200.1   #邮箱服务器
    smtp_connect_timeout 30      #定义超时时间
    router_id LVS_DEVEL        #定义路由标识信息,相同局域网唯一
 }
15-30行 虚拟ip配置 brrp
vrrp_instance VI_1 {   #定义实例
    state MASTER         #状态参数 master/backup 只是说明
    interface eth0       #虚IP地址放置的网卡位置
    virtual_router_id 51 #同一家族要一直,同一个集群id一致
    priority 100         # 优先级决定是主还是备    越大越优先
    advert_int 1        #主备通讯时间间隔
    authentication {     # ↓
        auth_type PASS    #↓
        auth_pass 1111    #认证
    }                        #↑
    virtual_ipaddress {  #↓
        192.168.200.16    设备之间使用的虚拟ip地址
        192.168.200.17
        192.168.200.18
    }
}
主备测试
主配置
! Configuration File for keepalived

global_defs {
   router_id lb01
}

vrrp_instance VI_1 {
    state MASTER
    interface ens33
    virtual_router_id 51
    priority 150
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        192.168.50.100
    }
}
备配置
! Configuration File for keepalived

global_defs {
   router_id lb02
}

vrrp_instance VI_1 {
    state BACKUP
    interface ens33
    virtual_router_id 51
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
     192.168.50.100
    }
}
一台机器宕机,不会影响访问
脑裂
在高可用(HA)系统中,当联系2个节点的“心跳线”断开时,本来为一整体、动作协调的HA系统,就分裂成为2个独立的个体。由于相互失去了联系,都以为是对方出了故障。两个节点上的HA软件像“裂脑人”一样,争抢“共享资源”、争起“应用服务”,就会发生严重后果——或者共享资源被瓜分、2边“服务”都起不来了;或者2边“服务”都起来了,但同时读写“共享存储”,导致数据损坏(常见如数据库轮询着的联机日志出错)。
应对策略
1)添加冗余的心跳线,例如:双线条线(心跳线也HA),尽量减少“裂脑”发生几率; 2)启用磁盘锁。正在服务一方锁住共享磁盘,“裂脑”发生时,让对方完全“抢不走”共享磁盘资源。但使用锁磁盘也会有一个不小的问题,如果占用共享盘的一方不主动“解锁”,另一方就永远得不到共享磁盘。现实中假如服务节点突然死机或崩溃,就不可能执行解锁命令。后备节点也就接管不了共享资源和应用服务。于是有人在HA中设计了“智能”锁。即:正在服务的一方只在发现心跳线全部断开(察觉不到对端)时才启用磁盘锁。平时就不上锁了。 3)设置仲裁机制。例如设置参考IP(如网关IP),当心跳线完全断开时,2个节点都各自ping一下参考IP,不通则表明断点就出在本端。不仅“心跳”、还兼对外“服务”的本端网络链路断了,即使启动(或继续)应用服务也没有用了,那就主动放弃竞争,让能够ping通参考IP的一端去起服务。更保险一些,ping不通参考IP的一方干脆就自我重启,以彻底释放有可能还占用着的那些共享资源。
原因
😶 高可用服务器对之间心跳线链路发生故障,导致无法正常通信。 因心跳线坏了(包括断了,老化)。 因网卡及相关驱动坏了,ip配置及冲突问题(网卡直连)。 因心跳线间连接的设备故障(网卡及交换机)。 因仲裁的机器出问题(采用仲裁的方案)。 😶 高可用服务器上开启了 iptables防火墙阻挡了心跳消息传输。 😶 高可用服务器上心跳网卡地址等信息配置不正确,导致发送心跳失败。 😶 其他服务配置不当等原因,如心跳方式不同,心跳广插冲突、软件Bug等。 提示: Keepalived配置里同一 VRRP实例如果 virtual_router_id两端参数配置不一致也会导致裂脑问题发生。参考链接
keepalived+lvs
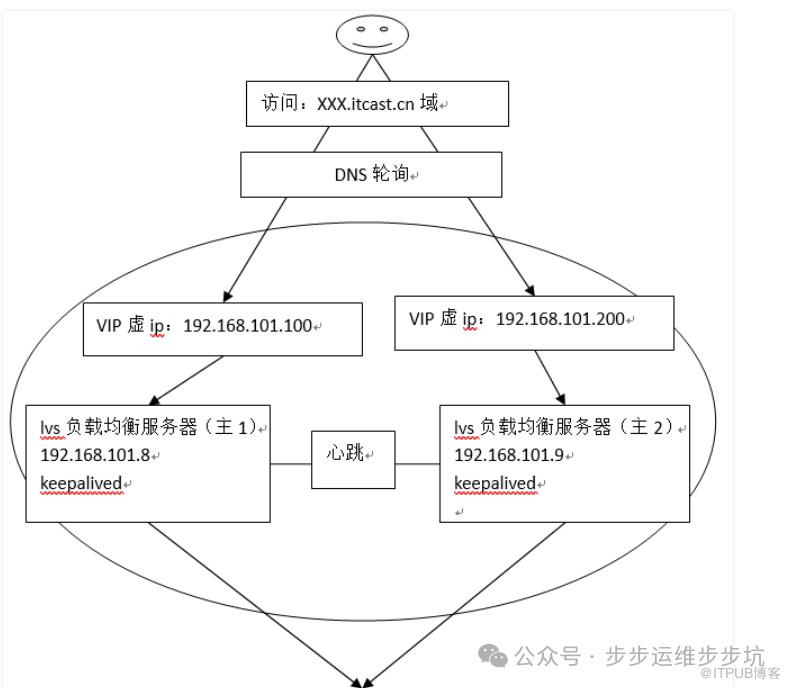
每台lvs绑定一个vip,共两个vip,DNS设置域名对应这两个vip,通过DNS轮询每次解析到不同的vip上即解析到不同的lvs上。
其中一个主机宕机,每台lvs上安装的keepalived程序会检测到对方宕机,将宕机一方的vip漂移至活动的lvs服务器上,这样DNS轮询全部到一台lvs继续对外提供服务。
原文作者:步步运维步步坑;如有侵权,请联系管理员删除。

