数据库响应缓慢问题排查
问题分析
1.主机CPU使用情况
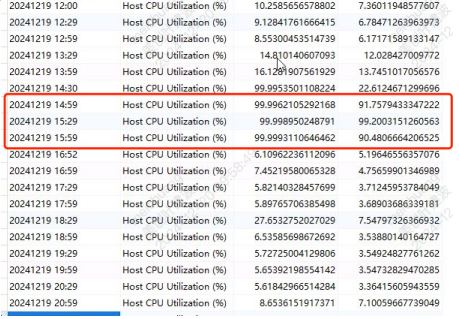
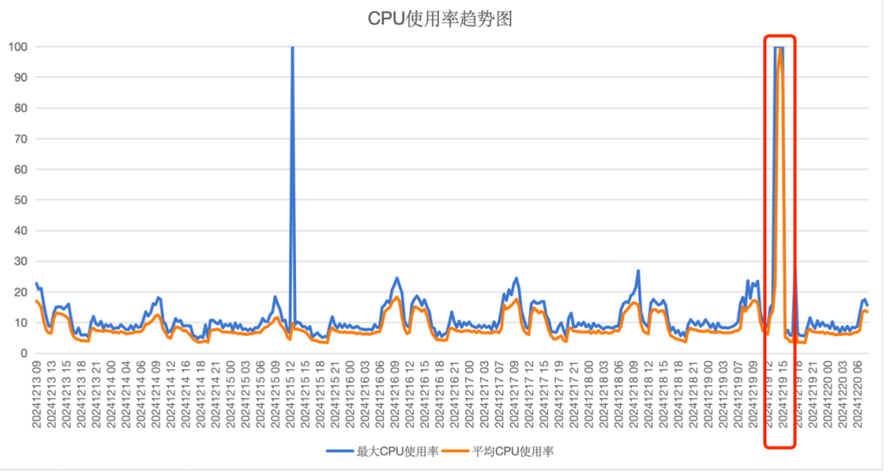
通过历史CPU采样信息来看,数据库主机CPU从12月19日 下午14:59开始,CPU使用率飚升至100%。
2.数据库日志
通过数据库两节点数据库日志看来,问题之前并没有出现数据库的系统报错(如ORA-0600/ORA-07445等),表明数据库软件自身没问题。
以下是节点2的的日志,包括从开始杀外部进程,到停止数据库,再到启动数据库的一整个过程日志。
2024-12-19T15:21:39.872831+08:00 ========>从15:21开始杀数据库连接,之前没有任何数据库报错
KILL SESSION for sid=(396, 32138):
Reason = alter system kill session
Mode = KILL SOFT -/-/-
Requestor = USER (orapid = 664, ospid = 68277, inst = 1)
Owner = Process: USER (orapid = 1928, ospid = 34395)
Result = ORA-0
.......
2024-12-19T16:36:38.854166+08:00 ========>16:36:38秒分开始停数据库
Shutting down ORACLE instance (abort) (OS id: 14669)
2024-12-19T16:36:38.854279+08:00
Shutdown is initiated by oraagent.bin@orcl02 (TNS V1-V3).
License high water mark = 1758
USER (ospid: 14669): terminating the instance
2024-12-19T16:36:39.879424+08:00
Instance terminated by USER, pid = 14669
2024-12-19T16:36:40.877473+08:00
Instance shutdown complete (OS id: 14669) ========>16:36:40秒完成停数据库
2024-12-19T16:50:22.941352+08:00
Starting ORACLE instance (normal) (OS id: 85898)========>16:50开始启动数据库
2024-12-19T16:50:23.047895+08:00
.......
2024-12-19T16:52:57.356991+08:00
CJQ0 started with pid=333, OS id=92120
Completed: ALTER DATABASE OPEN /* db agent *//* {2:30379:2} */========>16:52完成启动数据库
3.数据库等待事件
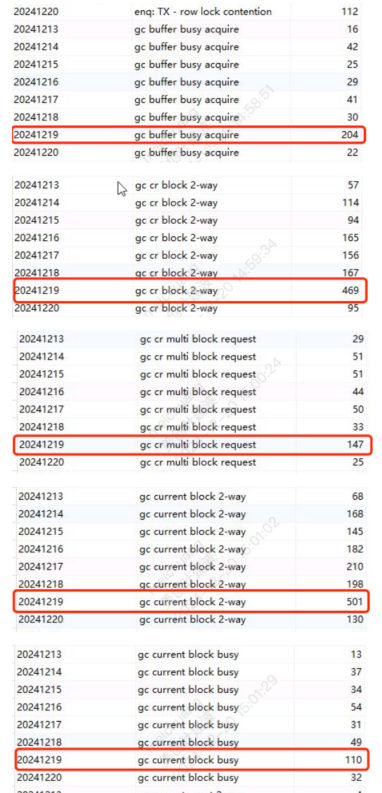
通过白屏工具登录数据库后按天统计,发现存在大量较多的异常等待。
主要是由于RAC架构下,双节点访问相同对象(表、索引等数据),需要两个节点间进行请求、数据交互等。这类gc类型的等待一直都有,表明业务都是双节点访问的,但是在19号(主要就是问题时间段导致增加)数据会比平常要多,主要是当时查询量大,数据库整体性能变差导致。
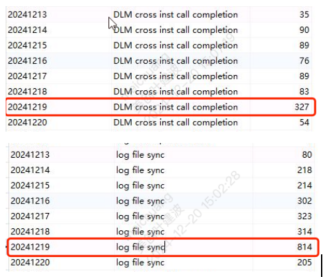
同时还会发现DLM cross inst call completion和log file sync 异常等待比平常要多,这两种等待都是跟LGWR(日志写入进程)写有关,因为当时CPU几乎耗尽,所以系统进程的执行效率也很差,但是这个是被影响的。
4.SQL语句
统计从12月19日下午14点开始到17点间(问题时间段)发现活动会话主要集中在都是在执行2类SQL执行,如下:

问题语句1:7vh4u42js4903。 对应SQL为:
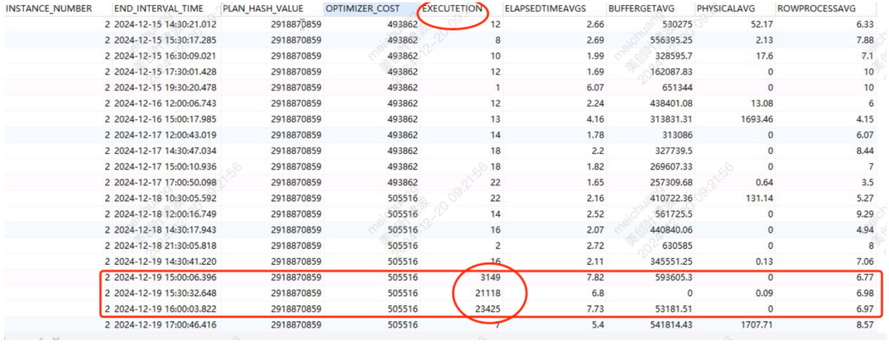
节点1和节点2都有执行该语句,最早执行时间12月13号(因为历史记录保留7天),所以不是新上业务。
但是12月19日下午15点开始,执行计划没有变化,但是执行次数是平常的1000多倍。平均执行效率为7秒左右(正常2秒)

问题语句1:03u86150cutjd。对应SQL为:
情况与与上一个一致。
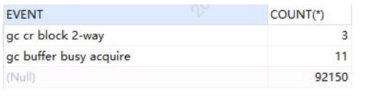
 这2条SQL语句在问题期间主要等待事件为空,说明主要还在在ON CPU。
5.客户端信息
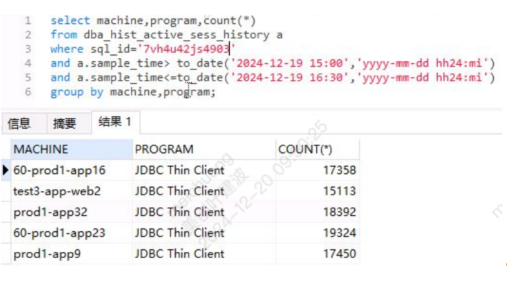
问题语句1:7vh4u42js4903。对应应用发起主机如下:
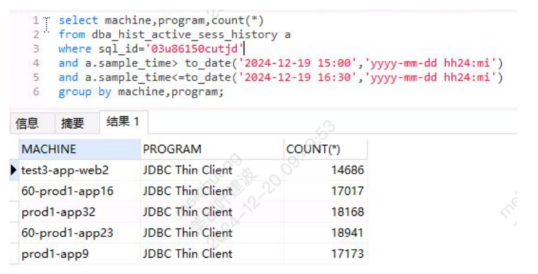
问题语句2:03u86150cutjd。对应应用发起主机如下:
建议总结
1.需要业务厂家分析这两条SQL执行次数为什么突增,主要分析突增,因为检查发现执行计划并未发生改变,表明执行效率并没有问题,问题期间平均变慢是因为执行次数太大导致,与语句本省效率无关。
2.业务访问是双节点的,如果可以建议想同业务单节点访问,避免节点间gc资源争用。在量小的情况下,关系不大,但是当量大了,gc争用就很明显,导致SQL执行效率会变差。所以建议相同业务在同一节点方案。
3.本次故障影响时长较长,从15:00开始到接近17点才完成全部处理,建议复盘下故障应急处理方案是否完善合理。
4.本次告警监控是否及时发现问题,主机CPU使用率监控及数据库健康度监控是否能力具备,也可以提前发现介入处理。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31547506/viewspace-3060643/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Oracle 2026年5月安全补丁:CSPU月度更新机制与紧急应对指南
- Oracle 26ai安全实战:构建基于AI的SQL防火墙与智能体防御体系
- Oracle 26ai智能运维:基于DeepSeek的AWR报告自动诊断
- Oracle 26ai自治湖仓一体:打通Iceberg数据湖与AI分析
- Oracle 26ai实战:零代码构建企业级RAG知识库
- Oracle 26Ai自然语言搜索实战:基于生成式AI的数据库查询
- Oracle 26Ai智能索引推荐实战:AI驱动的自动化性能调优
- Oracle 23c安全性增强实战:细粒度访问控制与数据屏蔽
- Oracle 23c分区增强实战:自动分区管理简化运维
- Oracle 23c区块链表实战:构建不可篡改的数据审计系统
