概述
分布式系统(Distributed System)是建立在网络之上的软件系统。正是因为分布式系统是由软件在硬件基础上构建的,其具有软件特性,所以分布式系统具有高度的内聚性和透明性。因此,网络和分布式系统之间的区别更多的在于高层软件(特别是操作系统),而不是硬件[1](类似这样的是脚注格式,非文献引用,请注意)。
分布式系统需要解决的一个核心问题,是观察数据时如何保障一致性的问题,此类问题,即分布式一致性问题。而分布式一致性,存在多种情况,这些情况统一由一致性模型(Consistency Models[2])表示。常见的一致性有线性一致性、顺序一致性、因果一致性等。
而“Consistency models”包括的一致性,从强度的角度,可以分为两种,一种是强一致性,另外一种是弱一致性(参考文献[8])。其中,线性一致性和顺序一致性归属强一致性,其他的归属弱一致性,但相对又有强弱之分。
CAP理论提出在分布式系统环境下,为了应对不可避免的网络分区(Partitions ,简写为P)事件发生,常牺牲数据的一致性(Consistency,简写为C)而换取服务可用(Availability,简写为A);或者保证数据的强一致性而牺牲可用性。
BASE[3]则是牺牲了强一致性而采用了弱一致性中的最终一致性模型,换取服务的持续可用。
而CAP的作者在2012年[4]和2017年[5]提出C和A还是有机会在一定条件下共存的。CAP和BASE理论在分布式系统领域影响深远,但从Spanner问世后渐成过去。分布式和事务型数据库结合,使得分布式数据库中的强一致性和事务一致性被再次重视,因为在数据库层提供强大的分布式一致性和事务一致性融合的服务,能够减轻应用层研发者的负担(减少或避免数据异常出现,即避免不一致性问题出现),不需要应用层研发者精通掌握分布式一致性和事务一致性的全部深奥语义且时刻应用于实践;如此会极大简化应用研发的负担,提高工作效率。
如下章节,将就上面谈及的具体的内容展开进行详细讨论。
ACID、BASE和CAP
ACID是数据库事务处理的四个特性,本节不就其基本概念进行讨论。而是着重于探讨ACID、BASE与CAP之间的关系。
BASE 是一个弱一致性模型,Fox和Eric Brewer等在文献[4]中首次提出,目的是表达与ACID“相反”的语义以帮助在不稳定的网络环境下构建分布式系统,容忍分区发生。其中:
Basically Available:基本可用,是指一个分布式系统在分区发生时,依然能对外提供部分服务。
Soft state[6]:软状态,是描述系分布式统健壮性的一个词语,允许系统中的数据存在中间状态,而此中间状态不会影响系统的整体可用性,例如允许分布式系统在不同节点的数据副本之间进行数据同步的过程存在延时(即允许某些时刻存在不一致但最后要满足最终一致性)。
Eventual consistency:最终一致性,描述系统中所有的数据副本,在经过一段时间后,最终能够达到一个一致的状态。即不需要实时保证系统数据的强一致性。
如上三者语义,使得一个分布式系统多个组件之间协作不在强耦合,弱耦合的系统则成为一个异步系统,理论推导和工程实现变得简单。
Eric Brewer在1999年发表的文献[4]和2000年的PODC会议上对ACID和BASE进行了对比,如图1所示。BASE相对ACID,弱化了强一致性的要求,把可用性提到最高程度,使得系统的设计更为简单,而缺少事务处理则使得基于BASE的系统运行速度更快。
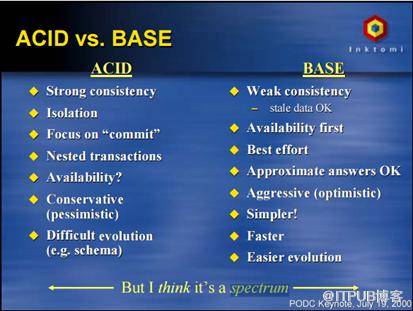
图1 ACID和BASE对比图
而对于数据库事务处理的ACID四个特性,Eric Brewer认为[7]:
原子性(A):原子性操作对任何系统都是有益的,在网络分区发生时,在考虑分区各侧的可用性的时候,是需要保持各侧操作的原子性。而且,满足ACID定义的、高抽象层次的原子操作会简化分区恢复。
一致性(C):ACID的C指的是不能破坏任何数据库的约束,如主键的唯一性约束;也不能出现某个隔离级别不允许发生的数据异常。而CAP的C仅是指在“one-copy”(效果类似作用在单副本上)上的分布式一致性和事务一致性,因此其与ACID一致性有交集。但是,旧的观念,事务的ACID一致性不可能在分区过程中保持(跨分区的事务),因此分区恢复时需要重建ACID一致性(比如使用异步方式同步数据)。另外,分区期间也许不可能维持某些不变性约束,所以有必要仔细考虑哪些操作应该禁止,分区后又如何恢复这些不变性约束。
隔离性(I):如果系统要求ACID的隔离性,那么它在分区期间最多可以在分区一侧维持隔离性。跨分区的事务的可串行性(Serializability)要求全局的通信,因此在分区发生的情况下不能成立。在分区恢复时,通过补救办法确保隔离性使得在分区发生之前和之后保持一个较弱的正确隔离性定义是可行的。
q持久性(D):尽管开发者有理由(持久性成本太高)选择BASE风格的软状态来避免实现持久性,但是放弃持久性没有意义,其道理和原子性一样。让分区两侧的事务都满足ACID特性会使得后续的分区恢复变得更容易,并且为分区恢复时事务的补偿工作奠定了基本的条件。
在BASE的基础上,Eric Brewer进一步提出了CAP。详情参见后文。
之后,BASE被用于构建大型高可用可扩展的分布式系统,如NoSQL系统,和传统事务的ACID特性是相反的,通过牺牲强的事务一致性来获得可用性,并允许数据在一段时间内处于不一致状态,但最终达到一致状态。
CAP理论
1. CAP历史与发展
CAP理论,始于1998年Eric Brewer等的文献[13],其概念被周知于2000年,被证明于2002年。这一个时间段,正是互联网兴起,传统的关系型数据库理论提出的ACID不能满足互联网业务发展对于高可用性的需求,因此引发了人们对于构建大型互联网业务系统应该具备的属性的思考。因而由20世纪90年代之前已经成型的ACID的C出发到90年代末提出的CAP的C,ACID的事务的一致性是CAP中C的出发点,也是C概念的基本落脚点。
但是,CAP中的C,在2002年被Seth Gilbert和Nancy Lynch定义为了外部一致性(本书统一称为分布式一致性,文献[7][7])。因此,理解一致性成为了重点。通常,CAP的三个特性的常规理解如下:
一致性(Consistency):读一个数据项,读取[8]到最新的值。文献[7]把C定义为基于原子数据对象(Atomic Data Object)的原子一致性(Atomic Consistency),而此一致性,表达的含义为“读操作未能立即读到此前最近一次写操作的结果,但多读几次还是获得了正确结果。所有对数据的修改操作都是原子的,不会产生竞态冲突[9]”。
可用性(Availability):每个系统访问的请求都收到成功或失败的响应。
分区容忍(Partitions):系统中任意消息的丢失或失败,不影响系统的继续运行。
这三个属性之间,分区是不可避免的,因此分区容忍是必须要满足的。一致性和可用性在分区事件存在的前提下只能二选一。如图2是Eric Brewer在2000年的PODC会议首次提出的CAP猜想图。

图2 首次提出的CAP猜想图
对CAP理论的发展和认识,分为三个阶段:
第一个阶段:CAP被提出。Eric Brewer在1999年发表文献[4]提出CAP[10]。2000年又于“Symposium on Principles of Distributed Computing (PODC)”会议提出了CAP假定,称为Brewer猜想[8]。这个猜想提出分布式系统的三个属性:一致性(Consistency)、可用性(Availability)、分区容忍(Partitions),合称CAP。
第二个阶段:CAP被证明并被应用:Seth Gilbert和Nancy Lynch在2002年发表了对Brewer猜想的正式证明[5],并给出了一个定理,Brewer猜想演变为CAP定理,又称为布鲁尔定理。此后引发了:分布式系统的架构需要遵守“三个属性只能选二个”的认知。这对分布式系统的构建产生了巨大的影响,尤其是NoSQL系统。互联网等行业基本遵照CAP并构建系统时多数系统选择了以AP方式构建Web Services等大型联机分布式系统,牺牲了C特性。
第三个阶段:重新认识CAP。对于CAP的重新认识,多方有着不同的意见,批评者指出CAP不是适用于所有的分布式系统,支持者则修正或更精准地重新描述了CAP内容。
第一阶段,Eric Brewer提出了分布式环境下的三个系统属性:
在CAP这个猜想中,作者对于C,指的是单拷贝(one-copy)情况(是逻辑上唯一的一份数据),其实质,讨论的是“单逻辑写操作发生后、读操作是不是因为分区事件发生不能读到数据”。如图3所示,左图是不能容忍分区发生的情况,其典型案例是单节点(单逻辑节点)的数据库(Single-site databases)不能容忍分区发生;右图是容忍分区发生时,舍弃可用性的情况,其典型案例是分布式数据库(Distributed databases)。而对于分布式数据库,CAP中的C不仅是数据库系统中事务特性ACID的C,还是分布式数据库中每份数据需要保证跨节点的写事务成功则之后的读操作能满足外部一致性,而节点的写事务失败则之后的读操作能读取写事务之前的最新数据也确保满足外部一致性。
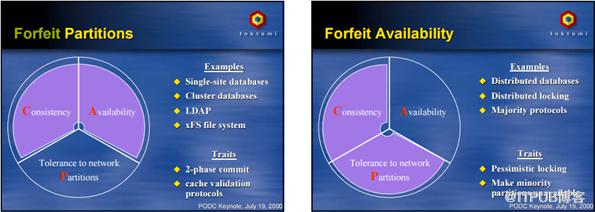
图3 一致性的初始含义图
尽管Eric Brewer认为分布式系统中C、A、P三个属性只能确保其中的二个,但是他认为对于数据库系统:“Databases better at C than Availability”。可惜这个观点被后人忽略掉了。
另外,在文献[4]中,Eric Brewer限定了的强一致性、高可用性、分区复原的范围[11]:
强一致性:在单个拷贝(不是多个副本中的单个副本)上具有ACID语义的一致性。这是一个逻辑上的概念(系统实现时为确保高可用,每一份数据会有多个副本,保证强一致性更为复杂)。强一致性满足有更新(UPDATE)操作的应用。
高可用性:高可用性可通过数据冗余提供,例如多副本的数据复制。如果某个给定的数据总是能有一定个数的副本存活且能提供服务,则数据服务具有高可用性[12]。
分区复原:分区发生后复原,整个系统可以在多数据副本之间恢复数据。
然后,Eric Brewer又描述了 “Strong CAP Principle”,对于选CA舍弃P的情况采用分布式事务语义进行举例,这意味着没有分区发生则一致性和可用性都可以得到保证。选CP舍弃A,则一些分布式事务操作应被阻塞直至分区复原,这样一致性可以保证而可用性丢失。选AP舍弃C,则适用于HTTP Web caching类应用。
所以,在1999年、2000年的Eric Brewer看来,CAP是适用于分布式数据库的。
第二阶段,CAP定理被证明:
对于一个异步网络模型,Gilbert S和Lynch NA采用反证法,证明了如图4的定理。这个定理表明分区事件发生,可用性和一致性不能兼得。
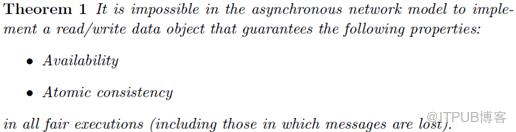
图4 CAP定理1
对于一个部分同步网络模型,Gilbert S和Lynch NA证明了如图5的定理。这个定理表明分区事件发生,可用性和一致性不能兼得。
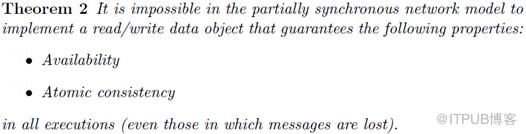
图5 CAP定理2
在文献[1]中,一致性被定义为了“atomic/linearizable consistency[13]”。这和之前Eric Brewer在文献[4]定义的“strong consistency means single copy ACID consistency”相似但不同。这就引发一个问题:分布式数据库中,一致性应该如何定义?
分布式系统由多个物理节点和节点间的网络组成,每一个部分在无故障的情况下正常工作,系统的可用性和一致性都能被保证。
但是因为一些故障,如节点故障、网络故障,使得有些节点之间不再连通。当整个网络就分成了几块区域,数据就散布在那些不连通的区域中,这就是分区。当一个数据项只在一个节点中保存,分区出现后,因此节点不连通或此节点故障,就访问不到这个节点上的数据,这种分区属于不可容忍。而提高分区容忍性的办法之一,是一个数据项提供多个副本[14],在发生分区后(单副本故障或单副本的网络故障),系统中尚有其他副本可读,容忍性得到提高。但是,多副本之间,要同步数据,就对分布式系统中的数据一致性问题带来更大挑战(对于外部一致性还需要考虑副本间数据同步的问题)。
为了保证数据的一致,每个写操作需要写全部节点成功整个写操作才算是成功,只有这种强同步的方式才能保证写操作的写数据一致性、保证之后发生的读操作的读数据一致性。
同步数据的方式会让等待现象发生,而等待又会带来可用性的问题(时延)。
为了提高性能,数据同步的过程被优化,如采用后面谈及的分布式一致性协议Paxos,或异步式的主备复制技术等。
总之,分区发生,不得不容忍其发生。而数据的副本节点越多,分区容忍度越高,但需要同步的数据就越多,数据一致性保证的难度增加。为了保证数据一致性,所有有相同副本的节点间同步数据需要的时间就越长,可用性则降低。
第三阶段,对 CAP提出质疑,主要包括:
CAP没有界定概念的范围,适应情景显得模糊混乱。如分区容错概念有误导。
不适用于数据库事务架构(非NoSQL系统)。
应该构建不可变模型避免CAP的复杂性。
典型的质疑,如Michael Stonebraker在2010年,发表文献[2],指出CAP不适合于分布式数据库系统。Stonebraker认为,不只是CAP理论提及的多节点因网络分区造成错误。在数据库中还有很多因素造成错误,比如:
应用程序错误:应用程序执行一个或多个不正确的更新。对于这样的错误,数据库必须有良好的备份恢复机制,可以允许数据库在任何点上做恢复。
可重复的DBMS(数据库管理系统)错误:DBMS在处理节点上崩溃。用副本在处理节点上执行相同的事务将导致备份崩溃。
不可重复的DBMS错误:DBMS崩溃了,但副本很可能没问题。
操作系统错误:操作系统在一个节点上崩溃,如某操作系统著名的“蓝屏”现象。
本地集群中的硬件故障:包括内存故障、磁盘故障等。
本地集群中的网络分区。局域网失败,节点不能互相通信。CAP系统中的P属性包含这个错误。
灾难:本地群集被洪水、地震等毁灭,群集不再存在。
将集群连接在一起的WAN中的网络故障:WAN有故障,集群不能互相通信。
在这些错误中,应用程序错误和可重复的DBMS(数据库管理系统)错误一旦发生,一定不能保障系统的可用性,多副本的复制技术无助于解决问题。灾难发生,一个集群中的所有硬件、数据等都遭到破坏,可用性也不能具备。即CAP理论不能用于指导解决这三种问题。
Stonebraker还认为,在局域网环境下网络是可靠的,分布式数据库系统应该选择CA,这样其实就是CAP都被满足。在WAN中,有足够的冗余设计,分区事件是非常少见的,而一旦发生分区,则可以选择多数节点的部分继续提供服务,用算法实现此点是容易做到的,所以此种情况下放弃一致性是不明智的。所以CAP理论是存在问题的。
对CAP的新认知
对CAP被质疑后进行解释,主要如下。
Eric Brewer在2012年对CAP的传统认知[7],包括为什么经常用“三个属性只能选二个”的概念可能会被误解或误用,以及CAP的C与事务特性ACID的C之间存在不同定义等,作了澄清。作者认为:实际上只有“在分区存在的前提下呈现完美的数据一致性和可用性”这种很少见的情况是CAP理论不允许出现的。作者还认为:软件设计者仍然需要在分区的前提下对数据一致性和可用性做取舍,但具体如何处理分区和恢复一致性,有着许多的变通方案。新的设计应该考虑如何规划分区期间的操作和分区之后的恢复,这样有助于设计人员加深对CAP的认识,突破过去由于CAP理论的表述(不当或至少是不甚清晰)而产生的误解。而对于CAP的C,作者认可了外部一致性的表述(所有节点访问同一份最新的数据副本)。但是,Eric Brewer依旧认为,CAP的正确性没有发生变化,其适用的场景依然存在。
Eric Brewer从CAP和网络延迟的关系出发,讨论了:
时延和分区的关系:系统需要在某段时间内识别出分区是否发生?检测到分区的节点进入分区模式是优化C和A的核心环节。
分区发生后分区的每一侧是否在没有通信的情况下继续可用?现实场景如Yahoo的PNUTS系统在分区域发生时,放弃强一致性来避免因保持数据一致而带来高的延迟(以异步的方式维护远程副本而带来数据一致性的问题)是有现实和存在意义的。
之后,Eric Brewer指出,即使是实现强一致的分布式数据库系统,在单一数据中心内出现分区的概率极小但毕竟可能存在,所以分布式数据库系统还是需要考虑如何在C和A之间进行取舍。放弃一致性的代价较大,其核心是“并发更新问题”,在系统中可能会有较多的不变性约束。如果选择了可用性,需要在分区结束后恢复被破坏的不变性约束,这就要求必须将各种不变性约束一一列举出来,这样的工作有挑战又容易犯错;所以考虑如何实现“分区后的恢复”以解决如下问题是必要的,这就回到了BASE中提及的最终一致性上:
分区两侧的状态最终必须保持一致,且
必须补偿分区期间产生的错误。
Seth Gilbert和Nancy Lynch在2012年写了文献[3]再次论述了CAP理论。
首先,论文讨论了衡量理论价值的三个指标,分别是:
Safety:安全性,一个算法能确保有更糟糕的事情发生尚能应对,则此算法是安全的。一致性(外部一致性)就是一个具有安全性的属性。
Liveness:存活性,不管什么事情发生一个系统一直具备一定的存活能力则具有存活性。分布式系统的可用性即是一个具有存活性的属性。
Unreliable:不可靠性,很多因素会造成系统的不稳定可靠,诸如网络分区、操作系统宕机、数据库系统宕机、消息丢失、恶意攻击等。
论文认为,根据这三个抽象的衡量指标看,CAP提出的“三个属性只能选二个”的概念是合适的。
其次,论文讨论了一致性所依赖的服务的场景,包括四种:
琐碎的服务(Trivial services,本书称之为无协调的服务):有些服务是微不足道的,因为它们不需要服务器之间的相互通讯以协调达成一致。例如,如果服务返回π小数点后100位的值,这是不需要服务器之间进行协调的。无协调类的服务不属于CAP定理的范围。
弱一致性服务(Weakly consistent services):天然适合CAP的场景。如分布式Web缓存就是这样一个好例子。
简单服务(Simple services):此类服务具有顺序发生的语义,所以用集中的服务器维护某个状态,每个请求按顺序处理,更新状态后对应的读响应有顺序特性(写后立即读能读到最新的写的结果值),适合CAP的场景。此类Web服务是原子的,从客户的视角,就好像是所有的操作均由一个集中的服务器执行。弱一致性如会话一致性、因果一致性等归属于此类简单服务。
复杂的服务(Complicated services):具有复杂语义其特征是非顺序化、需要有多样的交互、协调,即使复杂服务,如数据库的事务语义,CAP不关注这些情况。
第三,给出新的CAP定义如图6,此定义缩小了CAP的适用范围,表明:在受通信故障影响的网络中,任何Web服务都不可能实现保证每个请求响应的原子读/写共享内存。这个定义把分布式数据库排除在外[15]。但是,分布式数据库的架构设计依然需要考虑分区发生时如何应对以确保一致性(分布式一致性和事务一致性)。

图6 CAP定义图
CAP过时论
请参考下一篇。
脚注的参考:
[1]分布式系统的定义相关更多信息可参考:https://baike.baidu.com/item/分布式系统/4905336?fr=aladdin
[2]一致性模型的更多信息可参考:https://en.wikipedia.org/wiki/Consistency_model
[3] BASE:BA基本可用(Basically Available)、软状态(Soft State)、最终一致性(Eventual Consistency)
[4]CAP Twelve Years Later: How the “Rules” Have Changed
[5]Spanner, TrueTime and the CAP Theorem
[6] the use of soft state for robust fault-tolerance to characterize the data semantics of many network services
[7][211]中描述:Discussing atomic consistency is somewhat different than talking about an ACID database, as database consistency refers to transactions, while atomic consistency refers only to a property of a single request/response operation sequence. And it has a different meaning than the Atomic in ACID, as it subsumes the database notions of both Atomic and Consistent.
[8] CAP中的C是从“读取”数据的角度出发,讨论一致性的。这种一致性在本书第二章中被定义为次序一致性。但是对于分布式事务型数据库而言,因需要对事务支持,这种一致性进一步升华为分布式事务一致性和分布式一致性的融合,此融合在本书称为“严格可串行化(Strict serializability)”。在文献[5]严格可串行化又被称为“strong (or strict) one-copy serializability”,在文献[6]中被称为“外部一致性(external Consistency)”。请注意该一致性融合了“线性一致性(linearizability)”和可串行化两者。
[9]更多信息可参考:https://zh.wikipedia.org/wiki/内存一致性模型
[10] Eric Brewer是基于Web Servies类系统提出CAP假定的,但作者在提出CAP之时就思考、对比过其假定与数据库系统的不同之处。因此Eric Brewer是考虑过CAP对数据库系统的影响的,但是由于研究范围有限,尤其是没有深入研究分布式数据库系统的事务处理子系统,因此CAP提出之际没有深入、全面地论述其对数据库的影响。
[11]原文:In this discussion, strong consistency means single copy ACID consistency; by assumption a strongly consistent system provides the ability to perform updates, otherwise discussing consistency is irrelevant. High availability is assumed to be provided through redundancy, e.g. data replication; data is considered highly available if a given consumer of the data can always reach some replica. Partition-resilience means that the system as whole can survive a partition between data replicas.
[12]注意:这是在同一份数据层面上提供的可用性,而同一份数据被维护在不同的节点上,所以可称之为“节点可用性”。但如果同一份数据的所有的副本都发生故障或者发生分区事件,则彻底丧失高可用性。而同一份数据的部分副本/节点发生故障或者发生分区事件,可维护一定的可用性(但需要考虑发生故障副本/节点数目为多数)。
[13]原文:There must exist a total order on all operations such that each operation looks as if it were completed at a single instant. This is equivalent to requiring requests of the distributed shared memory to act as if they were executing on a single node, responding to operations one at a time.
[14]但是需要注意,CAP的C其作者本意是单拷贝不是单副本下的一致性。其原文[7]是:the C in CAP refers only to single‐copy consistency。
[15]注意:不意味着CAP不适合分布式数据库。
文献参考:
文献[1] Ling Zhang, Matthew Butrovich, Tianyu Li, Yash Nannapanei, Andrew Pavlo, John Rollinson, Huanchen Zhang, Ambarish Balakumar, Daniel Biales, Ziqi Dong, Emmanuel Eppinger, Jordi Gonzalez, Wan Shen Lim, Jianqiao Liu, Lin Ma, Prashanth Menon, Soumil Mukherjee, Tanuj Nayak, Amadou Ngom, Jeff Niu, Deepayan Patra, Poojita Raj, Stephanie Wang, Wuwen Wang, Yao Yu, William Zhang. Everything is a transaction: unifying logical concurrency control and physical data structure maintenance in Database Management Systems. Conference on Innovative Data Systems Research (CIDR) 2021.
文献[2] Carsten Binnig, Andrew Crotty, Alex Galakatos, Tim Kraska, Erfan Zamanian: The End of Slow Networks: It's Time for a Redesign. PVLDB 9(7): 528-539 (2016)
文献[3] Boyu Tian, Jiamin Huang, Barzan Mozafari, Grant Schoenebeck: Contention-Aware Lock Scheduling for Transactional Databases. PVLDB 11(5): 648-662 (2018)
文献[4] Towards Robust Distributed Systems
文献[5] Bailis P, Davidson A, Fekete A, et al. Highly available transactions: Virtues and limitations. In Proc. of VLDB. 2013. 181-192.
文献[6] J. C. Corbett, J. Dean, M. Epstein, A. Fikes, C. Frost, J. J. Furman, S. Ghemawat, A. Gubarev, C. Heiser, P. Hochschild et al., “Spanner:Googles globally distributed database,” ACM TOCS, 31(3), p. 8, 2013.
文献[7] S. Gilbert and N. Lynch. Brewer’s conjecture and the feasibility of consistent, available, partition-tolerant web services. SIGACT News, 33(2):51–59, 2002.
文献[8] Paolo Viotti, Marko Vukolic:Consistency in Non-Transactional Distributed Storage Systems. ACM Comput. Surv. 49(1): 19:1-19:34 (2016)

4. 第三代分布式数据库(4)——为什么要100%保证数据的正确性?(下)
5. 第三代分布式数据库(4)——为什么要100%保证数据的正确性?(下)
8. 第三代分布式数据库(7)——比较拉胯的PostgreSQL
扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

