注释:如下所提及的文献,请按照索引号对应参考《分布式数据库原理、架构与实践》一书的引用参考。
基本的分布式OCC算法
文献[112,116]把OCC算法应用到分布式数据库系统中,其基本思想为:
q读取阶段维护读集、写集,这一点和上节介绍的内容所述相似。
q验证阶段,每个子节点上的子事务按照单机节点进入验证阶段;如果所有相关节点的子事务验证通过,则全局事务验证通过。但是,请注意这一结论并不正确(节点上的本地并发访问控制,应该是基于封锁的并发访问控制机制,而不是MVCC机制,MVCC机制需要在协调器上判断是否存在全局冲突)。另外注意,还是需要协调器来解决冲突的,并不是“所有相关节点的子事务验证通过,则全局事务验证通过”。如图4-8所示,T1和T2两个节点是分布式事务,T3和T4是局部事务,在site A上存在T1->T3->T2的关系,在site B上存在T2->T4->T1的关系,各个子节点发现不了全局的事务T1和T2互相依赖,只有把这些信息汇总在协调器上统一分析,才能发现存在环,也就是不满足可串行化调度。
q写入阶段,采取2PC机制保证写的原子性。
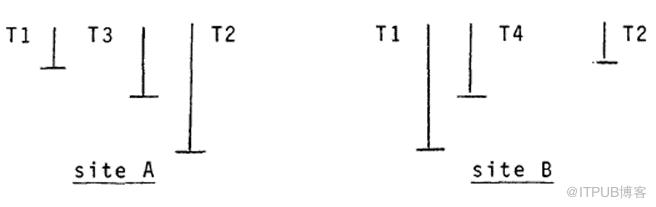
图4-8 分布式事务,需要全局协调图
文献[112]讨论了在分布式数据库中使用OCC技术。对于只读事务,维护读集(同一个对象只从数据库读取一次,之后从读集中获取),但不进入验证阶段,即认为不存在读写冲突(对于UPDATE引发的写操作,会被强行要求延迟进入验证阶段从而保证只读事务读阶段总是有效的。与文献[112]形成对比的是文献[116],其所给出的分布式OCC算法是一个读友好的算法,有利于分析型系统的实现。其具体实现方式,可参考文献[116])。对于UPDATE操作引发的写事务,存在三个阶段,允许有并发的只读事务,但是并发的UPDATE操作引发的写事务可能因冲突而致使回滚发生,并发的只读事务只会致使本事务的写阶段延迟。对于验证阶段,其算法如下:
L: waitset: = 0;< for all t ∈ {active read transaction} do //从活跃的只读事务的读集中取出每个数据项if (write set of T intersects with read setof t) //如果与本验证事务有交集thenwaitset: = waitset ∪ {t};if waitset ≠ Ø then //与只读事务有交集则推迟本事务的验证,让本事务等待beginwait (waitset); //等待退出临界区goto Lend;validation as to update transactions;write phase > //符合“<”和“>”表示代码段处于临界区
上述算法要求在一个临界区内完成,这对于一个分布式数据库而言是难以实现的。文献[112]给出一个解法:把验证阶段细分为两个子阶段,引入“tentative write”阶段和读取阶段的两个时间戳值以及两个判断规则,保证了任何事务都不能修改暂时写入但尚未最终写入的数据,并且任何事务都不能完成读取不安全(即“tentative write”)对象的操作。
文献[112]还讨论了局部事务和全局事务在验证时和全局读写事务之间的关系,文献中提出:本地的读事务和全局的读事务的验证,要和全局UPDATE引发的写操作事务进行验证阶段的判断,只有这样才能确认是否存在冲突;而本地的写事务需要和本地的写事务、全局的写事务进行验证阶段的判断,只有这样才能确认是否存在冲突。
文献[116]是对[112]的补充,该文献提出,在分布式系统下,存在两个问题:
q分布式事务的验证阶段和写入阶段,因分布式的存在,不同节点上无法实现临界区,故无法保证在临界区内按可串行化的调度顺序执行。这就需要另外的机制保证这两个阶段串行执行。
q分布式事务中各节点子事务在验证阶段采用的可串行化标准可能不一致。比如,可以使用TO算法,并用全局逻辑时间戳作为事务标识,以确保各节点在验证阶段使用相同的可串行化标准。这一点其实和OCC没有必然关系,在分布式下,不同节点进行各自验证,都需要有相同的可串行化标准。
文献[118]也基于OCC讨论了分布式事务处理机制(参考4.3.2节)。

改进的分布式OCC算法
文献[115]提出改进的分布式OCC算法,该算法在分布式系统中支持了OCC和封锁算法的融合。在读取阶段没有使用封锁算法,保持了OCC的高并发度的优势。在验证阶段,引入了封锁算法,目的是避免处于预提交的数据项被读取到。即对于1.1.4节提及的“读半已提交数据异常”,使用封锁机制加以解决,排它锁施加在预提交的对象上,等到全局事务完成才释放锁,避免了读数据出现读不一致的问题。施加锁的方式,也解决了验证和写入阶段在分布式系统下难以构造临界区的问题。但是施加锁又可能出现死锁问题,需要在分布式系统范围内进行死锁检测或预防。文献[115]在验证阶段施加锁和验证的算法如下:
< < //进入临界区VAUD :=true;for all k in RS(T,S) do; //从读集中遍历数据项if (X-lock set or X-rcqucst is waiting for k) thenVALID:= false;if lock conflict then do; //存在锁冲突,则等待if k in WS(T,S) //写集是读集的子集then place X-request into waiting list WL; //WL,等待队列else place S-request into WL;end;else do; {no lock conflict} //不存在锁冲突,则施加锁if k in WS(T,S)then XT := T {acquire X-lock};else append T to ST list (acquire S-lock};end;if wct(k,T) < WCT(k) then VALID := false; (validation} //WCT是k数据项对象的修改次数计数器,相当于对象的逻辑时间戳值,标识对象是不是最新被修改的,如果不是,则意味着有其他并发事务修改了该值,验证失败end; >> //退出临界区if VALID then do; //验证成功,任何数据项上没有被施加锁,则可以提交wait (if necessary) until all lock requests at S are granted;write log information; {pre-commit)send O.K.;end;else do;wait (if neeessarv) until all lock requests at S are granted;send FAILED;end;
文献[52]提出另一种分布式OCC算法——ROCOCO (ReOrdering COnflicts for COncurrency) ,该算法在分布式系统中的每个物理节点Server上,先跟踪并发事务之间的依赖关系(确定性事务故可静态分析),但不实际执行它们。当事务提交时,事务的依赖关系信息被发送到所有Server上,以便并发事务可以重新按某个可串行化调度方式排序,从而减少冲突。文献[52]的实验结果表明:ROCOCO算法的吞吐量比2PL和OCC算法分别高出130%和347%。除了ROCOCO算法外,还有其他算法采用的也是基于确定性事务的处理思路,限于篇幅这里不再展开,大家可以自行查阅文献[43、156]。
文献[118]提出另一种分布式OCC技术,该技术消除了两阶段提交期间的封锁操作,但要求每个事务在分布式数据库系统中的所有数据服务器上执行验证(包括事务未访问的数据服务器),此举增加了网络间消息传递和处理的开销,同时也破坏了分布式数据库的许多优点,如负载分布和容错性,限于篇幅这里不再展开,大家可自行查阅该文献。值得注意的是,文献[118]中提出的算法还使用了动态时间戳机制,这部分内容将在4.5.1节继续讨论。
还有人在一个分布式的工程系统Megastore上提出了OCC算法,但因为其数据划分是以实体组(entity group)为单位,Megastore只在一个实体组上确保可串行化,且同时只能执行一个事务,所以并不是一个真正的分布式OCC算法实现。对此感兴趣的读者可以查阅文献[122]。

扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

