为什么AI会算错简单数学题?秘密就藏在 "思维链"里!本文用轻松 对话形式解读五篇论文,让你秒懂让AI变身"超级大脑"的黑科技:
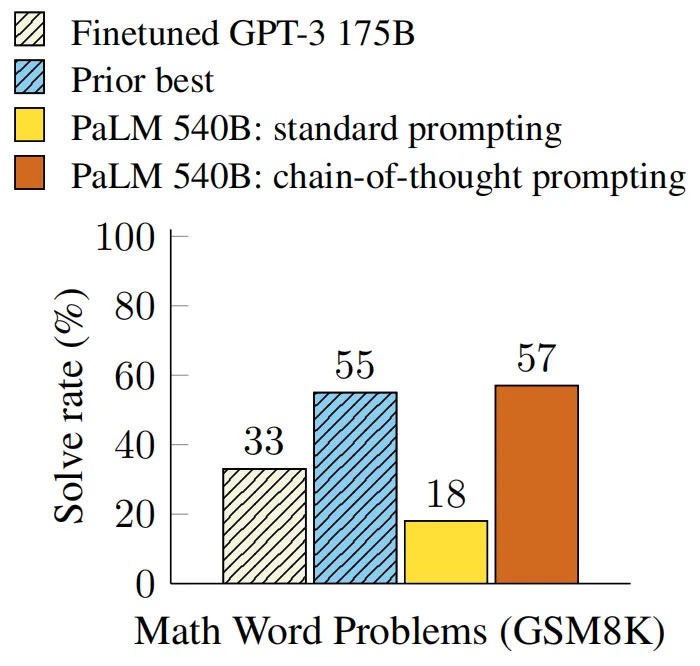
1️⃣ 手把手教:让AI 在答题前先看 范例,正确率即可从 18% 飙至 57%!
2️⃣ 咒语觉醒:仅凭一句 Let's think step by step ,AI立刻聪明 3倍!
3️⃣ 双剑合璧: 两招一起用,AI性能暴涨,复杂测试 反超人类平均水平!
4️⃣ 群体智慧:让AI生成 多个思维链,用 多数投票机制,性能再提 18%!
5️⃣ 自我进化:生成 “题-思维链-答案”合成数据,自我训练,永无上限!
DeepSeek-R1的核心思想源于这些论文的贡献。更为难得的是,这五篇论文皆符合三个特性: 1. 较为浅显;2.极为重要;3.易于落地。这实属罕见,不容错过!

⓵手把手教( Few-shot-CoT)
彬老师:今天我们来探讨大模型的思维链。说到思维链则不得不提起 Jason Wei的 《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》,该论文奠定了“思维链”技术的基础。
小渣:Jason Wei?是不是先在Google,后去 OpenAI的那位天才?
彬老师:对,他在OpenAI负责O1和深度研究工作。实际上,OpenAI的O1、O3推理模型以及DeepSeek-R1的核心思想,都可以追溯到他的这些早期贡献。
弘老师:ason Wei 的方法简单有效。就是在问模型问题的同时,附上示范问题、示范答案及示范答案的思考过程。这样模型有样学样,就能回答的更好了。这里需要注意的是,仅给示范问题的答案而不给思考过程,效果会很差。比如论文中给模型一个问题"罗杰有5个网球,他又买了2罐,每罐有3个网球,他现在有多少个网球?",如果只告诉它答案是11,而未解释原因,模型是无法做到举一反三的。
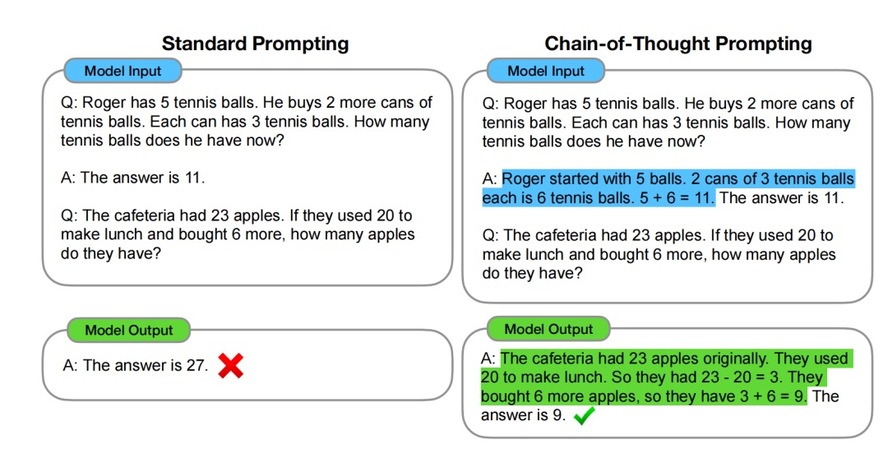
小渣:23-20+6=9,模型居然做错了如此简单的数学。
彬老师:如果之前的示范并非单纯告诉它答案是11,而是这样教它:“罗杰一开始就有5个球,而罗杰又买了2罐,每罐3个网球,这里就有6个网球,所以答案是5+6=11。” 它就明白了,回答新题就不会犯这种低级错误了。
弘老师:是的,有了这种思维过程的示范,模型在回答新问题时,也会自然而然地展现出类似的思考路径——自助餐厅有23个苹果,用20个苹果做了午餐,剩23-20=3个苹果,又买了6个苹果,所以现在有3+6=9个苹果。
大饼:哇!就好像我们小时候学数学,老师不仅告诉我们答案,更重要的是教我们解题思路。
彬老师:是的,Jason Wei把这种方法称为Few-shot Chain-of-Thought,简称Few-shot-CoT。论文中该方法将模型性能从18%提升到57%,效果惊人。
小渣:也就是说,模型其实已经"学会"了思考,只是需要我们给它一个示范,告诉它"该怎么思考"?
彬老师:是的,这就引出了我们今天要探讨下一个关键内容,一起来看看第二篇论文。
未完待续....
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3079619/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
