
1
全军覆没——大模型征战高考数学卷
弘老师: 全军覆没! 表现最好的大模型离及格线还差十多分,还没考生的平均分高。
小涂: 这么差?这跟我们看到的信息差距也太大了!

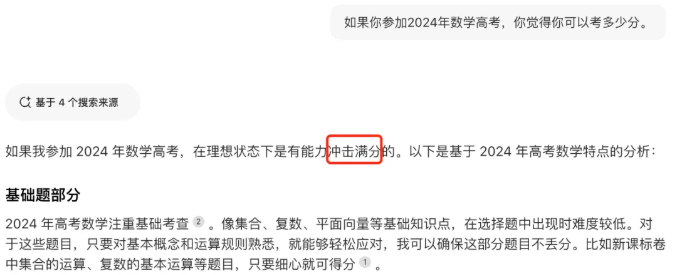
弘老师: 大模型“记住答案”其实就是更新参数的过程,你这么理解也算对。斯坦福大学曾发表了相关论文 《Putnam-AXIOM: A Functional and Static Benchmark for Measuring Higher Level Mathematical Reasoning》 ,指出,当题目稍作变换,准确率则会大幅下降。有兴趣的朋友可以下载阅读,深入了解。

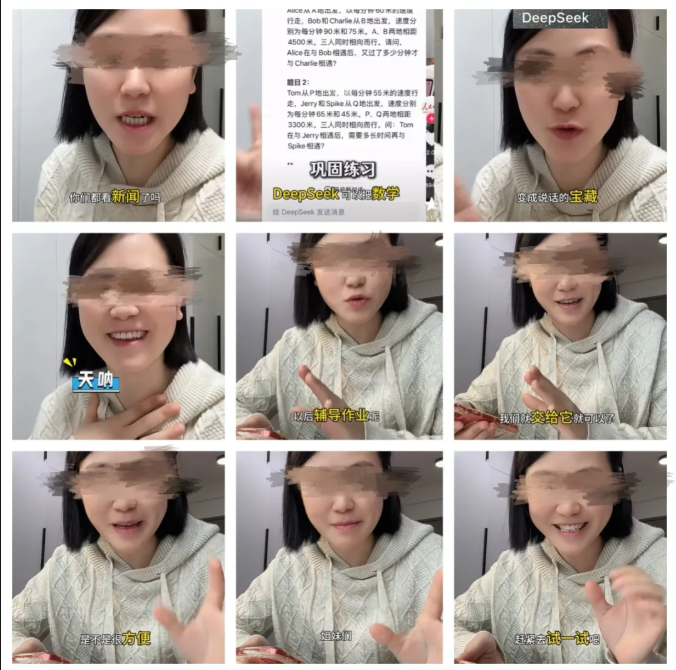
彬老师: 其实,不止是高考,就连小学3年级以下的奥数题,各大模型的正确率也基本只能维持在50%左右,大家可以自行验证。但是你看下图,一位主播正眉飞色舞地分享如何用DeepsSeek教孩子学数学,还让DeepsSeek来出相似题目来考孩子,这样做,瞎出题的概率极高,很可能适得其反。
2
三大因素——保障模型推理质量的关键
弘老师: 会。比如凌晨5点访问平台时,用户少,系统资源充足,模型有足够算力进行复杂推理,答案可能更准确;而在白天高峰期,用户多,算力紧张,准确性可能下降。在企业本地部署中,这种现象更明显,当算力不足时,模型可能会跳过关键步骤、降低计算精度,甚至直接罢工。解决办法只能是增加显卡,提升GPU算力。
弘老师: 可以,但需要访问外部的数据 ( 详见链接: 《 AI海马体 》 ) 。比如企业数据或互联网数据。所以, 第二个 影响AI推理质量的因素是—— 外部访问 。如果允许模型上网搜索,它可能从做错变成做对。
3
云泥之别——当下垂直领域专用AI碾压大模型
总结
(三点认知)
1. 对当下
大模型学科能力的认知
目前,通用大模型在高考数学方面表现仍处
“学渣”
水平。不仅
如此,
在物理、化学、生物等科目上成绩也难以及格。不过,其在语文、英语、历史等科目中表现相对不错,准确率可达80%。
2. 模型与
个人能力强相关的认知
当下,
善用AI的人
优势将进一步
扩大
,个人
能力水平越高
,向AI提出的
提问越有智慧
,就越能从AI那里获得高质量的回复(
专家介入
)。而且,对AI大模型运行原理了解得越深入(
GPU算力,外部访问...
)
,你就越清楚如何让它更顺畅地运行,发挥出更好的效果
(详见链接
《
AI大揭秘
》
)
。
3. 对
大模型与专用AI差异的认知
虽说专用AI和大模型都采用了深度神经网络技术,但是两者架构差异很大。目前专用AI在垂直领域的能力
远超
通用大模型(
“奥数拿金奖”
vs
“数学不及格”,“碾压顶尖棋力”
vs
“围棋业余5级”,“诺贝尔奖”
vs
“略懂皮毛
”...
)。不过,未来大模型必定能一统江湖之时,
其实,这和
关系型数据库能开始融合各个专用数据库场景
,走向超融合(一体化),是一个道理。到那时,
就是通用人工智能时代到来之际
(详见链接:
《
穿越者
》
,
《
未来已来
》
)。
倡议
(从我做起)
在未来的网络环境中,虚假和错误的观点可能会愈发泛滥。一方面,部分博主为追逐热点,
盲目传播未经证实的信息
;另一方面,大模型本身也可能
给出诸多错误回复
。因此,我们必须保持
持质疑精神
,不轻易
接受
和
传播
未经核实的内容
。只有通过
亲自动手确认
、
多AI交叉验证
及查找
第一手信息源
(
详见链接
:《
乱象
》)
,才能有效避免被误导。
或许不久后,大模型就能达到高考数学满分的能力,但即使如此,大家也应自行验证其对错。如果无法判断数学题的正确性,可以请教相关专家或通过权威平台核实。不要盲目相信未经验证的答案。
令人担忧的是,我提到的那两个视频号主播的视频转发量竟已超过10万+。虽然他们的初衷可能是好的,但实际上却误导了孩子们。希望大家在发布信息时保持严谨,对分享的内容负责,共同维护健康、真实的网络环境。
更值得警惕的是,大模型通过微调可以“记住答案”,但稍作修改就可能出错,说明它并未真正掌握知识。因此,大家在使用时更要擦亮眼睛,系统学习,勤于思考,多向老师或领域专家请教
在当前大模型尚不成熟的情况下,
孩子们仍应以请教老师为主,尤其在理科方面。
即便大模型给出了正确答案,其讲解过程也可能存在错误,
孩子们难以分辨
。现阶段,更需要专业教师的引导,优化教学方法,帮助孩子们正确认识AI,拥抱变化,积极创新。
公众号:收获不止数据库
微信:ljbyxl1213
系列回顾
目前,通用大模型在高考数学方面表现仍处 “学渣” 水平。不仅 如此, 在物理、化学、生物等科目上成绩也难以及格。不过,其在语文、英语、历史等科目中表现相对不错,准确率可达80%。
2. 模型与 个人能力强相关的认知当下, 善用AI的人 优势将进一步 扩大 ,个人 能力水平越高 ,向AI提出的 提问越有智慧 ,就越能从AI那里获得高质量的回复( 专家介入 )。而且,对AI大模型运行原理了解得越深入( GPU算力,外部访问... ) ,你就越清楚如何让它更顺畅地运行,发挥出更好的效果 (详见链接 《 AI大揭秘 》 ) 。
3. 对 大模型与专用AI差异的认知虽说专用AI和大模型都采用了深度神经网络技术,但是两者架构差异很大。目前专用AI在垂直领域的能力 远超 通用大模型( “奥数拿金奖” vs “数学不及格”,“碾压顶尖棋力” vs “围棋业余5级”,“诺贝尔奖” vs “略懂皮毛 ”... )。不过,未来大模型必定能一统江湖之时, 其实,这和 关系型数据库能开始融合各个专用数据库场景 ,走向超融合(一体化),是一个道理。到那时, 就是通用人工智能时代到来之际 (详见链接: 《 穿越者 》 , 《 未来已来 》 )。
倡议
(从我做起)
在未来的网络环境中,虚假和错误的观点可能会愈发泛滥。一方面,部分博主为追逐热点, 盲目传播未经证实的信息 ;另一方面,大模型本身也可能 给出诸多错误回复 。因此,我们必须保持 持质疑精神 ,不轻易 接受 和 传播 未经核实的内容 。只有通过 亲自动手确认 、 多AI交叉验证 及查找 第一手信息源 ( 详见链接 :《 乱象 》) ,才能有效避免被误导。
或许不久后,大模型就能达到高考数学满分的能力,但即使如此,大家也应自行验证其对错。如果无法判断数学题的正确性,可以请教相关专家或通过权威平台核实。不要盲目相信未经验证的答案。
令人担忧的是,我提到的那两个视频号主播的视频转发量竟已超过10万+。虽然他们的初衷可能是好的,但实际上却误导了孩子们。希望大家在发布信息时保持严谨,对分享的内容负责,共同维护健康、真实的网络环境。
更值得警惕的是,大模型通过微调可以“记住答案”,但稍作修改就可能出错,说明它并未真正掌握知识。因此,大家在使用时更要擦亮眼睛,系统学习,勤于思考,多向老师或领域专家请教
在当前大模型尚不成熟的情况下, 孩子们仍应以请教老师为主,尤其在理科方面。 即便大模型给出了正确答案,其讲解过程也可能存在错误, 孩子们难以分辨 。现阶段,更需要专业教师的引导,优化教学方法,帮助孩子们正确认识AI,拥抱变化,积极创新。
公众号:收获不止数据库
微信:ljbyxl1213
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/9091385/viewspace-3079013/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 2030年,两个智能体的深夜回忆:幸亏那年,人类重构了数据库
- 万物一理:从人体进化到IT架构的取舍之道——写在2026中国系统架构师大会之前
- 达梦9发布会归来:AI 时代,我们需要一款什么样的数据库?
- 当AI强到连“造物主”都感到恐惧,我们该怎么办?
- 当AI反噬宏观经济:一场关于个体自救与中国制度托底的万字推演
- 原来“先吃菜”和“后建索引”是同一个逻辑?揭秘那些万物相通的“执行顺序”
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(下)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(中)
- 应用程序大模型化之路——从12306畅想看预设模式颠覆与数据觉醒(上)
- 技术人生——第13集:溯本清源,手起刀落
