之前学习了xtrabackup的完全备份流程和恢复流程,今天继续学习xtrabackup的增量备份原理,先来简单熟悉下流程吧。
根据自己的理解,我将xtrabackup增量备份的整体流程归纳成了以下八个阶段,如下图:
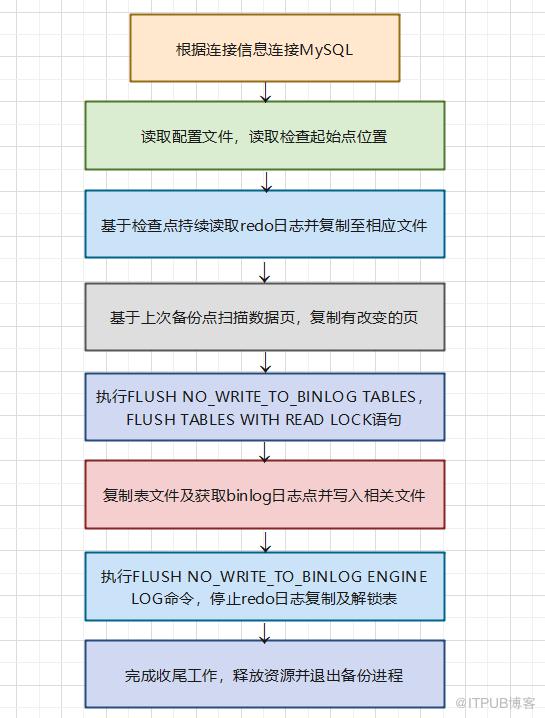
与完全备份一样,连接MySQL,用于在后期备份过程中与数据库进行交互。
第二步:读取配置文件,读取检查起始点位置
通过读取配置文件,找到redo日志文件的位置,读取redo日志,读取上次备份的to_lsn信息作为增量备份起始点。
第三步:基于检查点持续读取redo日志并复制至相应文件创建xtrabackup_logfile,检查当前checkpoingt点,持续模拟mysql instance方式读取redo log,复制到xtrabackup文件中。
LSN(log sequence number)日志序列号,占用8字节,LSN是一个一致递增的整形数字,表示事务写入到日志的字节总量。LSN存在于重做日志和数据页头部以及checkpoint中,在MySQL中,每个InnoDB页面都会包含一个LSN号,当相关的数据发生变化时,相关页面的LSN号便会自动增加,这为InnoDB表提供增量备份提供了基础,xtrabackup会将LSN信息记录到xtrabackup_checkpoints或xtrabackup_info等文件中,包含from_lsn,to_lsn,last_lsn等信息,from_lsn表示备份数据开始的LSN号,在增量备份中,该LSN号与上次备份的to_lsn相等,to_lsn表示备份数据结束的LSN号,last_lsn表示备份结束时复制的检查点位置。在选择哪些数据页需要复制时,遵循以下原则,当LSN大于上一次备份的to_lsn数据页,则需要进行复制。用流程图表示出来,差不多就是这样子的: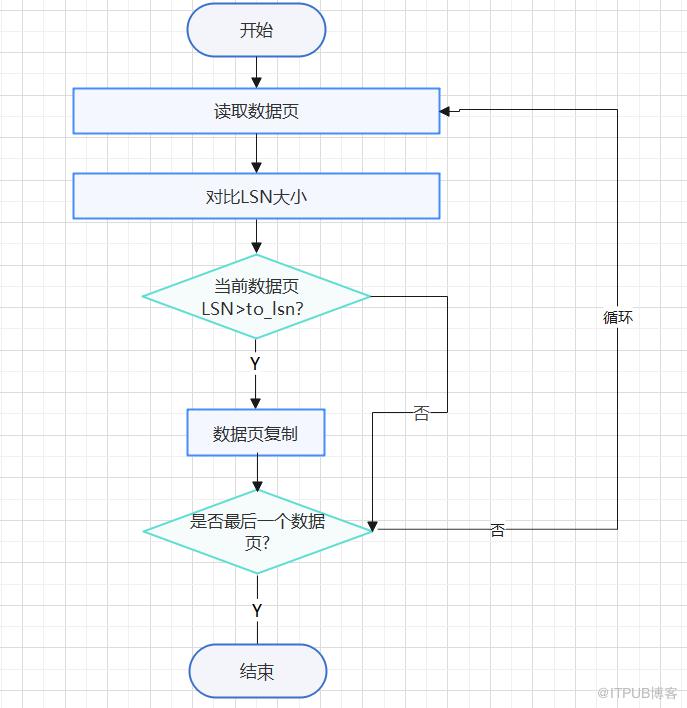
第五步:执行FLUSH NO_WRITE_TO_BINLOG TABLES,FLUSH TABLES WITH READ LOCK语句执行FLUSH NO_WRITE_TO_BINLOG TABLES后会关闭所有打开的表,强制关闭所有正在使用的表,并刷新查询缓存和预准备语句缓存。还会从查询缓存中删除查询结果。默认情况下flush语句会写入binlog,这里使用no_write_to_binlog禁止记录。执行FLUSH TABLES WITH READ LOCK后会关闭所有被打开的表,并且使用全局锁锁住所有库的所有表,锁住之后只能进行select操作,不能做其他操作)。在备份或者需要数据库的一致状态时,这个是最高效的方式。
第六步:复制表文件及获取binlog日志点并写入相关文件复制非Innodb引擎表的.MYD,.MYI,.opt等文件,InnoDB引擎表的.frm, .opt等文件,执行show master status获取binlog的pos点,写入到xtrabackup_binlog_info文件。
第七步:执行FLUSH NO_WRITE_TO_BINLOG ENGINE LOG命令,停止redo日志复制及解锁表执行FLUSH NO_WRITE_TO_BINLOG ENGINE LOG将redo日志持久化到磁盘,即执行刷新redo log buffer中的日志到磁盘中,复制最后的redo日志,然后执行UNLOCK TABLES释放全局读锁。
完成备份了,就可以执行恢复了,增量恢复可分为以下三个步骤:
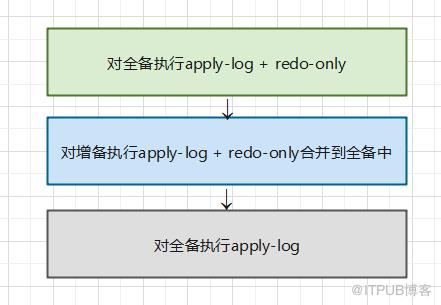
第一步:对全备执行apply-log + redo-only:1).进入指定的备份目录,查看备份文件是否已经执行过apply-log [prepare]如果已经执行过apply-log,则xtrabackup_checkpoint文件中的backup_type字段值为full-prepare
如果已经执行过apply-log + redo-only,则该字段值为log-applyed
2).在备份目录下读取xtrabackup_logfile文件,识别文件大小和起始lsn号。3).读取配置参数,启动最小化的innoDB实例,为恢复过程做准备。4).从起始lsn号往后扫描需要恢复的redo log。5).执行apply-log的过程,可以看作非正常情况关闭数据库之后重启数据库的过程,会对备份数据文件执行崩溃恢复的动作。6).应用完redo log后,会执行一次正常关闭mini innodb instance操作,使用innodb_fast_shutdown=1的方式。
第二步:对增备执行apply-log + redo-only合并到全备中:1).进入指定备份目录,读取增量目录中的xtrabackup_checkpoints文件中的form_lsn字段的lsn号。2).查看全备目录是否已经执行过apply-log + redo-only,即查看xtrabackup_checkpoints文件中backup-type字段是否为log-appled.3).在备份目录下读取xtrabackup_logfile文件,识别文件大小和起始lsn号。4).读取配置参数,获取数据文件信息,从增量备份目录下扫描所有备份的表空间文件,ibdata1.delta,ibd.delta文件,并将其应用到全备的对应表空间数据文件中。5).从起始lsn号往后扫描需要恢复的redo log。6).启动最小化的innoDB实例,执行apply-log的过程,可以看作非正常情况关闭数据库之后重启数据库的过程,会对备份数据文件执行崩溃恢复的动作。7).应用完redo log后,会执行一次正常关闭mini innodb instance操作,使用innodb_fast_shutdown=1的方式。8).从增量备份目录中复制.opt,.frm等非innodb引擎的相关数据和表定义等文件到全备目录下。
第三步:对全备执行apply-log:与全备流程一致,但是此时需要将未提交的事务进行回滚。
为什么在执行UNLOCK TABLES之前需要执行FLUSH NO_WRITE_TO_BINLOG ENGINE LOGS?总体来说,该命令是为了保证数据的一致性,在执行FLUSH TABLES WITH READ LOCK语句后,新的数据变更将被阻塞,binlog日志点之前的所有产生的redo日志都会落盘,在xtrabackup备份中,innobackup不备份binlog,在备份时如果要判断事务是前滚还是回滚,只能通过事务在redo日志中是否有commit标记来判断,如果redo日志中被打上了commit标志,则binlog一定已经落盘了,考虑备份数据恢复与备份源的一致性,只有一种情形可能会导致不一致,即binlog在主库中已经落盘,但是redo日志的commit标记还是在日志缓冲区中,这会导致innobackupex备份时丢失最后一个事务的commit标记,在做备份恢复时这个事务会被回滚,而源实例中这个事务binlog已经落盘,即使数据库实例挂掉,崩溃恢复时也会重新提交,因此这回导致备份恢复与源实例数据不一致,执行FLUSH NO_WRITE_TO_BINLOG ENGINE LOGS则可以解决这个问题,该命令可以保证获取的pos位置所有事物的redo日志都被刷新到磁盘上。好了,今天还有事,先到这吧,xtrabackup备份这一块东西比较多,下次再一起学习吧。
原文作者:DBA修行之路;如有侵权,请联系管理员删除。

