1.Full GC对HBase的影响:
在HBase中,如果设置内存过小,会很容易导致写阻塞,而默认的内存才为1G,因此实际生产中需要适当调大HBase的内存值。但是随着内存的加大,会导致JVM的堆内存越大,Full GC的时间也会越久,有时候会达到好几分钟,在Full GC期间,JVM会停止响应任何的请求,整个JVM的世界就像是停止了一样,这种暂停被称为Stop-The-World(STW)。 在HBase集群中,Zookeeper通过定时发送心跳来检测RegionServer节点是否存活,如果某个节点Full GC时间过长,无法及时回应Zookeeper,会被Zookeeper标记为宕机,当该节点完成Full GC后,发现自己被Zookeeper标记为宕机,为了防止脑裂问题的发送,会自己停止自己,即进行自杀,也称为朱丽叶暂停。这个问题比较常见,解决思路为设定好GC回收策略或者减小Full GC的时间。
2.JVM的GC类型:
并行回收器(PafallelGC),针对年轻代进行优化,是JDK8的默认策略。 并发回收器(ConMarkSweepGC,简称CMS),针对老年代进行优化。
3.GC算法的组合规则:
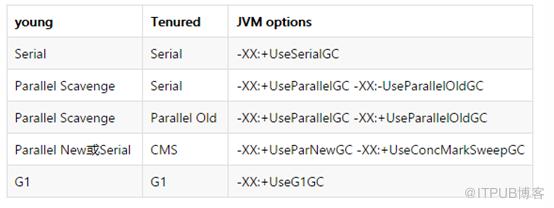
4.HBase常用回收算法:
目前HBase常见使用的是ParallelGC和CMS的组合方案。 并行回收器的性能较串行回收器而言稍差,但是Full GC时间更短,而Regionserver对Full GC时间较敏感,在牺牲一些性能的情况下,优先选择并行回收器。 并发回收器主要是减少老年代的暂停时间,可以保证在应用不停止的情况下进行垃圾回收,但是每次进行收集时会留下一些浮动垃圾,这些浮动垃圾只能下次垃圾回收时进行回收。 年老代使用并发回收器ConcMarkSweepGC。 export HBASE_MASTER_OPTS="$HBASE_MASTER_OPTS $HBASE_JMX_BASE -Xmx4000m -Xms4000m -Xmn1500m -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:CMSInitiatingOccupancyFraction=70 -XX:+CMSParallelRemarkEnabled -XX:+UseCMSInitiatingOccupancyOnly -XX:-DisableExplicitGC"
-XX:CMSInitiatingOccupancyFraction:该值用来设定CMS在对内存占用率达到多少时开始GC。 -XX:UseCMSInitiatingOccupancyOnly:只是用设定的回收阈值,如果不指定,JVM仅仅在第一次使用设定值,后续自己动态调整。
一般而言,CMSInitiatingOccupancyFractionFraction参数与UseCMSInitiatingOccupancyOnly参数配合使用,用来降低CMS GC的频率或增加频率,减少GC时间,对于UseCMSInitiatingOccupancyOnly参数,建议在对应用程序产生的对象的生命周期有深刻认知时候才开启,因为大多数情况JVM做出的决策更好。
5.其他相关参数:
-XX:ConcGCThreads:设置CMS线程的数量。 -XX:+DisableExplicitGC:设置该参数后,代码中手动调用System.gc()就不会生效。 -XX:+CMSParallelRemarkEnabled:并行运行最终标记阶段,加快最终标记的速度。 -XX:+UseCMSCompactAtFullCollection:每次触发CMS Full GC的时候整理一次碎片 -XX:+CMSFullGCsBeforeCompaction=* :经过几次CMS Full GC时整理一次碎片
6.CMS发生Full GC的几种原因及优化方法:
在以下两种情况下,CMS会失败,触发Full GC。 1).并发模式失败日志(concurrent mode failure) 当CMS工作时,有一些对象需要从年轻代移动到老年代,但是此时老年代空间不足,只能触发Full GC。 可以从两个方面进行优化,一方面给后台线程更多的运行机会,即更早的启动并发收集周期,通过设置 -XX:CMSInitiatingOccupancyFraction和-XX:UseCMSInitiatingOccupancyOnly参数实现。另一方面可以运行更多的线程,并发模式失败是因为CMS的速度低于对象晋升到老年代的速度,因此可通过给CMS更多的线程来加快CMS速度。可以通过-XX:ConGCThreads值来设置,默认情况下值为ConcGCThreads=(3+ParallelGCThreads)/4,ParallelGCThreads的值可以通过-XX:ParallelGCThreads参数设置,但是并不是设置线程越多越好,CMS在运行时会完整占用一颗CPU,当CPU资源较紧张时,需谨慎设置该值。
2).晋升失败(promoration failure) 老年代有足够的空间,但是被回收掉的内存空间太碎,导致新加入老年代的对象放不进去,从而导致Full GC。 可以从减少碎片化方向来思考问题的解决方案,CMS提供了以下两个参数来对碎片进行整理和压缩,-XX:+UseCMSCompactAtFullCollection和-XX:+CMSFullGCsBeforeCompaction=* 参数,但是对碎片进行压缩整理也是一个比较耗时的操作,需要谨慎设置。
7.G1GC算法的策略及应用场景:
G1GC策略将堆内存划分为多个Region,然后对每个Region单独进行GC,整体的Full GC可以被最大限度的进行避免。同时,可以通过手动指定MaxGCPauseMillis参数来控制一旦发生Full GC的时候的最大暂停时间,避免时间过长造成RegionServer自杀。 G1GC算法一般应用于堆内存较大的情况,一般建议是大于32GB以上。 export HBASE_REGIONSERVER_OPTS="$HBASE_REGIONSERVER_OPTS -Xms32g -Xmx32g -XX:+UseG1GC -XX:+PrintGCDetails -XX:+PrintGCTimeStamps -XX:+PrintAdaptiveSizePolicy"
8.HBase的GC算法选择建议:
如果Regionserver内存小于4GB,不考虑G1GC策略,使用-XX:+UserParNewGC -XX:+UseConcMarkSweepGC。 如果RegionServer内存介于4GB~32GB之间,根据实际测试结果设置。 如果RegionServer内存大于32GB,建议使用G1GC策略。
另外,经过Justin Kestelyn的文章Tuning Java Garbage Collectt for HBase中经过测试验证的优化参数,可设置: 32GB heap时, 设置 -XX:G1NewSizePercent=3。 64GB heap时, 设置 -XX:G1NewSizePercent=2。 100GB或者更大时, 设置 -XX:G1NewSizePercent=1。
9.HBase的MSLAB机制:
HBase自身实现了一套以Memstore为最小单位的内存管理机制,称为MSLAB(Memstore-Local Allication Buffers)。
引入chunk概念,chunk本质上是一块内存,大小默认为2MB,RegionServer中维护一个全局的MemStoreChunkPool实例,本质上是一个chunk池,每个MemStore实例里面有一个MemStoreLAB实例,当MemStore接收到KeyValue数据的时候会先从ChunkPool中申请一个chunk,然后将数据放到该chunk里面,如果该chunk满了,就重新再新申请一个。如果MemStore因为刷写而释放内存,按照chunk来清空内存。
优点:消除了小碎片无法插入数据的问题,不会发生Full GC 缺点:降低了内存使用率,因为即使chunk里只放1KB的数据,该chunk也会占用2MB的大小。
hbase.hregion.memstore.mslab.enabled:设置为true即打开,默认为true。 hbase.hregion.memstore.mslab.chunksize:大小默认为2MB。
hbase.hregion.memstore.chunkpool.maxsize:能放入chunk的最大单元格大小,默认为256KB。
hbase.hregion.memstore.chunkpool.maxsize:在整个memstore中可以占用的堆内存中chunkPool占用的比例,默认为0.0。
hbase.hregion.memstore.chunkpool.initialsize:RegionServer启动时预分配的chunk占总的chunkPool的比例,默认为0.0。
备注:HBase的PMC成员做过相关测试,G1GC和MSLAB同时使用时性能能略有提升。
原文作者:DBA修行之路;如有侵权,请联系管理员删除。

