


YARN,全称Yet Another Resource Negotiator,中文名为另一种资源协调者,是一种新的Hadoop资源管理器,自Hadoop2.0时代引入,解决了Hadoop1.0时代MapReduce在线扩展性和多框架支持等方面的不足,取消了原来的Map Slots和Reducer Slots的概念,并将TobTracker的功能一分为二,全局资源管理ResourceManager(RM)和管理每个应用程序的ApplicationMaster(AM),用ResourceManager来管理节点资源,负责所有应用程序的资源分配,用ApplicationMaster来监控与调度作业,从而诞生了一个全新的通用的资源管理框架YARN。


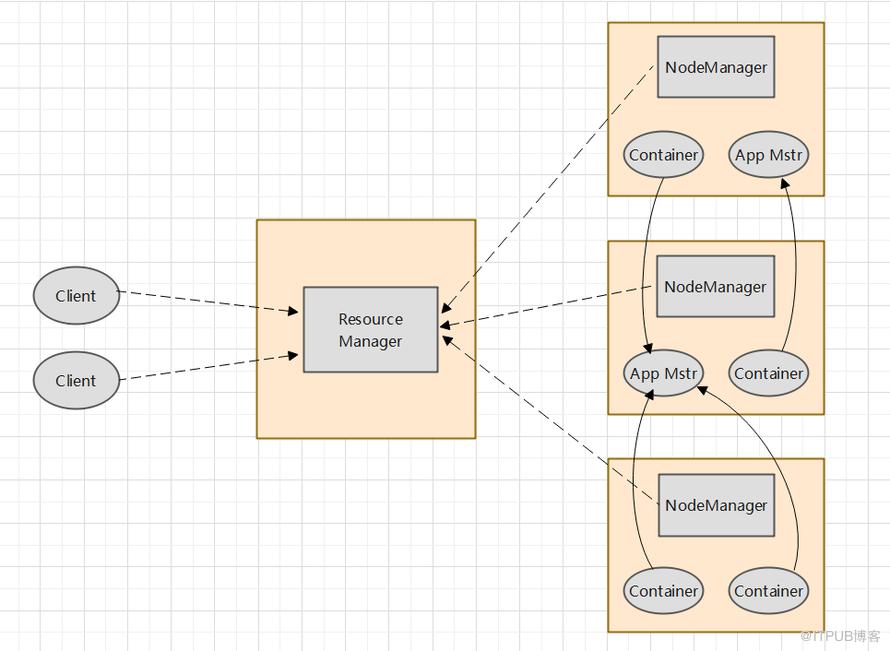
YARN上含有以下几个重要的组件:
ResourceManager:简称为RM,负责管理所有应用程序计算资源的分配,是一个全局的资源管理系统,定期接收来自NodeManager关于本机的资源使用情况。ResourceManager只负责集群整体的资源管理,各个节点的具体资源的处理由节点上的NodeManager自己实现,生产环境上通常为高可用模式,即设置主备节点,主节点状态为Active,备节点状态为Standby。当主节点发生异常时,会实现切换,从节点会自动升级为主节点。
NodeManager:简称为NM,管理所在机器的代理,负责本机程序运行,资源管理和监控,集群中每个NM节点上的NM服务会定时向RM汇报本节点的资源使用情况和Container运行情况,如果判断主RM通信失败,NM会立即连接备用的RM处理作用任务。
ApplicationMaster:简称为AM,每当提交一个应用程序便会产生一个用以跟踪和管理该程序的AM,该AM负责向ResourceManager申请资源,由AMLancher与对应NodeManager联系并启动常驻在NodeManager中的AM,该AM将获得资源的容器Container,一个任务对应一个Container,用于任务的运行,监控,如果任务运行失败,系统将会重新为其申请资源和启动任务。
基础架构如下:


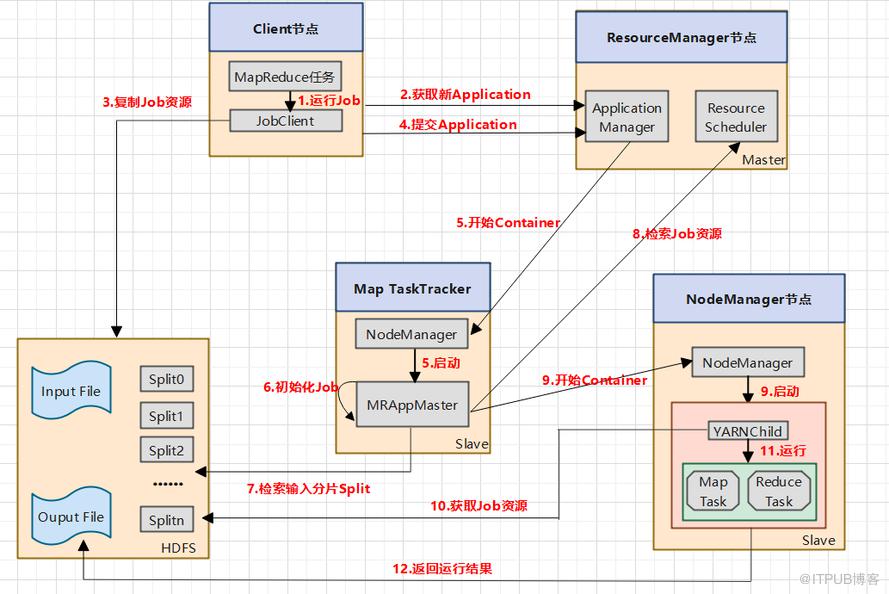
YARN上作业的提交流程整体如下:
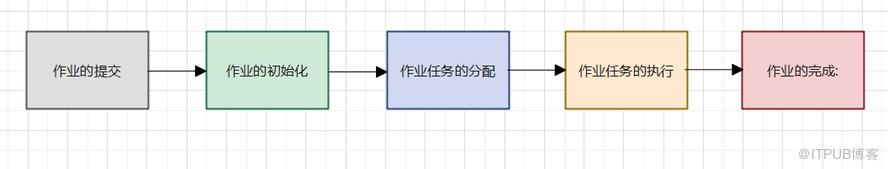
作业提交流程按照阶段可细分为以下五个阶段:
详细的过程如下:
作业的提交
在第1步至第2步,用户提交的MapReduce程序启动一个JobClient实例,开启整个MapReduce作业(Job),JobClient会向RM发出请求以获得一个新的作业ID,用于标识该MapReduce作业,JobClient会检查作业指定的输入数据和输出目录等信息是否正确,同时还还计算作业的分片信息,如果有错,将会将报错信息返回给MapReduce程序。
第3步,检查无误后,将作业的资源,如本次作业相关的配置文件,输入数据分片的数量,以及包含Mapper和Reducer类的jar文件等,复制到HDFS上。
第4步,完成上述准备工作后,JobClient通过调用RM上的SubmitApplication()方法,发出作业提交的请求。
作业的初始化:
第5步,RM收到submitApplication()消息后,将请求传递给调度器(Scheduler),调度器会分配一个容器(Container),在NM在的ContainerManager组件触发MLauncherEventType.LAUNCH事件,并被RM中的ApplicationMasterLauncher捕获,创建新的AMLauncher实例,通过该实例调用AMLauncher.launch()方法,在其内部调用ContainerManager.startContainer()方法启动该Container,进一步在Container中启动应用程序的master进程。
第6步,MRAppMaster是MapReduce作业中AM的主类,由它对作业进行初始化,它接受来自任务的进度和完成报告,通过创建多个簿记对象以保持对作业进度的跟踪,便于后续跟踪任务状态和执行进度。
第7步,接收来自共享文件系统(例如HDFS)在客户端计算的输入分片的信息,根据分片数量确定创建Map任务的数量,一般一个分片对应一个Map,Reduce数量可以通过mapreduce.reduces参数控制。
作业任务的分配:
第8步,如果作业不是Uber任务运行模式,则AM会向RM请求,为该作业中所有的Map任务和Reduce任务请求Container,YARN的调度器(Scheduler)根据请求中的每个Map任务的数据本地化信息进行调度决策,确定任务分配模式,理想情况下,任务分配到数据本地化的节点,否则相较于非本地化的分配优先先使用机架本地化的分配,并为任务分配内存,可以通过mapreduce.map.memory.mb和mapreduce.reduce.memory.mb参数控制,可根据应用程序请求最小到最大限制范围的任意最小值倍数的内存容量。
作业任务的执行:
第9步,RM调度器为任务分配Container后,AM通过与NM定时通信来启动Container。
第10步,Container启动后,会进行准备工作,例如从共享文件系统(例如HDFS)把作业的jar文件复制到本地,以及应用程序需要的全部文件复制到本地,并未任务新建一个本地工作目录等。然后主类的YARNChild的Java应用程序执行任务。
第11步,运行Map任务和Reduce任务。
作业的完成:
第12步,客户端经过一段时间后向AM检查任务执行进度,同时通过调用Job的waitForCompletion()方法检查作业是否完成,作业完成后,AM和任务容器会清理工作状态,作业历史服务器保存作业的信息供用户查看使用。

在某些情况下,运行在Hadoop集群上的一些作业本身的数据量不大,但是任务分片很多,那么为每个map任务或者reduce任务频繁创建Container,将会增加Hadoop集群的资源消耗,因为创建分配Container本身会进行资源消耗,另外还会增加任务的运行延时,Uber运行模式解决了这种问题。
Uber运行模式对小作业进行优化,不会给每个任务单独申请分配Container资源,这些小任务将统一在一个Container中按照限制性map任务再执行reduce任务的顺序串行执行。
mapreduce框架对小任务的定义:
map任务的数量不大于mapreduce.job.ubertask.maxmaps参数,默认为9。
reduce任务的数量不大于mapreduce.job.ubertask.maxreduces参数,默认为1。
输入文件大小不大于mapreduce.job.ubertask.maxbytes,默认为1个Block的字节大小。
map任务和reduce任务需要的资源数不能大于MRAppMaster可用的资源总量。
uber运行模式的开启通过mapreduce.job.ubertask.enable参数控制,默认为false。


YARN中,作业初始化时需要创建Container(容器),作业完成后需要杀死Container,而Containr实际上的一个动态运行的JVM进程,这个过程有些耗费系统资源,可以通过实现容器重用提升Job执行效率,容器在一个作业完成后不会被Kill,而是自动去获取新的任务,避免了容器重新分配及初始化动作,大大减少了容器启动与回收时间。通过优化,可以大大提升集群计算性能,华为的FusionInsight就对YARN进行了容器重用特性改造。

YARN是一个通用资源管理系统,可为上层应用提供统一的资源管理和调度,为集群在利用率,资源统一管理和数据共享等方面带来了巨大便利。目前,大数据生态圈很多组件都支持On Yarn模式,例如,hive,spark,flink等。今天总结的仅仅是YARN的基础架构与运行原理,关于YARN的性能优化等知识点,还需要后期继续学习。

END


原文作者:DBA修行之路;如有侵权,请联系管理员删除。

