



在HBase中,之前已经学习了HBase的写流程,相较HBase的写流程,HBase的读流程更加复杂。需要对数据进行删选过滤。先来整体看下读数据流程吧。可分为四个阶段:Client与Server交互阶段,Server端构建Scan框架体系阶段,过滤HFile阶段,通过HFile读取KeyValue阶段。


HBase读取过程中的Client端与Server端交互流程之前已经学习过,在这里再简单回顾下,Client先从zookeeper中获取元数据hbase:meta表所在的RegionServer。然后发送请求到相应的RegionServer,获取对应的RegionServer和Region信息缓存到本地,最后将请求发送到目标RegionServer进行处理。
这里需要了解的几个点如下:
1).HBase数据读取可分为get与scan两类,实际上,get请求也可看作一种最简单的scan请求。
2).Client端与Server端的scan操作根据数据量的大小会被拆分为一个或多个RPC请求,每个RPC请求称为一次next请求,这样做不仅可防止影响集群中其他业务,还可避免OOM(OutOfMemory,内存溢出)。
3).HBase客户端可以通过caching参数限制单次RPC请求的数据条数,通过setBatch方法设置单次RPC请求的数据列数量,通过setMaxResultSize方法设置单次RPC请求返回的数据量大小(占用空间大小)。


一次Scan可能会同时扫描一张表的多个Region,客户端会根据扫描区间切分查询子区间,这些查询子区间相互独立,每个子区间对应一个Region。
Scanner核心体系包含三层Scanner:RegionScanner,StoreScanner,MemStoreScanner和StoreFileScanner。
一个RegionScanner包含多个StoreScanner,StoreScanner的个数由表的列簇数组成。StoreScanner负责对应Store的数据查找。一个StoreScanner由一个MemStoreScanner和多个StoreFileScanner构成。StoreScanner会为当前Store中每个HFile构造一个StoreFileScanner。用于对应HFile文件的检索。会为MemStore构造一个MemStoreScanner,用于MemStore的数据检索。
Scan的三层架构如下:
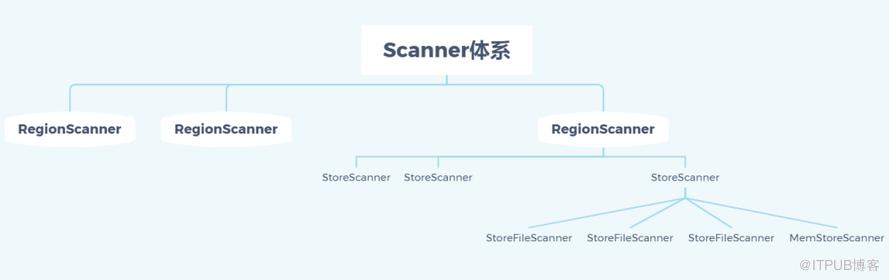
在Scan的三层架构中,RegionServer和StoreScanner不负责实际的查找操作,而是承担组织调度任务,负责KeyValue查找操作的实际是StoreFileScanner,MemStoreScanner。

Scan体系构建完成后,会根据过滤策略淘汰部分不满足查询条件的Scanner。因为并不是每个HFile都包含用户想要查找的KeyValue。过滤策略有Time Range过滤,Rowkey Range过滤和布隆过滤器等。过滤流程如下:
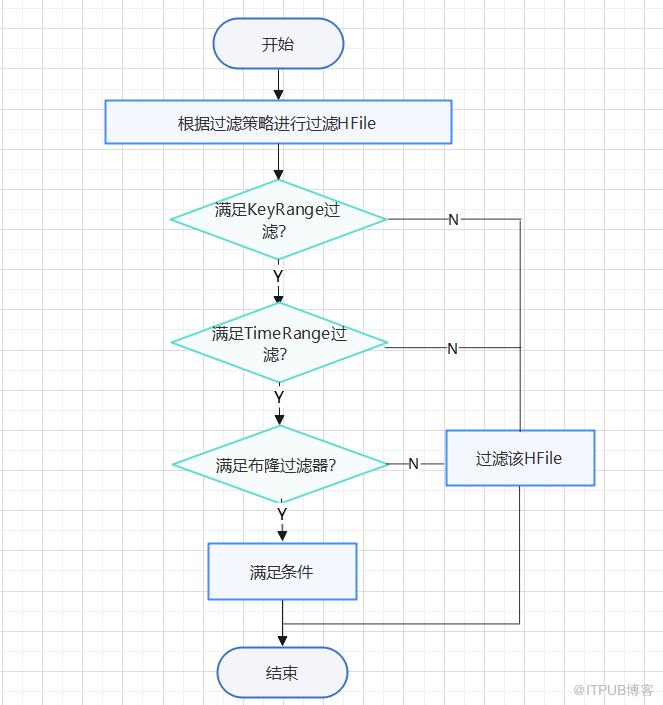
RowRange过滤:StoreFile中所有KeyValue是有序排列的,如果待检索row范围的起始行与结束行和文件起始key与结束key没有交集,则过滤掉该StoreFile。
TimeRange过滤:StoreFile中元数据中含有一个TimeRange属性,范围为miniTimestamp~maxTimestamp,如果待检索的TimeRange和文件时间范围没有交集,则可以过滤该StoreFile。
布隆过滤器:系统根据待检索的rowkey获取对应的Bloom Block并加载到内存中,再使用hash函数对待检索rowkey进行hash,根据hash后的结果在布隆过滤器数据中进行寻址,即可确定待检索rowkey是否存在于该HFile,从而决定是否过滤。


经过筛选后,每个Scanner会在每个HFile文件或MemStore文件中从起始点startKey进行seek操作,如果HFile或HFile中没有找到startKey,则seek下一个KeyValue地址。具体过程可分为四个阶段:
1).根据HFile索引树定位目标Block,HRegionServer打开HFile时会将所有HFile的Trailer部分和Load-on-open部分加载到内存,Load-on-open部分包含一个非常重要的Block,Root Index Block,索引的根节点。Root Index Block包含多个Index Entry。Index Entry表示具体的索引对象,由三个字段组成,Block Offset,表示索引指向Data Block的偏移量,BlockDataSize,表示索引指向Data Block在磁盘上的大小,BlockKey表示索引指向Data Block中的第一个Key。进行查找时,通过二分查找可以快速定位到对应的KeyValue。
2).BlockCache检索目标Block。Block缓存到BlockCache后会构建一个Map,Map的Key为BlockKey。Value为Block在内存中的地址。BlockKey由HFile名称和Block在HFile中的偏移量两部分构成,因此是全局唯一的,根据BlockKey可以获取某个Block在BlockCache中的内存位置,然后加载该Block对象。不过不存在,则需去HDFS文件中查找。
3).通过文件索引中的Block Offset和Block DataSize两个元素,可以在HDFS上读取到对应的Data Block内容。在此过程中,HBase会在加载HFile的时候为每个HFile新建一个从HDFS读取数据的输入流FSDataInputStream,后续所有的对该HFile的读取操作都会使用这个文件级别的InputStream来操作。
4).通过遍历扫描Block查找KeyValue(不知道现在有没有更高查找效率的方法了吧,知道这部分的同学可以告诉我下哈)。
HFile文件实际存储在HDFS上,因此读取HFile时HBase需要与HDFS交互。HBase读取HFile文件涉及到四个组件:HBase,NameNode,DataNode,磁盘。流程如下:
1).HBase加载HFile的时候为每个HFile新建一个从HDFS读取数据的输入流,FSDataInputStream,之后对该HFile的读取操作都会使用这个文件级别的InputStream进行操作。
2).使用FSDataInputStream读取HFile中的数据块,命令下发到HDFS,会先联系NameNode组件,NameNode会找到这个HFile的所有HDFS Block列表,确认待查找数据所在的HDFS Block,定位后,会确认这些HDFS Block块在哪些DataNode上,选择一个最优的DataNode返回给客户端。
3).NameNode告知HBase待查找的HFile所在的DataNode,然后,HBase会与对应DataNode交互,DataNode会找到指定HDFS Block块,seek到指定偏移量,从磁盘中读取指定大小的数据返回。

HBase中,写操作包含插入,更新,删除操作,其实更新,删除本质上也是通过插入实现的。更新操作并没有更新原有数据,而是通过时间戳属性实现多版本,删除操作也只是插入了一条标记为"deleted"标签的数据,真正的删除发生在Major Compact时期。
但是在HBase中读操作需要对数据版本,已经标记删除的数据等数据进行过滤,最终筛选出需要的数据,这中间的流程更加复杂。

随着HBase数据的写入,磁盘上的数据文件会越来越多,这对写入没有影响,但是对读操作会产生影响,当用户有读请求时,需要将大量的磁盘文件进行多路归并,然后才能读取到需要的数据。磁盘文件数量越多,产生的随机读取的次数也会更多,从而对读性能产生影响。因此需要设置一定的策略对选择HFile文件进行合并,合并为一个文件。从而减少seek操作的次数,提升读取性能。这便是compact操作。根据选择的文件个数,可以将compact操作分为minor compact和major compact。
minor compact:选中少数HFile,将其归并为一个文件。该方式优点是可以进行局部的compact,占用IO较少,适合较高频率进行。缺点是只合并了局部数据,无法彻底清除delete操作,只能提升一部分读取性能。
major compact:将所有的HFile一次性归并为一个文件。该方式优点是合并后只有一个文件,读取性能最高。缺点是花费时间较长,占用IO较大,不适宜使用频繁,可定期执行。

HDFS的Block大小为128M,而HBase的Block为64K,我们知道,HBase的文件一般最终是存储在HDFS上的。为什么不设置Block大小一致呢?其实可以从HDFS和HBase本身找答案。HDFS主要是用来存储大文件的,当数据量达到一定量时,如果Block过小,会导致需要保留的Block元数据信息过多,HDFS元数据都存储在NameNode上,大量的元数据会对NameNode造成很大压力,从而产生性能瓶颈。HBase中,缓存会存储整个Block,如果Block设置太大,会导致缓存空间很快被消耗完,对于随机读业务,这会导致缓存效率低下。

继之前的HBase写流程,HBase的读流程也熟悉了一遍,已经对HBase的整体运行情况有了初步的了解。后面就是对细节和单个知识点的详细学习了,写学习总结一个月了,中间也有几天因为偷懒或有事没写,没完全按照自己的目标走,但也算坚持下来了。回头看看,收获还是挺大的,后面继续保持,加油。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

