


Messaging system,消息引擎系统,用于在不同应用间传输消息。具有以下优点:
1).实现了生产者消费者之间的解耦。
2).可以任意系统进行集成。
3).可实现异步消息传输。
消息引擎系统,生产者,消费者共同构成了消息引擎架构,如下:
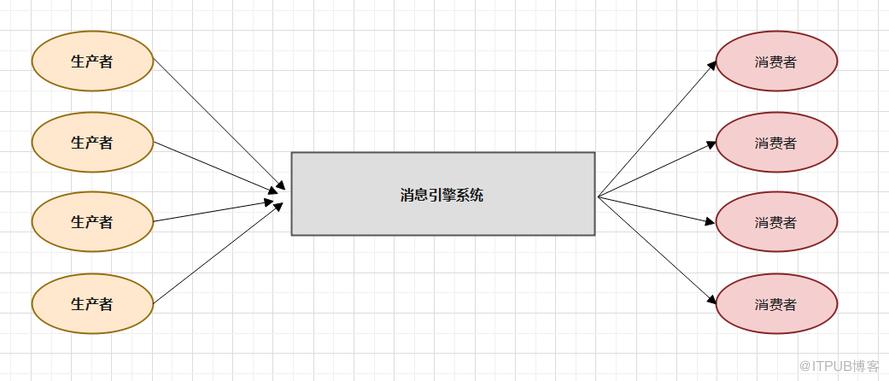
消息引擎系统需要考虑以下几点:
1).消息设计,消息应该能能够完整清楚表达业务。
2).消息传输协议,指定消息在不同系统间传输的方式。
3).消息引擎范型。


传输协议相当于一个基础构建块,最终服务于消息引擎系统实现的消息引擎范型。最常见的两种消息引擎范型为消息队列模型和发布/订阅模型。
消息队列模型:基于队列提供消息传输服务,一般用于进程间通信(IPC)及线程间通信。该模型含有消息队列(queue),发送者(sender),接收者(receiver)。提供的是一种点对点(p2p)的消息传递方式,发送者和消费者之间是一对一的关系,每条消息由一个发送者生产出来只会被一个消费者消费,消费完就会被从队列中移除,类似于生活中的电话接线生处理机制,一个打进来的电话只会被一个接线生处理。
发布/订阅模型:该模型含有发布者(publisher)和订阅者(subscriber),主题(topic)。发布者可以将消息发送给指定的topic,然后订阅了该Topic的订阅者都能够接收到该topic下的所有消息。类似于生活中的报纸订阅。


为了实现超大量的数据的实时传输。Kafka设计时在以下四个方面进行了优化:
1).吞吐量/延时
吞吐量是指某种处理能力的最大值,对于kafka而言,指的是每秒能够处理的消息数或者每秒能够处理的字节数。延时是指发出某个操作与接收到操作响应之间的时间或者在系统中导致某些物理变更的起始时刻与变更正式生效之间的间隔。对于kaka而言,延时指的是客户端发起请求与服务器处理请求并发送响应给客户端之间的时间。一般而言,吞吐量和延时是一对矛盾体,kafka通过一系列优化策略,实现了高吞吐量和低延时。
2)消息持久化
kafka通过将消息持久化到磁盘上,一方面实现了消息发送和消息消费之间的解耦,使得生产者不需要直接和消费者耦合,只需要简单地将消息生产出来交给kakfa服务器即可。另一方面便于消息重演。
3).负载均衡和故障转移
负载均衡指的是通过配置某种规则使得系统的负载均衡地分配在所有参与工作的服务器上。从而提升系统整体运行效率。默认情况下,kafka通过leader选举算法,实现了集群中的每台服务器都有均等的机会为Kafka的客户提供服务,从而将负载分散到所有集群中的机器上,避免单台服务器负载过大而导致资源耗尽。
故障转移指的是集群中当某台服务器发生异常中止后,整个集群可以快速检测到,并立即将该服务器上的应用或服务自动转移到其他服务器上。kakfa通过会话机制实现故障转移,集群中的每台服务器会在启动时以会话形式注册信息到ZooKeeper信息。
4).伸缩性
分布式系统中由于很多单点瓶颈会制约线性扩容的计算资源。kafka通过将集群服务器的状态交由zooKeeper管理集群状态一致性,极大降低了维护复杂度。另外,kafka服务器自身也会保存轻量级的内部状态。提高了计算资源的利用率。


kafka集群架构如下,整体分为生产者,消费者,kafka服务器,ZooKeeper服务器四个部分。他们之间的关系及交互流程如下:

生产者发送消息给Kafka服务器,然后消费者从Kafka服务器读取消息,同时,集群内的所有Kafka服务器依赖ZooKeeper进行服务协调管理。
kafka适合处理生产环境中的流式数据。可以使用于以下场景。
1).超大量的消息传输。
2).网站的行为日志追踪,通过消息形式将网站的用户操作发送到kafka上。
3).审计数据收集,用于对重要系统中关键的操作和运维进行监控和审计。
4).日志收集,通过kafka收集不同服务器上的全量日志,集中发送到下游的分布式存储中。相比flume,性能更好,延时更低。
5).流式处理,从0.10.0.0版本推出。
6).Event Sourcing,不太清楚。

kafka通过以下几点实现了高吞吐,低延时。
1).大量实现操作系统也缓存,内存操作速度快,命中率高。
2).kafka不直接参与物理I/O操作,而是交由操作系统完成。
3).使用追加写入方式,实现了顺序写,抛弃了磁盘随机读/写操作。
4).使用以sendfile为代表的零拷贝技术加强数据传输效率。

一般系统持久化时会优先使用内存,当内存资源不足时再一次性进行数据刷盘,kafka没有采用这种方法,在kafka中,所有数据会立即被写入到文件系统的持久化日志后,然后kafka服务器才会返回结果给客户端,这种方法一方面实时保存了数据,另一方面减少了kafka对内存的消耗,可以将更多内存留给页缓存。

简单来说,零拷贝是一种避免CPU将数据从一块存储拷贝到另外一块存储的技术,通过利用各种零拷贝技术,避免让CPU做大量简单的数据拷贝任务,让CPU专注于更复杂的任务,让系统资源利用更有效,可以有效地改善数据传输的性能。
传统linux操作系统的标准I/O接口基于数据拷贝操作实现,I/O操作会导致数据在操作系统内核地址空间的缓冲区和应用程序地址空间定义的缓冲区之间进行传输。可以减少I/O传输,但会导致CPU开销较大。
零拷贝技术主要是为了实现避免数据拷贝,避免操作系统内核缓冲区之间进行数据拷贝,避免操作系统内核和用户应用程序地址空间之间进行数据拷贝操作。用户应用程序可以越过操作系统直接访问硬件存储,数据传输尽量交由DMA(Direct Memory Access,直接存储器访问技术)进行。从而避免不必要的系统调用和上下文切换。
Linux平台的sendfile系统调用便是零拷贝技术的应用。

最近工作中涉及到Kafka组件的相关操作,还是好久之前简单的学习过一些,到现在也忘记了。说明学过的东西还是要定期温习的。借着这个契机,打算花费一周的时间对kafka系统的学习下,今天对消息引擎系统的整体结构及kafka的一些设计理念学习了一波,接下来会先了解下kafka的整体结构和运行机制。有感兴趣的可以一起学习哈。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

