



学习kafka的过程中,producer和consumer是必须要了解的两个部分,先来学习producer吧,producer是向kafka中写入数据的应用程序,要想成功的实现消息写入,并在遇到瓶颈时知道如何优化,需要知道以下这些:
1).如何构造一个producer?
2).需要向哪个topic,哪个分区写入消息?
3).消息如何进行转换?
4).如何避免消息丢失?
5).如何提高传输效率?
6).如何定制化控制消息?
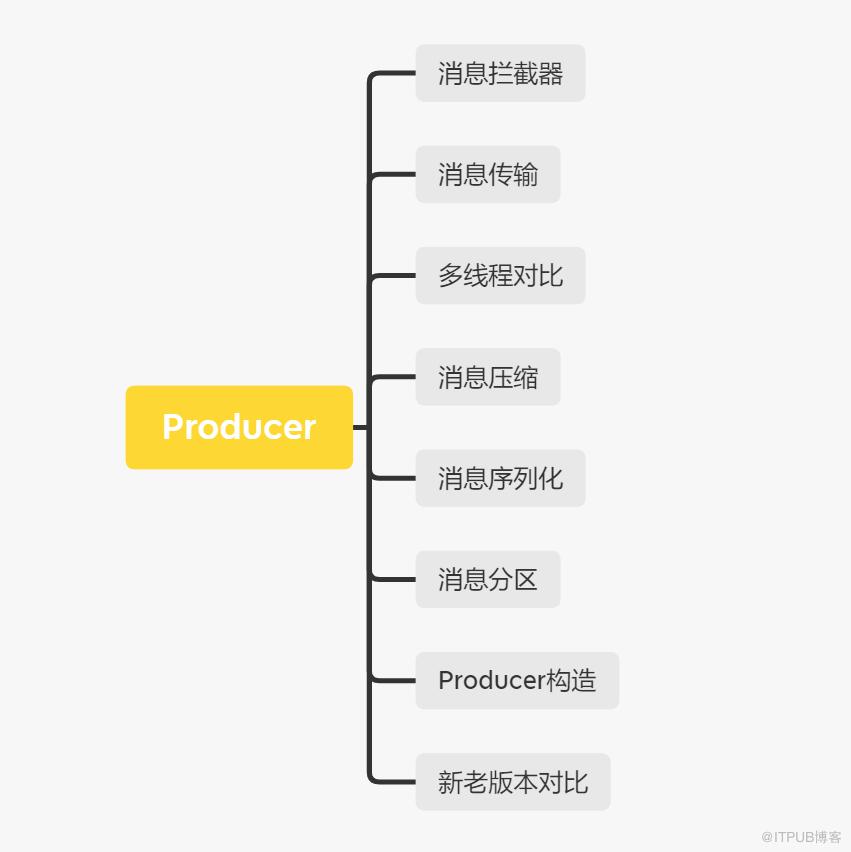
带着这些问题,能更有效,更系统地进行producer的学习,针对这些问题,从八个方面对producer进行学习总结。


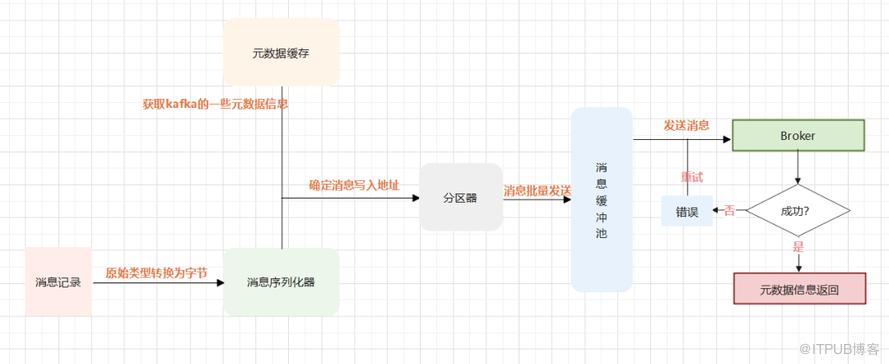
Kafka的Producer端的整体流程如下:
1).用户将发送的消息封装进一个ProducerRecord实例。
2).Kafka使用序列化器将ProducerRecord实例进行序列化。
3).序列化的消息被发送到分区器,确定要发送的目标分区。
4).发送消息至producer的内存缓冲区。
5).从缓冲区提取消息封装成一个批次(batch)。
6).消息按批次发送给broker。
7).发送成功则返回消息元数据信息,反之则进行重试发送,超过重试次数后失败。
流程如下:


构造Producer分为以下几个步骤:
1).构造一个java.util.Properties对象,必须要指定bootstrap.servers, key.serializer, value.serializer三个基本属性,bootstrap.servers参数指定kafka broker服务器的连接信息,key.serializer参数用于为消息的key做序列化,value.serializer参数用于为消息的value做序列化,其他的根据实际需要进行设置。
2).使用Properties实例构造KafkaProducer对象。
3).构造待发送的消息对象ProducerRecord,指定消息要被发送到的topic,分区及对应的key与value。分区与key信息如果不指定,kafka会自动分配。
4).调用KafkaProducer的send方法发送消息,发送方式有三种,同步,异步,fire and forget,生产上常用的为前两种。
5).关闭KafkaProducer。Producer程序结束后一定要关注producer,不关闭会浪费资源,因为producer运行时创建额外线程,申请内存,Socket连接都会占用资源。关闭producer有无参数和带超时参数的两种close方法。生产上一般不建议使用带有超时参数的close方法。

Kafka提供了分区策略和对应的分区器给用户使用,另外,kafka还支持自定义分区机制。
在kafka默认分区器(partitioner)中,分区器会尽量确保具有相同key的所有消息被发送到相同的分区上,在新版本中,如果没有指定key,分区器会采用轮询方式确保消息在topic的所有分区上均匀分配。
自定义分区机制需要新建实现org.apache.kafka.clients.producer.Partitioner接口的类,主要是实现Partitioner.partition方法,并在KafkaProducer的Properties对象中设置partitioner.class参数。


网络中数据都是以字节的形式发送的,Kafka支持用户给broker发送各种类型消息,因此,内部需要实现各种对象类型的消息到字节数组的转换,序列器负责在Producer发送前将消息转换为字节数组。kafka提供了一些常用数据类型的序列化器,也支持自定义序列化器。
默认序列化器:
ByteArraySerializer:无需操作,本身已经是字节数组。
ByteBufferSerializer:序列化ByteBuffer。
DoubleSerializer:序列化Kafka自定义的Bytes类。
DoubleSerializer:序列化Double类型。
IntegerSerializer:序列化Integer类型。
LongSerializer:序列化Long类型。
StringSerializer:序列化String类型。
producer针对简单的消息类型有相应的序列化机制,但是如果涉及复杂的类型,则需要自定义serializer。
自定义serializer需要实现自定义数据对象格式,创建自定义序列化类,实现org.apache.kafka.common.serialization.Serializer接口中的serizlizer方法,并在KafkaProducer的Properties对象中设置key.serializer或者value.serializer。

kafka的ProducerRecord中支持指定消息的时间戳,但是为什么不建议指定时间戳呢,因为在kafka中,时间戳索引文件中的索引项严格按照时间戳顺序排列,如果随意指定时间戳,可能导致该消息时间序列混乱,导致在根据时间戳查询位移时无法找到该消息,或影响消息留存策略。

kafka中,关闭producer程序时调用closer方法有两种选择,一种是调用无参数的普通close方法,另外一种是调用带超时参数的close方法。为什么建议后者呢?原因如下:
调用无参数的close方法时,producer允许先处理完之前的发送请求再关闭,即优雅地关闭。
调用带超时参数的close方法时,producer会等待timeout时间来完成还未处理完的请求,如果在timeout时间内还没处理完,会立即丢弃所有未发送及未应答的发送请求,强制退出,会给用户带来丢数据的不良错觉。

acks参数是用于控制producer生产消息的持久性,当消息写入broker后,producer会在一定时间内等待消息的写入结果以确定消息是否被成功提交,然后才能进行新的消息的发送。acks指定了在给producer发送响应前leader broker需要保证已经成功写入该消息的副本数,acks有三个值。0,1,-1(all)。
acks=0:该情景下producer发送消息后无需等待返回写入结果即可发送下一条消息。优点是吞吐量最高,但是不保证消息成功发送。
acks=-1:该情景下producer发送消息时,不仅需要等待leader broker将消息写入本地日志,还需要等待消息成功写入ISR中所有其他副本后才能发送响应结果给producer。优点是消息持久性最高,只要ISR中有一个副本处于存活状态,消息就不会丢失。缺点是吞吐量最低。
acks=1:该情景是前两者的折中,producer发送消息后,只需leader broker成功将消息写入本地日志后即可发送响应结果给producer,只要该leader broker一直存活,就可保证消息不丢失,兼顾了消息持久性和吞吐量两者。
生产中,可根据实际业务需求选择不同的值。

该篇中,学习总结了producer端的整体架构,producer的构造,分区器的相关知识点,以及序列化器的一些内容,对producer有一个初步的认知,还有拦截器,消息压缩及安全,多线程等内容下篇再进行总结。学习是枯燥难熬的,如果有热爱学习的小伙伴,可以一起学习探讨哈,毕竟一个人有时会懈怠,一起学可以互相监督,交流,早日脱离小白,哈哈。台风天都在家干啥呢?

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

