



aof和rdb虽然能够实现数据数据尽量少丢失,但是在实例恢复期间还是无法服务新的请求,这总是有点美中不足的,与大部分数据库的做法一样,redis通过增加副本机制来实现高可用,即将一份数据同时保存在多个实例上,即使单个实例出现故障,也不影响整体的使用。更具体来说,即主从库模式,redis采用的是读写分离的方式。只在主库上进行写操作,但是主库和从库都可以进行读操作。


redis首次主从同步总体可以分为三个阶段:
1.建立连接阶段。
2.同步数据阶段。
3.发生新命令阶段。
流程图如下:
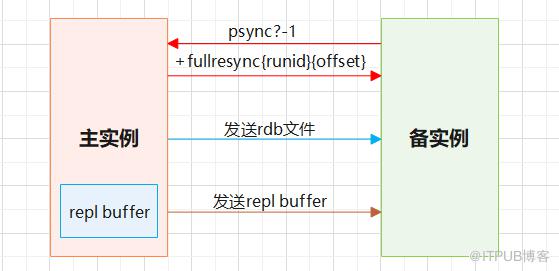
第一阶段:从实例执行slaveof(5.0之后使用replicaof) 主实例ip 端口命令即可形成主库和从库的关系。然后从库给主库发送psync命令,表示需要进行数据同步,该命令中含有两个参数:
runID:用来唯一标识一个实例,在redis实例启动时自动生成,当从库和主库首次复制时是不知道主库的runID,因此将runID设置为"?"。
offset:第一次从库和主库进行复制时该值设置为-1。
收到从库的请求后,主库会进行响应,第一次复制时主库会回复fullresync响应给从库,表示使用全量复制,即主库会将当前所有的数据都复制给从库。
第二阶段:主库会通过执行bgsave命令生成rdb文件,该rdb文件中包含当前主库的所有数据,然后主库会将rdb文件发送给从库,从库收到数据后,会先情况自身当前的数据库,然后加载rdb,恢复数据。
第三阶段:在主库将数据同步给从库的过程中,主库的写操作会被记录在内存中的replication buffer区域,当主库完成rdb文件的发送后,会将replication buffer中的修改操作发送给从库,然后从库再来执行这些操作,以此实现主从同步。


主从同步中最常见的问题就是网络断连或阻塞。在redis2.8之前,主从库出现网络中断后只能重新进行全量复制,开销很大,在redis开始,支持网络断连后主从库采用增量复制的方式继续同步。主从库断连后,主库会将断连期间收到的所有写操作记录到replication buffer,同时还会写入repl_backlog_buffer环形缓冲区。环形区如下:
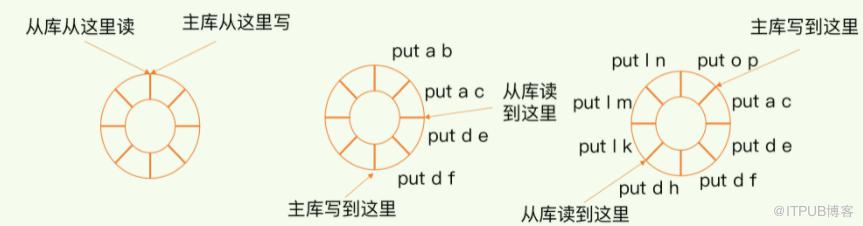
环形缓冲区中,主库通过master_repl_offset记录当前的最新写操作在repl_backlog_buffer中的位置,从库用slave_repl_offset值记录当前的复制进度。主从同步最初时,主库的写位置和从库的读位置是重合的,然后随着主库不断写操作,主库的位置向前推进,在此过程中,从库也会不断读主库的写操作进行自身的数据同步,然后读的位置向前推进,当主从同步无异常时,主库的写位置和从库的读位置基本位置距离相差不大。但是因为缓冲区是个环形结构,如果主库的写操作比较多或者从库读取速度比较慢,可能会导致主库之前的写操作还没被从库读取就被被新的操作覆盖了,因此导致主从数据不一致。这个可以通过两个方面解决。一方面增大redis服务器的repl_backlog_size值,另外一方面可以使用集群来减轻单库请求压力。


简单来说,哨兵就是一个运行在特殊模式下的redis进程。主要负责redis主从模式下的监控,选主,通知事项。
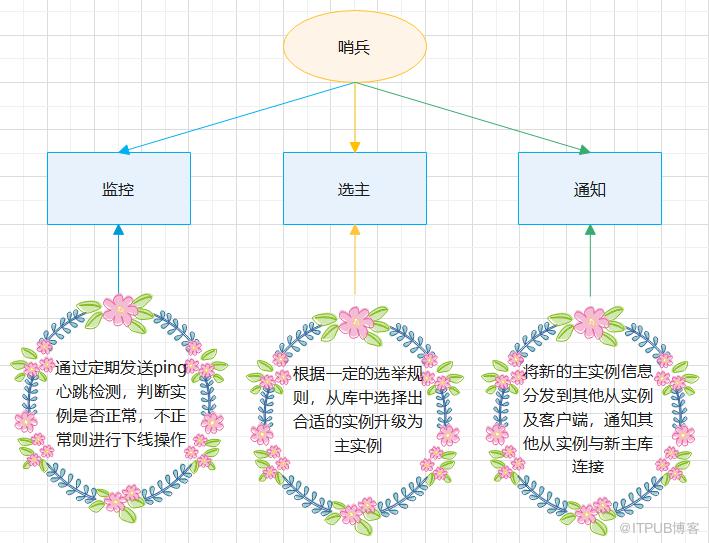
在此过程中,关注以下几点:
1.是否标记下线,主从库的待遇不一样,对于从库,检测响应超时,简单标记为主观下线即可,因为对外影响不大。对于主库,如果因为误判而标记为下线,则后续需要进行主从切换,选主,通知等一系列计算和通信开销。因此哨兵机制通常使用多实例组成的集群模式进行部署,遵循少数服从多数原则,这个原则是不是很熟悉啊,只有超过半数的实例判断主库下线,最终才能判定主库客观下线,当然,多少实例做出下线判断也可以由管理员设定。
2.选主过程,分为筛选,打分两个阶段,筛选阶段,选择出正常在线且网络连接状态良好的从库。打分阶段,先后按照从库优先级,从库复制进度,从库ID号一轮一轮进行打分,从库优先级越高得分越高,从库同步离旧主库越近得分越高,从库ID号越小得分越高。只要在某一轮中得分最高,就为主库,选主结束,否则继续下一轮。
3.选择新的主库之后,哨兵会将新主库的信息通知给其他的从库。然后从库和新主库建立连接并进行数据复制。

不可置疑的是redis很快,但随着数据量的增大,会导致一系列问题,如下:
1.因为rdb持久化时,fork操作用时与redisd的数据量正相关,而fork时会阻塞主线程,数据量越大会导致阻塞时间越长。,这可能会导致redis响应变慢。
2.数据量越大,发生宕机后,崩溃恢复时间越长。
解决上述问题,可以通过两种方法解决:
横向扩展,增加当前实例的个数。相比纵向扩展更复杂,但是无须考虑单个实例的硬件和成本限制。对大数据量友好。这种方法更值得推荐。
纵向扩展,升级单个实例的规格配置,包括CPU,磁盘,内存等方面。这种防范实施简单,但随着数据量增加可能会发生阻塞问题。另外,会受到硬件和成本的限制。
redis3.0开始提供了cluster方案,redis cluster采用哈希槽(hash slot)来处理数据和实例之间的映射关系,一个集群共有16384个哈希槽,这些槽位类似于数据分区,每个键值对会根据自身的key被映射到一个哈希槽中。redis会根据键值对的key采用CRC16算法计算一个16bit的值,然后用这个16bit值对16384取模。通过哈希槽,redis实现了数据到哈希槽,哈希槽到实例的分配,然后客户端定位数据时,计算出哈希槽后,然后还需要知道哈希槽分布在哪个实例上。客户端如何知道这个呢?
客户端和集群实例建立连接后,实例会将哈希槽的分配信息发送给客户端,然后会将哈希槽信息缓存在本地,当客户端请求键值对时,通过哈希槽就可以知道给哪个实例发送请求了。
redis中,主从库之间第一次数据同步时,生成RDB文件和传输RDB文件都是比较耗时的过程,如果从库数量较多且都需要和主库进行全量复制的话,会导致主库忙于fork子线程生成RDB文件,这会阻塞主线程,影响主线程处理正常请求。另外,传输RDB文件会占用主库的网络带宽。因此,可以通过"主-从-从"级联的方式将主库生成RDB和传输RDB的压力分散到从库上,可以手动选择一个内存较高的从库用于级联其他的从库。但是感觉这种遇到主库异常时切换较麻烦。
repl_backlog_size参数与缓冲空间大小有关,计算方式是:缓冲空间大小=主库写入速度*操作命令大小-主从库间网络传输命令速度*操作命令大小,但是考虑到突发情况,一般设置repl_backlog_size的值为缓冲空间的两倍。默认为1M,有个笑话是如果面试时一个公司说自己业务体量大但是这个参数用的是默认值,就不要去了。
redis持久化有RDB和AOF两种,AOF记录的操作命令更全,可以保证丢失更少的数据,为啥主从同步不使用AOF而使用RDB呢,主要有两个方面:
1.RDB文件是经过压缩的二进制数据,文件较小,而AOF文件记录的是每一次写操作的命令,写操作越多文件越大,进行传输时更耗时。
2.从库在利用持久化文件进行恢复时,RDB文件比AOF执行更快。

本篇学习了下redis的主从同步,哨兵机制,主从同步异常等知识点,虽然学习进度有点慢,有收获就是值得高兴的,慢慢来,比较快,加油吧,小伙伴们。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

