



今天的学习内容是redis的数据倾斜问题,之前学习过,在redis集群中,在集群创建时一般会以slot为单位均匀地将16384个slot分配到集群实例上,然后当客户端向服务端写入某个key时,会通过CRC算法计算出一个16bit的值,然后用这个值对16384取模,得到的模数对应的即是slot的编号,key最终便会被存储到该slot所在的实例。理想情况下,各个slot中的key分布均匀,但是某些情况下,可能会出现数据倾斜问题。
数据倾斜可以细分为数据量倾斜和数据访问倾斜,前者指的是集群中实例分布不均匀,一个或少量实例上的数据远超其他实例。后者指每个集群实例数据量相差不大,但是一个或少量实例上的数据为热点数据,访问频繁。
但是无论是数据量倾斜还是数据访问倾斜,都会导致一个或少量实例的处理压力增大,性能变差,严重的可能造成内存耗尽从而崩溃,最终对业务造成影响。这就好比牙疼虽然不是病,但是疼起来也是要人命的。所以,还是得知道如何治理。如下是数据 倾斜的可能原因,后面对每个点进行逐个击破。
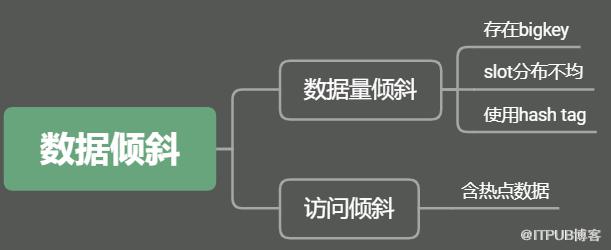
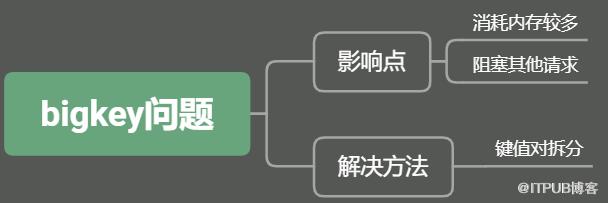
bigkey问题指的是某个实例上保存的key的value值很大,可能是string类型或者是集合类型,可以从两方面来了解bigkey问题,bigkey的影响,bigkey的解决方法。
bigkey的影响有两方面。一方面,bigkey会导致实例的数据量增加,从而导致内存资源消耗增加,严重的可能会导致实例奔溃。另一方面,我们知道,redis6.0之前是单线程的,而bigkey的操作一般会造成实例IO线程阻塞,如果bigkey的访问频率较高,可能会影响其他的请求处理。
对于bigkey问题,根本性的解决方法是在业务侧进行数据处理时,尽可能地避免将过多的数据保存在同一个键值对中,可以考虑将一条数据拆分为多条数据存储在不同的键值对中,然后在业务侧进行拼接。

slot分配不均问题并非是直接影响数据倾斜的,这里还是从slot分配不均导致数据倾斜的原因,影响,和解决办法来总结:
我们知道,同一个Slot只会存在于一个实例上,如果在集群创建时操作人员未均匀分布slot,有的节点上分配的slot多,有的节点上分配的slot少,可能就会导致分配slot个数较多的节点上数据较多,造成数据倾斜,使得该节点压力较大,严重时造成服务崩溃。
slot分配不均导致数据倾斜的影响有两个方面:一方面可能造成单个节点压力过大,严重时服务崩溃对业务造成影响。另一方面,会造成资源的不合理浪费,对于slot较多的节点会内存等资源使用紧张,而其他节点的资源使用率可能很低。涝的涝死,旱的旱死。
slot分配不均导致数据倾斜问题可以通过事前预防和事后补救两种方法解决,事前预防,在资源申请时尽可能保证每个节点配置相同,均匀分配slot到每个节点。事后挽救,当由于slot分配不均导致数据倾斜后,可通过cluster slots命令查看slot分配情况,使用migrate命令迁移slot个数较多的节点上的部分slot到slot个数较少的节点上。


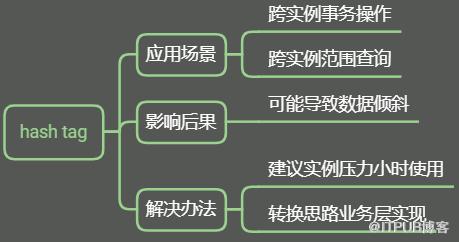
hash tag指的是加在键值对key中的一对花括号{},假设某个场景,需要将相同城市的人员信息存储在相同的redis实例中,便可通过hash tag实现,例如某个key为user:city:{hangzhou},此时,客户端计算key的CRC16值时只会对hash tag 花括号中的key内容进行计算,而不是计算整个key的CRC16的值。只要hash tag花括号中的key内容一致,计算出的CRC16值相同,对应的数据便会被映射到同一个slot中,同时被分配到同一个实例上。
好了,总结一下,hash tag的应用场景和缺陷。hash tag主要应用于redis集群的事务操作和范围查询。还以上面场景为例,因为如果对整个key进行CRC16值计算时,存储相同城市的人员信息的key可能会被分配到不同的实例,而redis集群本身不支持跨实例的事务操作和范围查询。当然,也可以通过逐个查询将所有数据读到业务层进行事务处理或范围查询。但是较麻烦。
虽然hash tag能轻松实现事务或范围查询,但是并非是完全perfect的,hash tag可能导致大量的数据被集中到一个实例上,还还以上面场景为例,毕竟不是每个城市的人口都是一样的,某些城市的人口量可能特别大,这就会导致数据倾斜了。最后,上图总结下吧:


如果数据倾斜导致redis奔溃,业务无法访问redis,请求会被发送到后端数据库。例如热点数据问题,此时会导致大量访问请求被发送到数据库,数据库压力骤增,严重时会导致数据库崩溃。
热点数据的根本原因是访问量大,前面说了可以在服务端进行多副本读或者提升规格解决,那么是否可以在请求端进行优化嘛,答案当然是确定的,可以在数据库接入层增加流量控制机制,一旦检测到大请求量,便开启限流,避免由于大流量造成数据库层奔溃。当然,这可能会影响用户的体验,实际生产中可根据实际需求进行选择最合适的处理方法。
我的答案是只能尽可能的优化,十全十美的方案没有,学习中,我们将数据倾斜原因划分为数据bigkey问题,slot分配问题,以及热点数据等等。但实际生产环境复杂,发生数据倾斜可能是一或多个现象的组合。需要经过详细的排查,测试,验证才有可能给出对应的解决方案。

本篇学习的内容是redis中数据倾斜的一些常见原因及解决方法,你学废了嘛,当然,这只是最基础的概念,实际生产中要远比这复杂的多,周末愉快。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

