这本书写得真的非常好,特别对于想学习人工智能的同学,可以说是一本通俗易懂的入门书,将晦涩难懂的算法和数学知识讲得浅显易懂,由浅入深,从本质到具体应用场景。
书中对我影响比较深的主要有以下几点:
从规则到统计
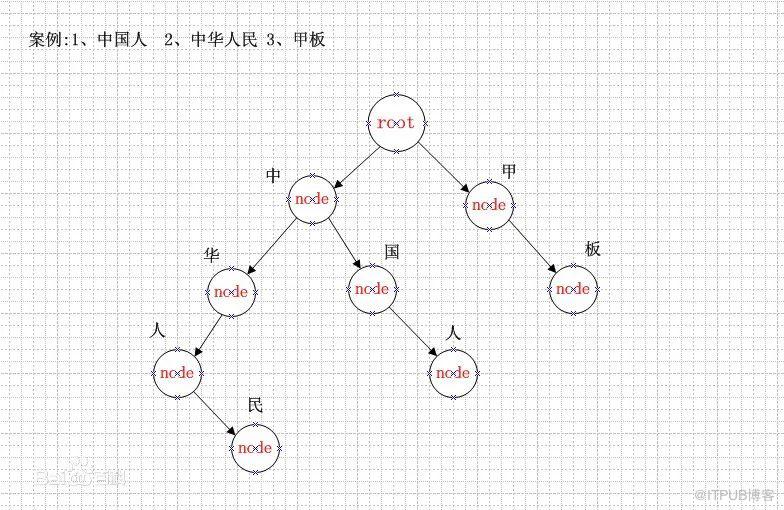
书中介绍了自然语言处理的发展,开始的采用基于规则的方法,虽然解决了一些简单的问题,但是无法从根本上将自然语言的理解实际化,直到20多年后,人们尝试基于统计的方案进行自然语言处理,才有了突破性进展和实用的产品。主要介绍了中文分词方法的演进。
奇异矩阵和向量的余弦的距离
奇异值分解能够较快的得到结果,它不需要一次次跌代,但是用这种方法得到的结果比较粗糙,因此,它适合处理超大规模文本的粗分类,在实际应用中,可以先进行奇异值分解,得到粗分类结果,再利用计算余弦向量的方法,在粗分类的基础上在迭代几次,得到比较精确的结果,这样两个方法一先一后结合使用,得到比较精确的结果,可以充分利用两者的优势,即节省时间,又能获得很好的准确性。
# 矩阵矢量化操作## 按行计算余弦相似度## 两矩阵计算相似度向量应为同维度## 返回值RES为A矩阵每行对B矩阵每行向量余弦值## RES[i,j] 表示A矩阵第i行向量与B矩阵第j行向量余弦相似度import numpy as npdef cosine_Matrix(_matrixA, _matrixB):import numpy_matrixA_matrixB = np.dot(_matrixA, _matrixB.transpose())## 按行求和,生成一个列向量## 即各行向量的模_matrixA_norm = numpy.sqrt(numpy.multiply(_matrixA,_matrixA).sum(axis=1))_matrixB_norm = numpy.sqrt(numpy.multiply(_matrixB,_matrixB).sum(axis=1))return numpy.divide(_matrixA_matrixB, _matrixA_norm * _matrixB_norm.transpose())### 向量计算余弦相似度## 计算两向量余弦相似度## 返回_vec1和_vec2余弦相似度## 此处用于计算向量余弦相似度,验证矩阵相似度计算结果def cosine(_vec1, _vec2):import numpy
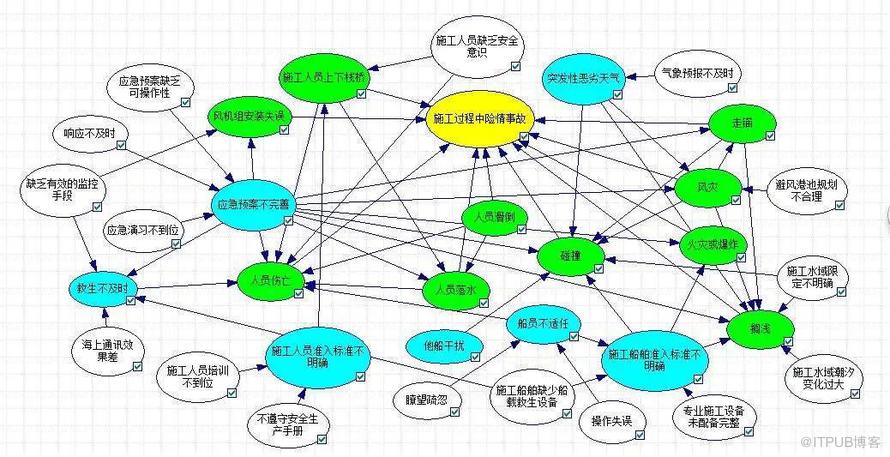
贝叶斯网络,人工神经网络
相同点
1.都属于有向图DAG,每个节点节点都取决于前一级的节点,而与更前面的节点无关,也就是说遵从马尔可夫假设。
2.他们的训练防范相似
3.他们的训练量特别大,需要由心理准备
不同点
1.人工神经网络在结构上时完全标准化的,而贝叶斯网络更灵活。
2.贝叶斯网络虽然灵活,但是也增加复杂性
3.贝叶斯网络更容易考虑上下文的前后相关性,因此可以解码一个输入的序列。而人工神经网络的输出相对孤立。很难处理一个序列。
最后,书中还介绍很多其他的知识,感兴趣的同学赶紧去看看,值得一看的好书。
原文作者:HBLOG;如有侵权,请联系管理员删除。

