1.什么是tika?
Tika是一个内容分析工具,自带全面的parser工具类,能解析基本所有常见格式的文件,得到文件的metadata,content等内容,返回格式化信息。总的来说可以作为一个通用的解析工具。特别对于搜索引擎的数据抓去和处理步骤有重要意义。Tika是Apache的Lucene项目下面的子项目,在lucene的应用中可以使用tika获取大批量文档中的内容来建立索引,非常方便,也很容易使用。Apache Tika toolkit可以自动检测各种文档(如word,ppt,xml,csv,ppt等)的类型并抽取文档的元数据和文本内容。Tika集成了现有的文档解析库,并提供统一的接口,使针对不同类型的文档进行解析变得更简单。Tika针对搜索引擎索引、内容分析、转化等非常有用。
Tika架构
应用程序员可以很容易地在他们的应用程序集成Tika。Tika提供了一个命令行界面和图形用户界面,使它比较人性化。在本章中,我们将讨论构成Tika架构的四个重要模块。下图显示了Tika的四个模块的体系结构:
语言检测机制。
MIME检测机制。
Parser接口。
Tika Facade 类.
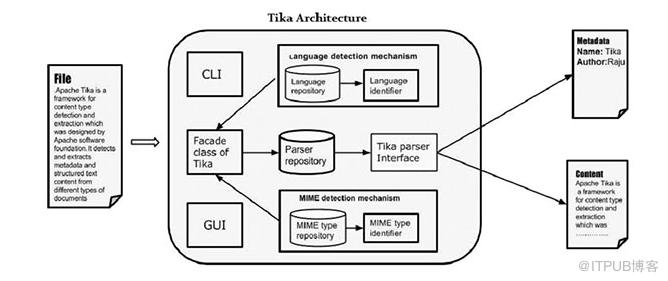
语言检测机制
每当一个文本文件被传递到Tika,它将检测在其中的语言。它接受没有语言的注释文件和通过检测该语言添加在该文件的元数据信息。支持语言识别,Tika 有一类叫做语言标识符在包org.apache.tika.language及语言识别资料库里面包含了语言检测从给定文本的算法。Tika 内部使用N-gram算法语言检测。
MIME检测机制
Tika可以根据MIME标准检测文档类型。Tika默认MIME类型检测是使用org.apache.tika.mime.mimeTypes。它使用org.apache.tika.detect.Detector 接口大部分内容类型检测。内部Tika使用多种技术,如文件匹配替换,内容类型提示,魔术字节,字符编码,以及其他一些技术。
解析器接口
org.apache.tika.parser 解析器接口是Tika解析文档的主要接口。该接口从提取文档中的文本和元数据,并总结了其对外部用户愿意写解析器插件。采用不同的具体解析器类,具体为各个文档类型,Tika 支持大量的文件格式。这些格式的具体类不同的文件格式提供支持,无论是通过直接实现逻辑分析器或使用外部解析器库。
Tika Facade 类
使用的Tika facade类是从Java调用Tika的最简单和直接的方式,而且也沿用了外观的设计模式。可以在 Tika API的org.apache.tika包Tika 找到外观facade类。通过实现基本用例,Tika作为facade的代理。它抽象了的Tika库的底层复杂性,例如MIME检测机制,解析器接口和语言检测机制,并提供给用户一个简单的接口来使用。
2.代码工程
实验目标
实现word文档转html
pom.xml
<project xmlns="http://maven.apache.org/POM/4.0.0"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"><parent><artifactId>springboot-demo</artifactId><groupId>com.et</groupId><version>1.0-SNAPSHOT</version></parent><modelVersion>4.0.0</modelVersion><artifactId>tika</artifactId><properties><maven.compiler.source>8</maven.compiler.source><maven.compiler.target>8</maven.compiler.target></properties><dependencies><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-web</artifactId></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-autoconfigure</artifactId></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-test</artifactId><scope>test</scope></dependency><dependency><groupId>org.apache.tika</groupId><artifactId>tika-parsers</artifactId><version>1.17</version></dependency><dependency><groupId>org.projectlombok</groupId><artifactId>lombok</artifactId></dependency></dependencies></project>
controller
package com.et.tika.controller;import com.et.tika.convertor.WordToHtmlConverter;import com.et.tika.dto.ConvertedDocumentDTO;import lombok.extern.slf4j.Slf4j;import org.springframework.beans.factory.annotation.Autowired;import org.springframework.web.bind.annotation.RequestMapping;import org.springframework.web.bind.annotation.RequestMethod;import org.springframework.web.bind.annotation.RequestParam;import org.springframework.web.bind.annotation.RestController;import org.springframework.web.multipart.MultipartFile;import java.util.HashMap;import java.util.Map;public class HelloWorldController {public Map<String, Object> showHelloWorld(){Map<String, Object> map = new HashMap<>();map.put("msg", "HelloWorld");return map;}WordToHtmlConverter converter;/*** Transforms the Word document into HTML document and returns the transformed document.** @return The content of the uploaded document as HTML.*/public ConvertedDocumentDTO convertWordDocumentIntoHtmlDocument( MultipartFile wordDocument) {log.info("Converting word document into HTML document");ConvertedDocumentDTO htmlDocument = converter.convertWordDocumentIntoHtml(wordDocument);log.info("Converted word document into HTML document.");log.trace("The created HTML markup looks as follows: {}", htmlDocument);return htmlDocument;}}
WordToHtmlConverter
package com.et.tika.convertor;import com.et.tika.dto.ConvertedDocumentDTO;import com.et.tika.exception.DocumentConversionException;import lombok.extern.slf4j.Slf4j;import org.apache.tika.exception.TikaException;import org.apache.tika.metadata.Metadata;import org.apache.tika.parser.ParseContext;import org.apache.tika.parser.Parser;import org.apache.tika.parser.microsoft.ooxml.OOXMLParser;import org.slf4j.Logger;import org.slf4j.LoggerFactory;import org.springframework.stereotype.Component;import org.springframework.web.multipart.MultipartFile;import org.xml.sax.SAXException;import javax.xml.transform.OutputKeys;import javax.xml.transform.TransformerException;import javax.xml.transform.sax.SAXTransformerFactory;import javax.xml.transform.sax.TransformerHandler;import javax.xml.transform.stream.StreamResult;import java.io.IOException;import java.io.InputStream;import java.io.StringWriter;/****/@Component@Slf4jpublic class WordToHtmlConverter {/*** Converts a .docx document into HTML markup. This code* is based on <a href="http://stackoverflow.com/a/9053258/313554">this StackOverflow</a> answer.** @param wordDocument The converted .docx document.* @return*/public ConvertedDocumentDTO convertWordDocumentIntoHtml(MultipartFile wordDocument) {log.info("Converting word document: {} into HTML", wordDocument.getOriginalFilename());try {InputStream input = wordDocument.getInputStream();Parser parser = new OOXMLParser();StringWriter sw = new StringWriter();SAXTransformerFactory factory = (SAXTransformerFactory)SAXTransformerFactory.newInstance();TransformerHandler handler = factory.newTransformerHandler();handler.getTransformer().setOutputProperty(OutputKeys.ENCODING, "utf-8");handler.getTransformer().setOutputProperty(OutputKeys.METHOD, "html");handler.getTransformer().setOutputProperty(OutputKeys.INDENT, "yes");handler.setResult(new StreamResult(sw));Metadata metadata = new Metadata();metadata.add(Metadata.CONTENT_TYPE, "text/html;charset=utf-8");parser.parse(input, handler, metadata, new ParseContext());return new ConvertedDocumentDTO(wordDocument.getOriginalFilename(), sw.toString());}catch (IOException | SAXException | TransformerException | TikaException ex) {log.error("Conversion failed because an exception was thrown", ex);throw new DocumentConversionException(ex.getMessage(), ex);}}}
dto
package com.et.tika.dto;import org.apache.commons.lang.builder.ToStringBuilder;/****/public class ConvertedDocumentDTO {private final String contentAsHtml;private final String filename;public ConvertedDocumentDTO(String filename, String contentAsHtml) {this.contentAsHtml = contentAsHtml;this.filename = filename;}public String getContentAsHtml() {return contentAsHtml;}public String getFilename() {return filename;}public String toString() {return new ToStringBuilder(this).append("filename", this.filename).append("contentAsHtml", this.contentAsHtml).toString();}}
自定义异常
package com.et.tika.exception;/****/public final class DocumentConversionException extends RuntimeException {public DocumentConversionException(String message, Exception ex) {super(message, ex);}}
以上只是一些关键代码,所有代码请参见下面代码仓库
代码仓库
https://github.com/Harries/springboot-demo
3.测试
启动Spring Boot应用
测试word转html

4.引用
https://tika.apache.org/
http://www.liuhaihua.cn/archives/710679.html
原文作者:HBLOG;如有侵权,请联系管理员删除。

